


在 Go 项目里,给切片排序往往就是一行 sort.Slice,看起来简单,但一旦排序字段存在大量“相等值”,结果就可能和直觉不一致:值相同的元素,排序后前后顺序竟然变了。这个问题不算冷门,尤其在成绩列表、提交记录、优先级队列这类业务数据中很容易踩坑。本文就从一个真实现象入手,拆开讲清楚 sort.Slice 为什么会这样、它和 sort.SliceStable 的差别是什么,以及你在实际代码里该怎么选。
先看这个常见坑:相等元素的顺序为什么变了
问题场景很典型:你有一组数据,按某个字段排序,排序前后这个字段相等的元素,看起来只要“分数没变、年龄没变”,相对顺序也应该不变。但实际结果未必如此。
比如排序之前,排序值相同的 张三 在 王五 前面:
{"张三", 85}, {"李四", 90}, {"王五", 85}, ...排序之后,分值同为 85 的元素却可能交换位置:
{"王五", 85}, {"张三", 85}, {"李四", 90}, ...如果你的代码后面还默认依赖这个先后关系,比如“先录入的排前面”“同分时保留原始顺序”,这类变化就会直接影响业务结果。
下面这个例子更完整,也更容易复现这个现象:
package main

import (
    "fmt"
    "sort"
)

func main() {
    // 创建长度大于12的切片,其中包含多个年龄相同的人员
    people := []struct {
        Name string
        Age  int
    }{
        {"Alice", 25}, {"Bob", 30}, {"Charlie", 25}, {"David", 35},
        {"Eva", 30}, {"Frank", 25}, {"Grace", 40}, {"Henry", 30},
        {"Ivy", 35}, {"Jack", 25}, {"Kate", 40}, {"Leo", 30},
        {"Mia", 35}, {"Nathan", 25}, {"Olivia", 40}
    }

    fmt.Println("排序前:")
    for i, p := range people {
        fmt.Printf("%d: %s (%d岁)n", i, p.Name, p.Age)
    }

    // 使用sort.Slice按年龄排序
    sort.Slice(people, func(i, j int) bool {
        return people[i].Age < people[j].Age
    })

    fmt.Println("n使用sort.Slice排序后:")
    for i, p := range people {
        fmt.Printf("%d: %s (%d岁)n", i, p.Name, p.Age)
    }
}
这段代码里,多个元素的 Age 相同。按年龄排序后,你可能会发现这些同龄人的先后次序并不总能和原始切片保持一致。这里的关键不在于你的比较函数写错了,而在于你选用的排序函数本身就没有承诺“相等元素保序”。
核心原因:`sort.Slice` 不是稳定排序
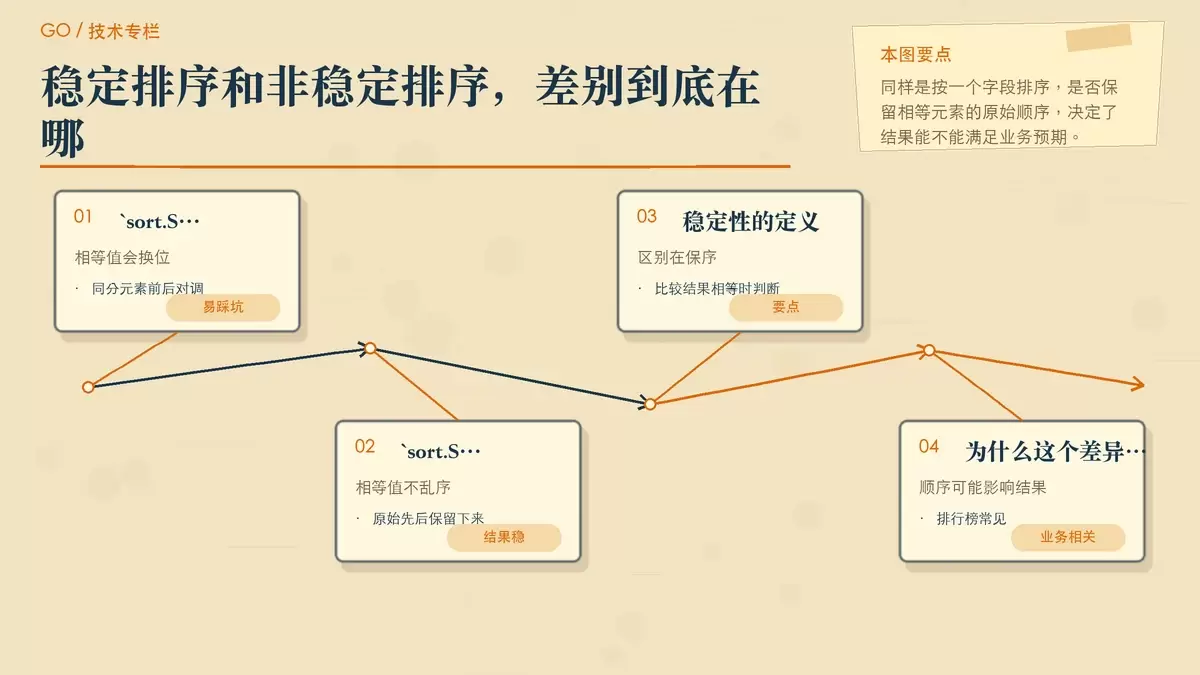
要理解这个行为,先得区分一个概念:稳定排序。
什么叫稳定排序
稳定排序的定义很直接:当两个元素比较结果相等时,排序完成后,它们的相对顺序和排序前保持一致。
还是用学生成绩举例。如果 张三 和 王五 分数相同,而且原始数据里 张三 在前面,那么稳定排序后,张三 仍然应该在 王五 前面。
反过来,非稳定排序 只保证最终整体有序,不保证“相等元素内部”的顺序不变。
`sort.Slice` 为什么会打乱相等元素
sort.Slice 使用的是一种名为 PDQSort 的混合排序算法。它综合了快速排序、插入排序和堆排序的一些特点,目标很明确:在通用场景下尽量取得更好的性能表现。
但性能优先的代价之一,就是它在分区和交换元素的过程中,可能把“比较结果相等”的元素移动到不同位置。换句话说,sort.Slice 关注的是最终顺序满足比较规则,而不是替你保留原始录入顺序。
所以这里不是 Go 的 bug,也不是排序偶发失效,而是函数行为本来就如此。只要你使用的是非稳定排序,相等元素顺序发生变化就是允许出现的结果。
PDQSort 在哪里改变了元素相对位置
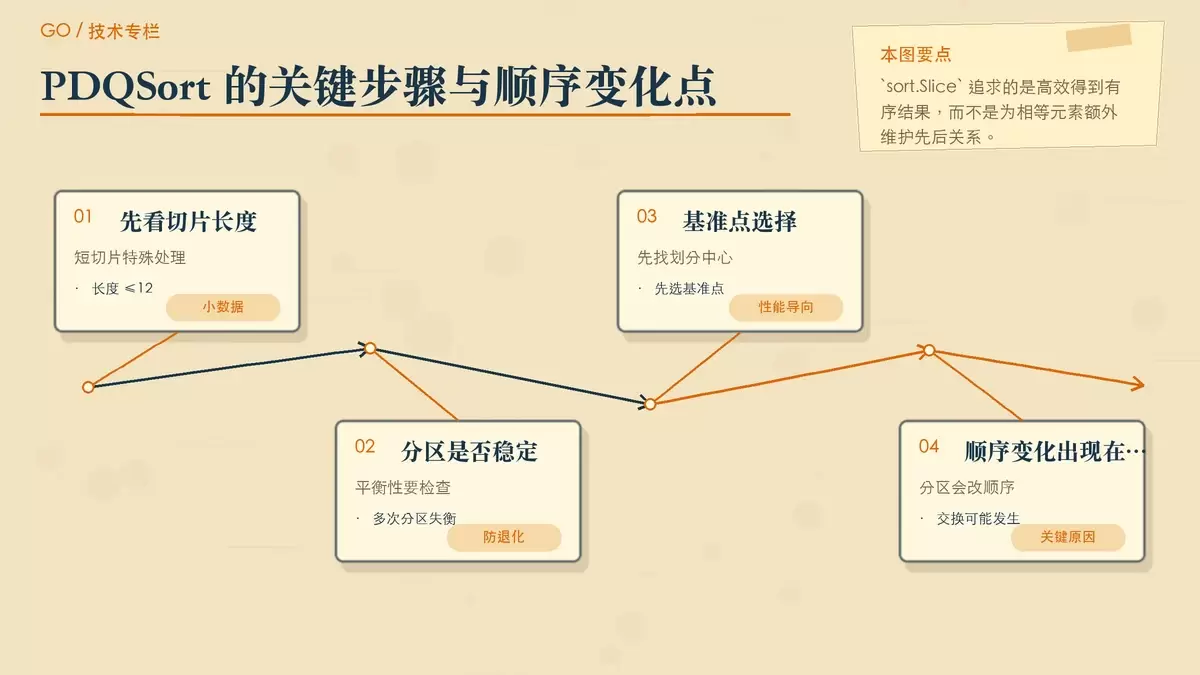
从实现思路上看,PDQSort 的流程可以简化理解为几步:
- 先判断切片长度,若长度较短(≤12)则走插入排序
- 检查分区是否平衡,多次失衡时退化为堆排序
- 选择基准点,并尝试识别数据是否接近有序
- 执行分区操作,把“小于基准”和“大于基准”的元素重新安排位置
问题就出在这一步分区。分区并不会专门为“相等元素保序”付出额外成本,因此在元素交换过程中,相等值记录的先后关系可能被打乱。
这也是为什么有些例子你跑出来“看着没问题”,换一组数据、换一个数据规模,或者只是多几个相等元素,现象就出来了。它不是每次都显眼,但只要业务依赖顺序,就不能把这种行为当作理所当然。
需要保序时,应该直接用 `sort.SliceStable`
如果你的业务明确要求“相等元素保持原始顺序”,对应做法不是给 sort.Slice 打补丁,而是直接改用 sort.SliceStable。
// 使用稳定排序保持相等元素的原始顺序
sort.SliceStable(students, func(i, j int) bool {
    return students[i].Score > students[j].Score
})
sort.SliceStable 提供的就是稳定排序语义。也就是说,只要比较结果相等,原始切片中的先后关系就会被保留下来。对于排行榜、流水记录、消息列表、二次排序这类场景,这通常才是更符合预期的结果。
它适合的场景主要有三类。
1. 多条件排序
这是稳定排序最常见、也最容易讲清楚价值的用法。比如你想先按姓名排序,再按成绩排序:
// 先按姓名排序(稳定)
sort.SliceStable(students, func(i, j int) bool {
    return students[i].Name < students[j].Name
})

// 再按成绩排序,姓名顺序保持不变
sort.SliceStable(students, func(i, j int) bool {
    return students[i].Score > students[j].Score
})
第二次按成绩排序时,分数相同的学生会继续保留第一次排序后的姓名顺序。这样就能得到“主排序键 + 次排序键”的最终结果,而且逻辑清晰,代码也容易维护。
2. 需要保留业务上的原始顺序
有些系统里,原始顺序本身就是业务语义的一部分,比如提交时间先后、创建顺序、导入顺序、人工编排顺序。此时即便排序字段相同,也不能接受顺序被算法随意打乱。
3. 需要结果稳定可预测
如果你希望排序结果更容易测试、更方便比对,或者前后端联调时不想出现“字段相同但顺序变了”的困惑,稳定排序通常更省事。它的行为更容易解释,也更符合多数人的直觉。
怎么选:看你要性能,还是要顺序语义
sort.SliceStable 并不是“全面替代” sort.Slice。两者的选择,核心还是看你是否在意相等元素的顺序。
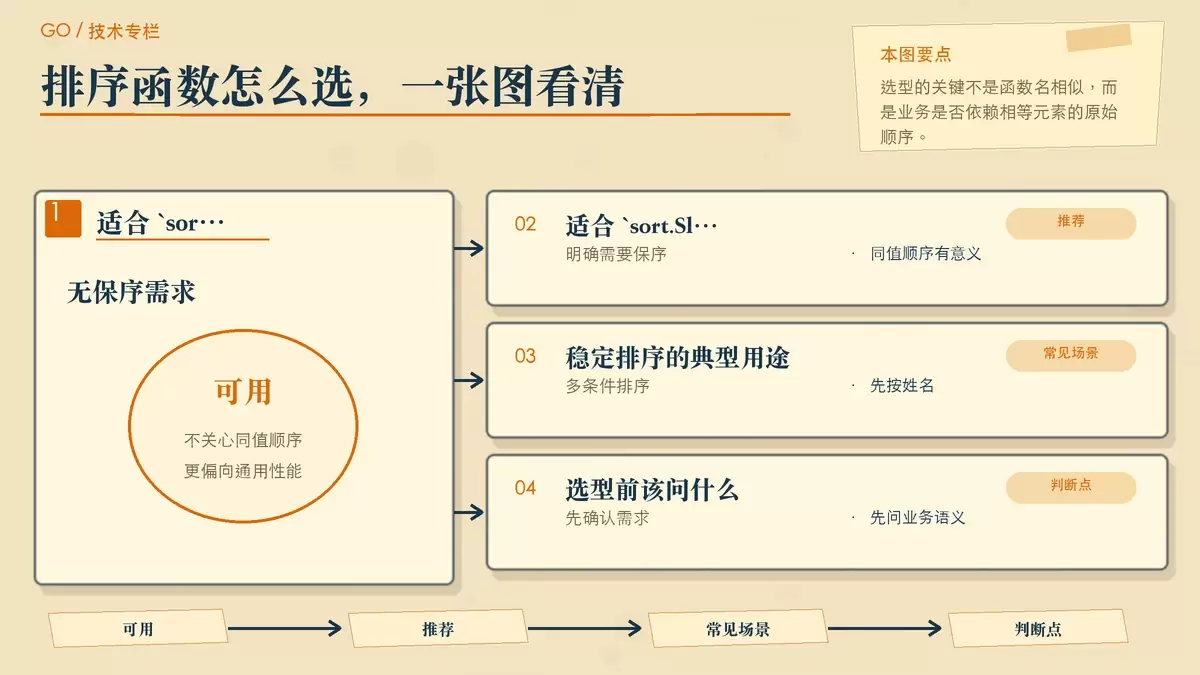
sort.Slice 的优势是通用、直接,通常也会更快一些;如果你的数据量很大,而且完全不关心相等元素谁在前谁在后,那么它是合理选择。
但只要满足下面任一条件,就该优先考虑 sort.SliceStable:
- 相等元素的原始顺序具有业务意义
- 你在做多条件排序
- 你希望结果稳定、可预测、便于测试
换句话说,真正该先问的问题不是“哪个更快”,而是:我是否允许相等元素的顺序被改变?
答案如果是否定的,就不要继续用 sort.Slice 碰运气。
最后总结
这类坑之所以容易踩,是因为从函数名上看,sort.Slice 和 sort.SliceStable 很像,但它们在“相等元素是否保序”这个点上,行为差异非常关键。
- 使用
sort.Slice:当你不关心相等元素顺序,或者更看重性能时 - 使用
sort.SliceStable:当你需要保持相等元素原始顺序时
因此,这次踩坑的结论其实很明确:sort.Slice 排序后相等元素顺序变化,不是异常,而是非稳定排序的正常表现。以后遇到切片排序,先确认业务是否依赖“同值保序”,再决定该用哪一个函数,代码行为才会真正符合预期。









