


在 Go 开发里,数组和切片长得很像,但一旦涉及传参、扩容、子切片或 JSON 输出,行为差异就会直接影响程序结果。很多“莫名其妙被改值”或“append 之后怎么断开了”的问题,本质上都和这两个类型的底层机制有关。下面按定义、运行行为、常见坑和选型建议四个层次拆开,帮你建立一套能直接用于写代码的判断方法。
先分清本体:Array 是值,Slice 是视图
要理解两者的区别,第一步不是记语法,而是先记住它们在 Go 里的身份并不一样。
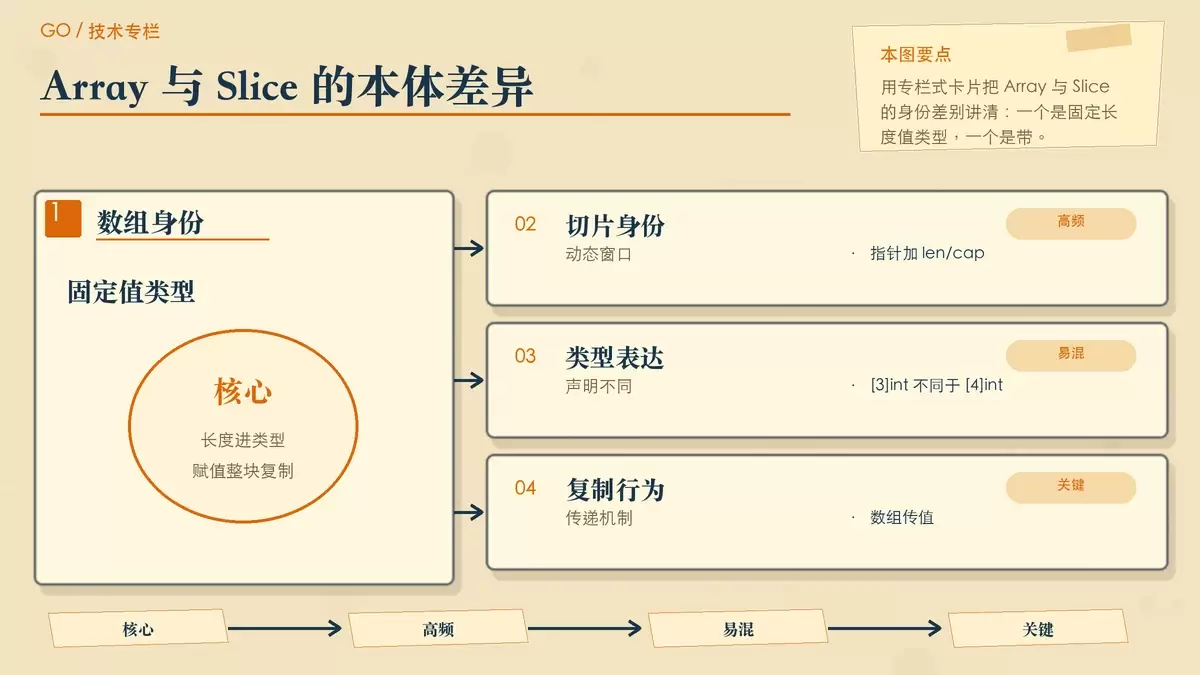
数组是固定长度的值类型
数组(Array)是固定长度、连续存储的同类型元素序列。它的长度在编译期就确定,而且长度本身就是类型的一部分。
// 多种数组声明方式
var arr1 [3]int           // 默认值 [0,0,0]
arr2 := [3]int{1, 2}      // [1,2,0](未赋值元素取零值)
arr3 := [...]int{1, 2, 3} // 编译器推断长度,类型为 [3]int这里最关键的一点是:[3]int 和 [4]int 是不同类型。数组也是值类型,赋值和传参时会复制整块数据。
切片是基于底层数组的动态窗口
切片(Slice)不是一块独立的固定数据本体,而是对底层数组的一层视图。它通常由三部分组成:指向底层数组的指针、当前长度 len 和容量 cap。
// 切片的多种创建方式
// 方式1:从数组创建
arr := [5]int{0, 1, 2, 3, 4}
s1 := arr[1:4]            // [1,2,3], len=3, cap=4

// 方式2:直接创建
s2 := []int{1, 2, 3}      // 创建底层数组并初始化切片

// 方式3:使用make函数
s3 := make([]int, 3, 5)   // 类型, 长度, 容量 → len=3, cap=5
切片传递或赋值时,复制的是这个“切片头”,而不是整段元素数据,所以多个切片可能共同指向同一块底层数组。
一张表看懂核心差异
| 特性 | 数组(Array) | 切片(Slice) |
|---|---|---|
| 长度 | 固定(类型一部分) | 动态可变 |
| 内存分配 | 直接存储数据 | 存储Header+底层数组 |
| 传递行为 | 值拷贝(完整复制) | 引用传递(Header拷贝) |
| 类型 | 值类型 | 引用类型 |
| 容量 | 无(固定=长度) | 有(可扩容) |
| 声明方式 | [N]T |
[]T |
| 零值 | 元素全零值 | nil(未初始化) |
| JSON序列化 | 正常数组 | 正常数组/null |
为什么切片容易出问题:扩容、共享与 copy
日常开发中,大多数实际问题都出在切片的动态行为上。它足够灵活,也因此更容易让人误判。
append 触发扩容时,底层数组可能重建
当切片长度超过当前容量时,Go 会为它分配新的底层数组,然后把旧数据拷贝过去。小切片常见表现是容量按 2 倍增长;当切片较大时,扩容策略会更保守。原文给出的经验是:对于大切片(>1024 元素),通常每次增加 25% 容量。
s := []int{1, 2}
s = append(s, 3)   // len=3, cap=4 → 底层数组重建
fmt.Println(cap(s)) // 输出 4
这也是为什么有些切片在 append 之前和之后看起来还像“同一个变量”,但和其他相关切片的联动关系却变了。
子切片会共享底层数组
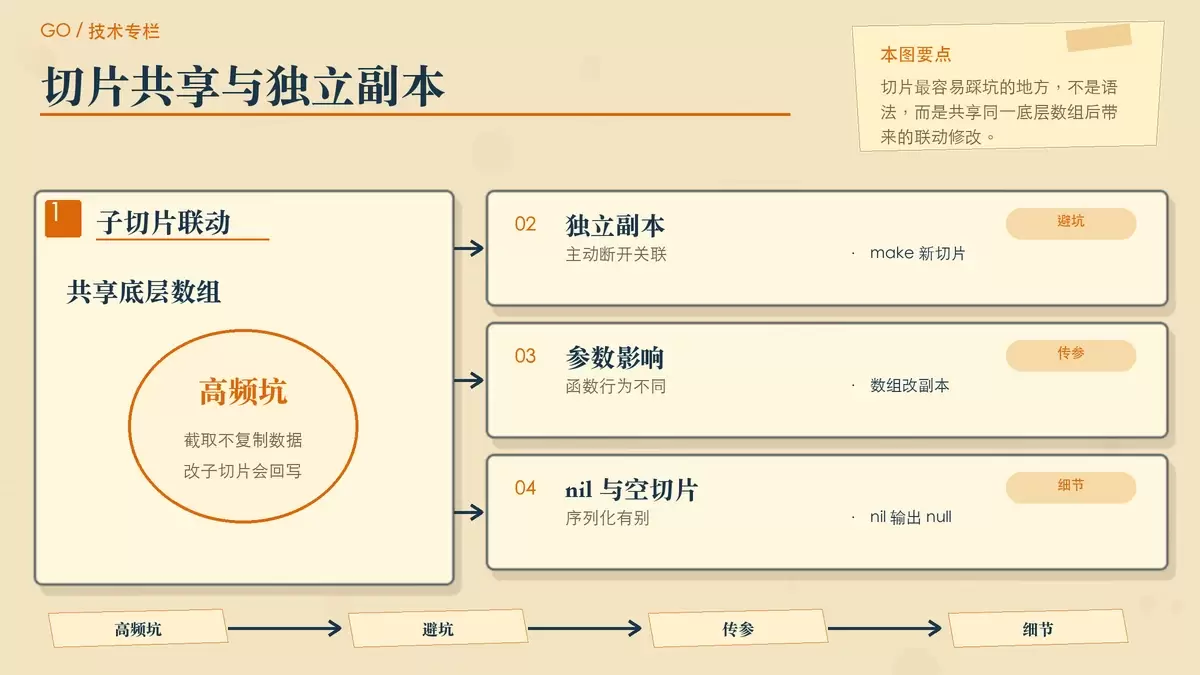
对切片做截取不会默认复制数据,而是生成一个新的视图。因此,修改子切片,经常会回写到原切片甚至原数组。
orig := []int{0, 1, 2, 3, 4}
sub := orig[1:3]   // [1,2] → len=2, cap=4
sub[0] = 99        // orig 变为 [0,99,2,3,4]
这里真正共享的是底层存储,而不是变量名本身。只要底层数组没变,多个切片之间就可能互相影响。
需要独立数据时,用 copy 明确断开
如果你需要一份真正独立的数据副本,最直接的方式就是显式分配新切片,然后用 copy 复制。
s1 := []int{1, 2, 3}
s2 := make([]int, len(s1))
copy(s2, s1)       // 深拷贝,s2与s1完全独立
s2[0] = 99         // 不影响s1
这条规则在“返回子区间数据”“缓存中间结果”“函数内避免副作用”这些场景里尤其重要。
传参差异和三个高频陷阱
Array 和 Slice 的行为差别,最容易在函数调用里放大。只看语法几乎一样,但运行结果往往完全不同。
数组传参是完整拷贝,切片传参共享底层数据
func modifyArray(arr [3]int) {
    arr[0] = 100  // 修改副本
}

func modifySlice(s []int) {
    s[0] = 100    // 修改底层数组
}

func main() {
    arr := [3]int{1, 2, 3}
    slice := []int{1, 2, 3}

    modifyArray(arr)  // 原数组不变
    modifySlice(slice) // 切片被修改

    fmt.Println(arr)   // [1 2 3]
    fmt.Println(slice) // [100 2 3]
}
这段代码足以说明核心区别:数组传进去的是副本,切片传进去的是“指向同一块数据的描述信息”。所以函数内改切片元素,外面通常也会看到变化。
陷阱一:子切片改值,原数据跟着变
这是最常见也最容易忽略的问题。很多人以为截取出来的是“新数组”,其实只是同一底层数组上的一段窗口。
original := []int{1, 2, 3, 4, 5}
subSlice := original[1:3] // [2,3]
subSlice[0] = 99          // 修改子切片会影响原切片
fmt.Println(original)     // [1,99,3,4,5]
如果你要保证修改只发生在局部,做法就是复制后再操作:
original := []int{1, 2, 3, 4, 5}
subSlice := make([]int, 2)
copy(subSlice, original[1:3])
subSlice[0] = 99  // 不影响原切片
陷阱二:append 之后关系断开,地址可能已经变了
切片共享底层数组这件事,并不是永远成立。一旦某个切片扩容,它可能会换到新的底层数组上,原先的“联动关系”就断了。
s1 := []int{1, 2, 3}
s2 := s1[:2]          // 共享底层数组 [1,2]
s1 = append(s1, 4)    // 容量不足,分配新数组
s1[0] = 100           // 修改新数组
fmt.Println(s1)       // [100,2,3,4]
fmt.Println(s2)       // [1,2] 仍指向旧数组
如果业务逻辑依赖多个切片继续共享同一块数据,就应该尽量预估容量,避免中途重分配:
// 预分配足够容量
s1 := make([]int, 3, 5) // len=3, cap=5
s2 := s1[:2]           // 共享底层数组
s1 = append(s1, 4)     // 未超容量,不重新分配
s1[0] = 100
fmt.Println(s2)        // [100,2] 仍共享
陷阱三:空切片和 nil 切片看起来一样,用起来不完全一样
这组差异很容易在接口设计、JSON 输出和返回值约定里踩坑。两者的 len 和 cap 都可以是 0,但语义不同。
var nilSlice []int    // nil切片, len=0, cap=0
emptySlice := []int{} // 空切片, len=0, cap=0

fmt.Println(nilSlice == nil)  // true
fmt.Println(emptySlice == nil) // false

// JSON序列化差异
json.Marshal(nilSlice)   // "null"
json.Marshal(emptySlice) // "[]"
实用建议也很明确:函数在“没有结果且伴随错误”时返回 nil 切片;如果要表达“结果为空集合”,则返回 make([]T, 0) 或 []T{} 更合适。
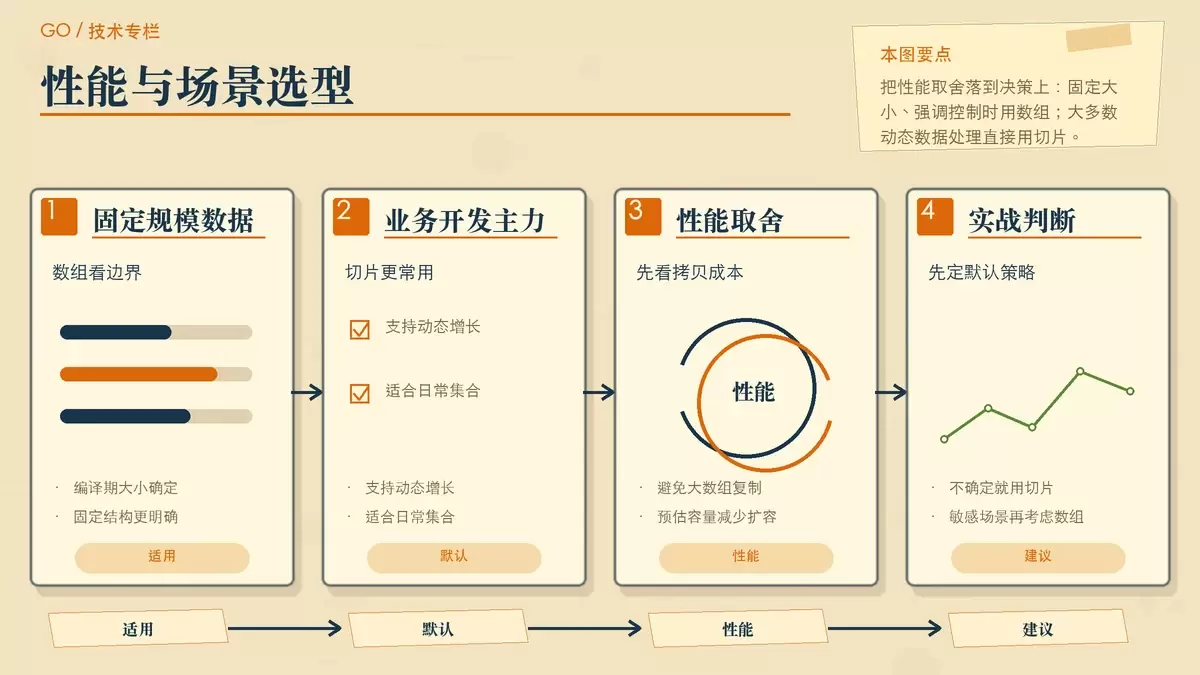
性能取舍与选型建议:什么时候该用数组,什么时候直接用切片
理解完机制之后,真正对开发最有帮助的,是把它转成选型规则。
数组适合哪些情况
数组不是日常业务代码里的主力,但在需要明确边界和稳定布局的地方,它很有价值:
- 集合大小在编译时就确定:比如固定长度表、协议字段或常量组,类型信息更明确。
- 需要精确控制内存布局:数组长度固定,适合对内存分配和复制行为有要求的场景。
- 性能敏感且数据规模固定:连续内存、无额外头部语义,编译器也更容易做边界优化。
- 固定大小结构:如密码哈希、固定常量表、内存映射这类数据表示。
切片为什么是 Go 开发的默认选择
绝大多数业务开发里,切片更符合实际需求,因为数据规模通常不是编译期就能完全确定的。
- 动态大小集合:可以追加、截取、拼接,表达能力更强。
- 函数参数传递更轻量:避免大数组整块复制。
- 适合日常数据处理:包括用户输入、数据库查询结果、批量处理列表等常见场景。
可以直接拿来用的判断规则
如果你平时写的是普通 Go 业务代码,可以先记住这几条:
- 拿不准大小时,优先用切片。这是最稳妥的默认选择。
- 需要精确控制复制行为和内存布局时,再考虑数组。
- 传大块固定数据且不希望随意被改时,可以考虑数组配合指针使用。
- 性能敏感并且能预估数据量时,优先写成
make([]T, 0, n),减少多次扩容。
简单说,数组更像“固定规格的数据本体”,切片更像“面向操作的动态容器”。前者重确定性,后者重灵活性。
最后总结
Array 和 Slice 的关键差别,不在语法外观,而在值语义和内存共享方式。数组长度固定、按值复制,适合大小明确且对内存和复制行为有要求的场景;切片长度可变、共享底层数组,是 Go 开发中更常见也更实用的容器。
真正决定代码是否可靠的,往往不是你会不会声明 []int,而是你是否知道什么时候会共享、什么时候会扩容、什么时候必须手动 copy。把这几条吃透,很多 Go 里常见的“数据为什么变了”问题都会变得非常直观。









