


Go 把并发能力做得很顺手,很多服务也因此天然会把多个 Goroutine 指向同一份状态。但在标准库和内置类型的设计里,默认前提通常是“没有额外加锁成本”,这也意味着多数类型一旦进入并发读写或并发修改场景,就可能直接崩溃、悄悄丢数据,或者暴露出很难复现的竞态问题。下面按几类最常见的对象逐一拆开:哪些地方最危险、底层为什么会出错,以及遇到这类共享状态时该如何判断该加锁、改模型,还是换成专门的并发安全结构。
map:并发读写最容易直接把进程打崩
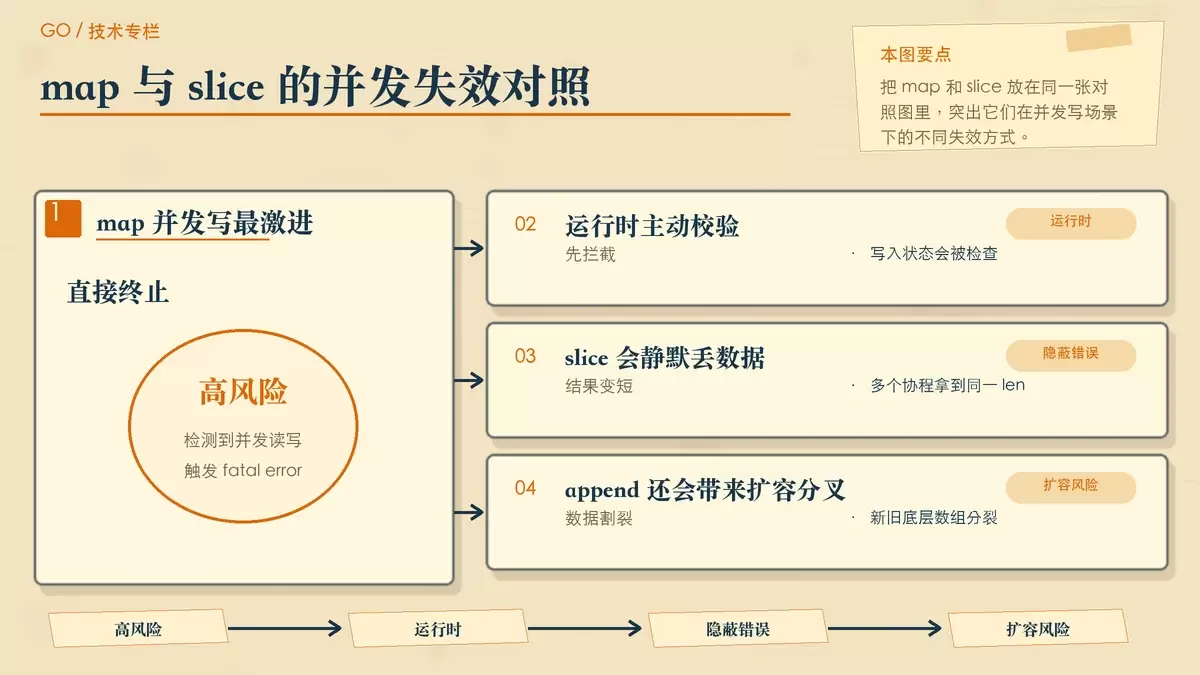
在 Go 各类数据类型里,map 对并发写最不宽容。只要运行时检测到并发读写,或并发写写,程序通常不是抛出一个可以恢复的 panic,而是触发 fatal error,直接终止整个进程。
在较新的 Go 运行时实现中,map 内部会维护写入状态。读写发生前,会检查当前是否已有写操作正在进行,逻辑可以概括为:
// 伪代码:Go 最新源码 internal/runtime/maps/map.go 内部并发校验逻辑
if m.writing != 0 {
    fatal("concurrent map read and map write")
}
m.writing = 1 // 标记写入中
之所以处理得这么激进,是因为 map 的底层哈希桶、迁移和扩容过程一旦被并发破坏,后果往往不是单次读错值这么简单,而可能演变成结构损坏、数据错乱甚至更严重的内存问题。运行时选择尽早终止,实际上是在阻止错误继续扩散。
因此,凡是多个 Goroutine 会共享修改同一个 map 的场景,都不能依赖侥幸。常见做法有两种:
- 用
sync.RWMutex显式保护普通map; - 在读多写少、键空间重叠率低的场景下,改用
sync.Map。
简单说,map 不是“可能不安全”,而是“只要并发改,就迟早出事”。
slice:并发 append 不一定崩,但很容易悄悄写坏
slice 的风险更隐蔽,因为它很多时候不会立刻崩溃,而是表现为长度不对、元素被覆盖、部分数据凭空消失。对排查来说,这类问题往往比直接报错更麻烦。
在 64 位架构下,slice 本质上是一个 24 字节的 Header,内部包含三部分:
array:底层数组指针len:当前长度cap:当前容量
执行一次 append,并不是单条原子操作,而是至少涉及读取旧 len、计算写入位置、写入元素、更新 len,必要时还会触发扩容并更换底层数组。这些步骤一旦被多个 Goroutine 同时打断,就会出现典型竞态。
// 演示并发 append 冲突
var slice []int
var wg sync.WaitGroup
for i := 0; i < 1000; i++ {
    wg.Add(1)
    go func(v int) {
        defer wg.Done()
        slice = append(slice, v) // 非原子操作,导致元素被覆盖
    }(i)
}
wg.Wait()这段代码结束后,len(slice) 往往小于 1000。根本原因是多个 Goroutine 可能读到了同一个旧的 len,随后把不同值写进同一个索引位置,结果就是后写覆盖前写。
更麻烦的是扩容场景。部分 Goroutine 可能已经拿到新的底层数组并继续追加,另一些 Goroutine 却还在旧数组上写。最终,slice 变量只会保留其中一个数组视图,另一边写进去的数据虽然“写过”,但对主切片来说等于丢失了。
如果确实要并发处理切片,通常有三种相对稳妥的方式:
- 提前分配固定容量,并按索引区间把写入范围切开,让每个 Goroutine 只写自己负责的位置;
- 把追加操作集中到单个 Goroutine,由其他协程通过
channel投递数据; - 直接用互斥锁保护共享切片。
判断原则很简单:只要多个协程会改同一个切片头部状态,尤其是会改 len 或触发扩容,就不能把 append 当成线程安全操作。
string、interface、struct 与指针:看起来简单,实际有复合状态风险
string 和 interface 不是单机器字
很多人会把 string 或 interface{} 误判成“赋值应该天然原子”的简单值,但这在 Go 里并不成立。原因在于它们底层都不是 8 字节,而是 16 字节复合结构。
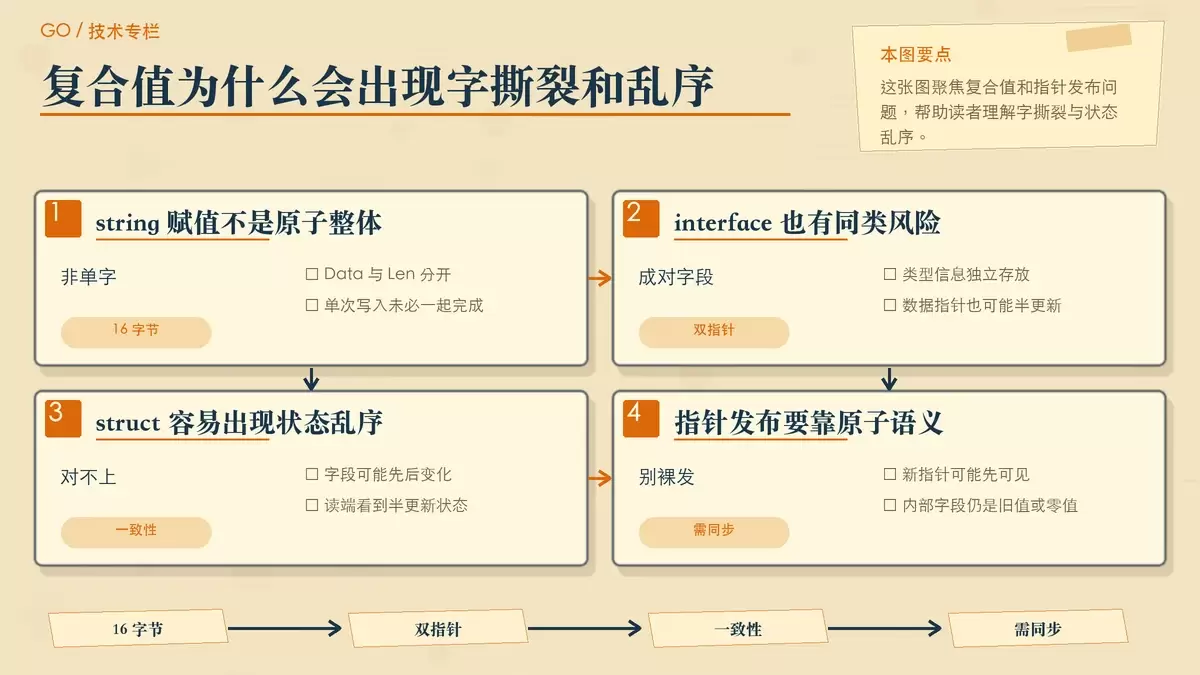
string 由两部分组成:
- 8 字节的
Data指针 - 8 字节的
Len长度
interface{} 同样由两部分组成:
- 8 字节的类型信息指针
- 8 字节的数据指针
而在 64 位 CPU 上,单次寄存器原子写入的常见上限通常是 8 字节。这意味着并发写同一个 string 或 interface{} 变量时,可能只更新了一半字段,另一半还是旧值,从而出现字撕裂。
// 并发修改 string 变量引发字撕裂
var target string
go func() {
    for { target = "a very long string payload..." }
}()
go func() {
    for { target = "short" }
}()这种情况下,target 可能出现“指针已经换成新字符串,但长度还是旧值”或者反过来的混合状态。后续读取一旦依据错误长度访问错误地址,就可能触发 panic: runtime error。
所以问题不在于字符串是否不可变,而在于“指向字符串的变量”本身是复合头部,多个字段的并发赋值并不安全。
struct 的问题在于字段一致性
普通 struct 也类似。它包含多个字段时,即便并发修改不会立刻造成越界,也无法保证读到的是同一个时刻的完整状态。某个 Goroutine 可能刚改完字段 A,还没来得及改字段 B,另一个 Goroutine 就已经把这份半更新状态读走了。
这类问题常见于配置热更新、缓存条目替换、连接状态对象共享等场景。程序表面看起来没有崩,但业务上会出现“字段彼此对不上”的乱序状态。
指针本身原子,不代表指针指向的内容可安全发布
对于普通结构体指针 *T,在 64 位机器上,指针读写本身通常是单机器字操作,但这不等于它天然适合无锁共享。缺失同步屏障时,编译器和 CPU 的重排序、缓存可见性问题依然可能让读端先看到“新指针”,却还没看到该对象内部字段的完整初始化结果。
也就是说,写端可能已经分配好结构体并把指针发布出去,但读端读取内部字段时,拿到的仍然是旧值或零值。这类 bug 非常典型,也最难靠肉眼审查发现。
如果要做无锁替换,应该使用带内存同步语义的工具,而不是直接裸写共享指针,例如:
atomic.Pointer[T]atomic.Value
它们解决的不只是“替换动作原子”,还包括发布和读取之间的 Happens-Before 关系。
bytes.Buffer 与 strings.Builder:共享实例时内部状态会被打乱
除了语言内置类型,标准库里一些常见的高性能拼装工具同样默认不具备并发安全。最常见的就是 bytes.Buffer 和 strings.Builder。
这两类结构内部通常维护一段 []byte 缓冲区,以及读写位置、长度等状态。单线程下它们非常高效,但共享给多个 Goroutine 同时读写时,内部状态就会相互踩踏。
// bytes.Buffer 并发写入示例
var buf bytes.Buffer
for i := 0; i < 100; i++ {
    go func(id int) {
        fmt.Fprintf(&buf, "data-%dn", id) // 并发修改内部 off 与 slice
    }(i)
}
一旦多个协程同时调用 Write 或 Read,内部 off 偏移、缓冲切片边界和长度信息都可能出现竞态,结果要么是拼接出的内容损坏,要么直接触发 index out of range。
这类问题在日志聚合、批量协议拼包、文本构造时尤其容易出现。更合适的做法是:
- 每个 Goroutine 使用独立的
bytes.Buffer或strings.Builder; - 在本地拼好后,再统一写入 I/O 或下游通道;
- 如果必须共享实例,就显式加锁。
不要因为它们常被当作“工具类对象”使用,就默认认为可以跨协程复用。
怎么判断该不该共享:Go 并发安全的实用边界
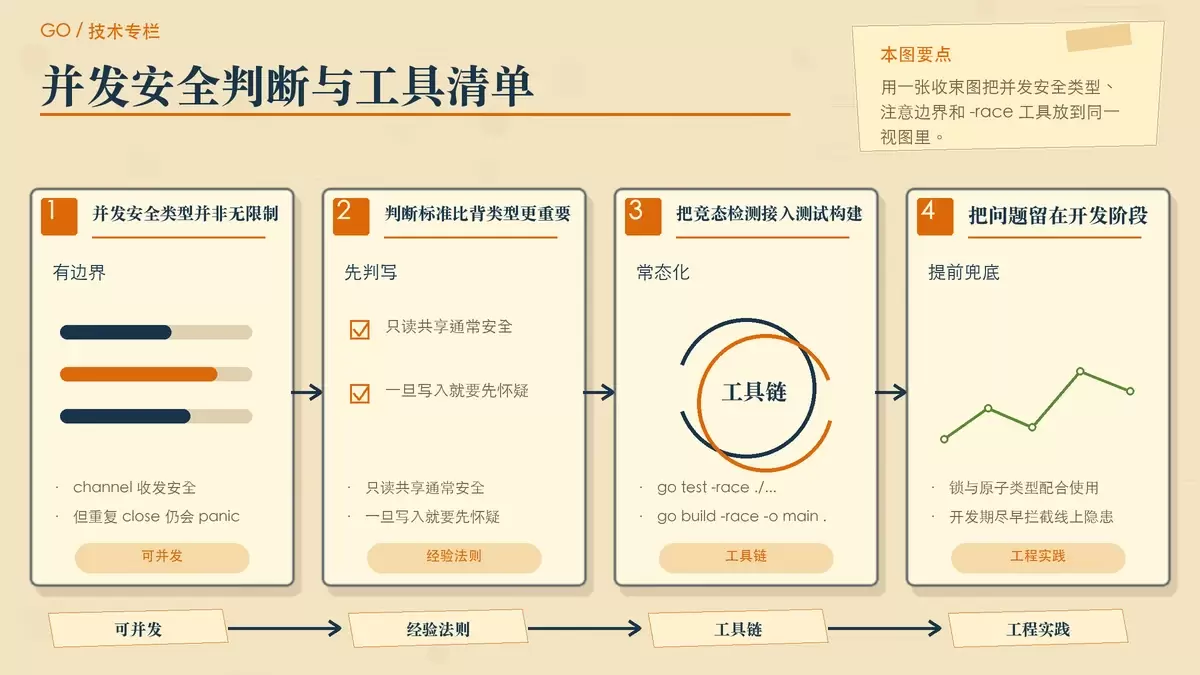
在 Go 生态里,真正原生面向并发设计的类型其实并不多。常见的包括:
channelsync.Mapsync.Poolsync/atomic提供的一组原子类型
不过即使是这些类型,也要注意边界。比如 channel 的收发是并发安全的,但并发重复关闭同一个 channel 仍然会触发 panic。
更实用的判断方式其实只有一句话:只读共享通常安全;一旦涉及写入、替换、扩容、偏移更新、复合字段赋值,就要默认它不安全,除非文档明确说明支持并发。
为了尽量把问题拦在开发阶段,应该把 Go 自带的竞态检测器接入日常测试和构建流程:
# 在单元测试与构建时开启竞态检测
go test -race ./...
go build -race -o main .
-race 会在编译期插入检测逻辑,在运行时持续追踪内存访问。一旦发现两个 Goroutine 在没有同步保护的情况下访问同一块内存,并且至少一方为写操作,就会输出带调用栈的竞态警告。
对 Go 项目来说,这不是可有可无的附加项,而是排查共享状态问题最直接的一道保险。尤其是那些“不一定复现”“线上才偶发”的并发 bug,很多都要靠 -race 才能提前定位。
归纳起来,Go 并发开发里最容易踩坑的并不是 Goroutine 本身,而是把本来面向单线程高性能设计的数据结构,误当成可并发共享对象。只要记住“只读共享、写时同步”,再配合锁、原子类型、专用并发结构和 -race 检测,大多数问题都能在进入生产前被拦下来。









