


AI 工具正在快速进入命令行场景,很多开发者最先接触到的并不是网页,而是能直接在终端里提问、查看结果、继续追问的 CLI。用 Go 来做这类工具有很现实的优势:标准库够用、并发处理顺手,最终还能编译成单文件,便于分发和内部使用。下面就按“先跑通交互、再接入流式返回、最后优化终端输出体验”的顺序,拆开看一个 Go 版 AI 命令行工具该怎么搭起来。
交互式命令行为什么适合 AI 工具
不少 AI 应用已经提供了 CLI 形态,比如 Claude Code、CodeBuddy CLI。它的价值不只是在“能用命令行”,而是在开发和调试场景里更直接:启动快、资源占用少,也更容易嵌进现有工作流。
如果使用 Go 来写,这个方向会更顺手一些。原因也很明确:一方面,标准输入、HTTP 请求、并发控制这些基础能力都能直接用标准库处理;另一方面,编译后的产物通常就是一个单文件,分发和部署都比较省事。
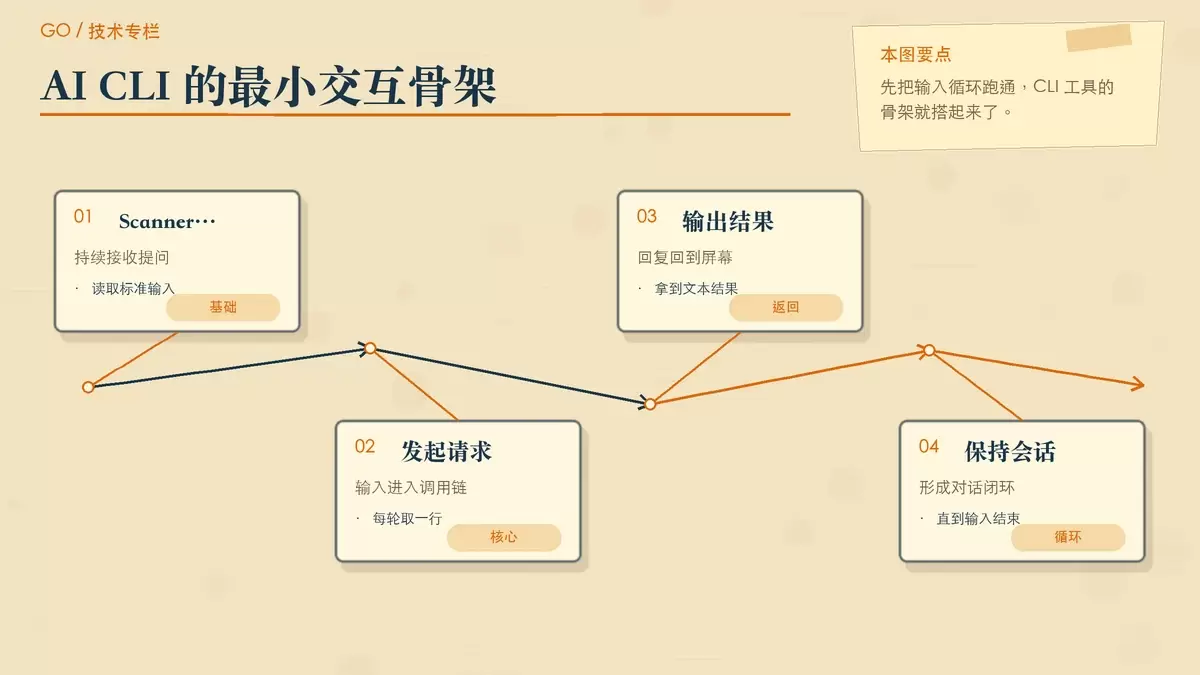
从实现上看,一个最基本的 AI CLI,本质上就是一个持续循环:
- 读取用户输入;
- 把输入发送给 AI 服务;
- 把返回结果输出到终端;
- 继续等待下一轮输入。
先把这条主线跑通,后面的流式输出和显示优化才有意义。
先实现最小可用的对话循环
交互式对话的核心并不复杂,关键是保持一个稳定的读写循环。最简单的做法就是从标准输入读取内容,然后把回复打印出来:
func main() {
    scanner := bufio.NewScanner(os.Stdin)
    for {
        fmt.Print("You: ")
        if !scanner.Scan() {
            break
        }
        input := scanner.Text()
        response := callAI(input)
        fmt.Printf("AI: %sn", response)
    }
}
这段代码的作用很直接:`bufio.NewScanner(os.Stdin)` 负责不断读取用户输入;`for` 循环保证程序不会只执行一轮;当 `scanner.Scan()` 结束时,程序退出;中间的 `callAI(input)` 则代表真正调用模型接口的部分。
对于入门实现来说,这种写法已经足够说明问题。它把 CLI 对话工具最重要的交互框架固定了下来,后续无论你接的是 OpenAI 兼容接口,还是内部封装的模型服务,整体结构都不会有太大变化。
流式输出怎么接:用 SSE 逐段接收模型结果
真正决定 AI CLI 体验的,往往不是“能不能返回答案”,而是“答案是不是实时出现”。如果必须等模型完整生成后再一次性输出,用户会明显感觉到停顿;而流式输出能把等待时间拆散,让响应显得更及时。
为什么流式返回几乎是标配
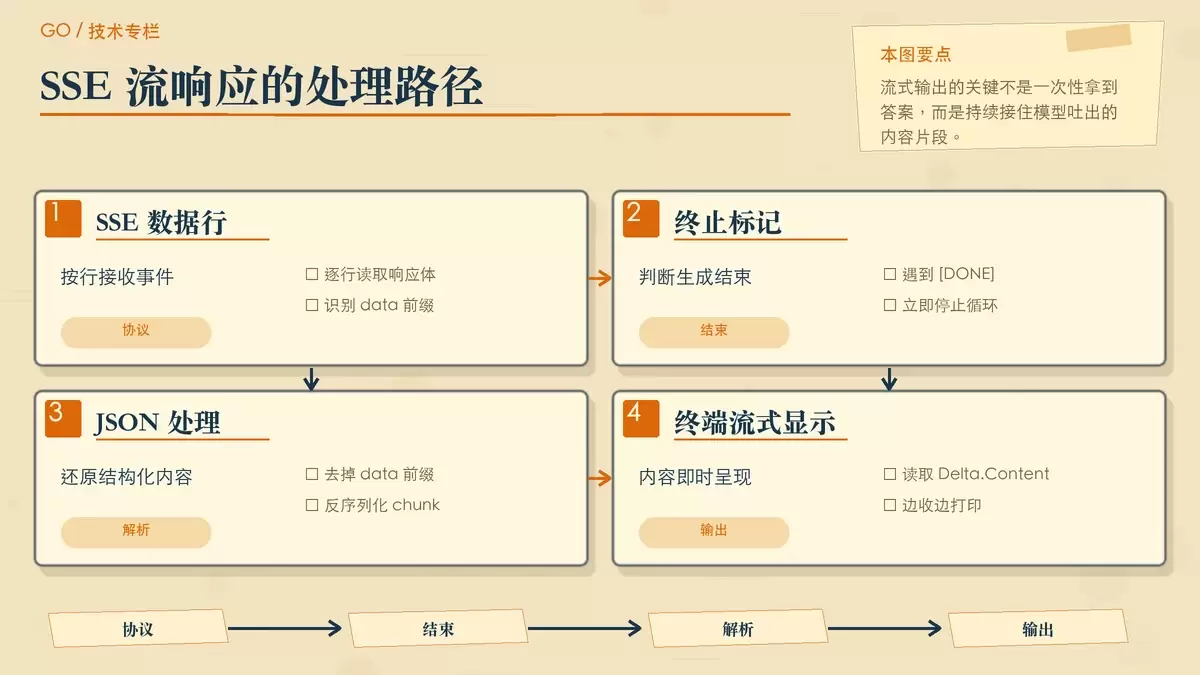
很多大模型 API 都支持 SSE(Server-Sent Events)流式输出。对于命令行工具来说,这种方式非常合适:服务端不断推送生成片段,客户端一边接收、一边显示,不需要等整段文本全部完成。
Go 里如何读取 SSE 响应
Go 处理这类响应并不复杂,关键点是把返回体当成持续到来的文本流来扫描:
func streamResponse(prompt string) {
    resp, _ := http.Post("https://api.openai.com/v1/chat/completions", "application/json", body)
    defer resp.Body.Close()
    scanner := bufio.NewScanner(resp.Body)
    for scanner.Scan() {
        line := scanner.Text()
        if strings.HasPrefix(line, "data: [DONE]") {
            break
        }
        if strings.HasPrefix(line, "data: ") {
            data := strings.TrimPrefix(line, "data: ")
            var chunk StreamChunk
            json.Unmarshal([]byte(data), &chunk)
            fmt.Print(chunk.Choices[0].Delta.Content)
        }
    }
}
这里可以关注三个事实:
- SSE 的每一行通常以 `data: ` 开头;
- 当收到 `data: [DONE]` 时,说明这轮生成结束;
- 解析出 `chunk.Choices[0].Delta.Content` 后,直接打印就能形成连续输出。
也就是说,所谓“流式输出”,本质上并不是一次拿到完整答案,而是把模型不断吐出的片段按顺序接住,再原样送到终端里。
终端里怎么显示,体验差别会很明显
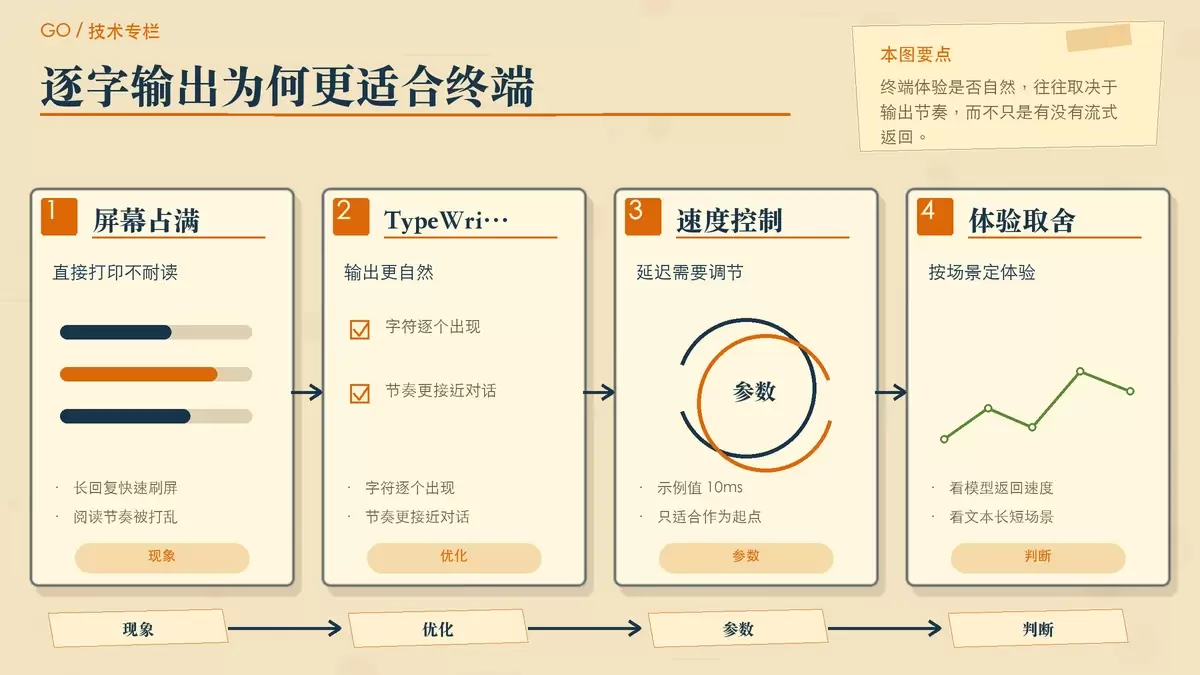
把流式结果直接 `fmt.Print` 出来,确实已经能工作,但终端体验未必理想。尤其是当 AI 回复很长时,内容会快速铺满屏幕,用户虽然看到了“实时输出”,却不一定更容易读。
逐字显示是一种更自然的做法
一个常见优化是加入逐字显示效果,用很小的延迟把文本一个字符一个字符打出来:
func typeWriter(text string, delay time.Duration) {
    for _, char := range text {
        fmt.Printf("%c", char)
        time.Sleep(delay)
    }
    fmt.Println()
}
在流式处理中,可以这样接起来:
for scanner.Scan() {
    data := parseStreamLine(scanner.Text())
    typeWriter(data.Content, 10*time.Millisecond)
}
这种方式的重点不是“模拟真人”,而是改善阅读节奏。用户能持续看到新内容出现,又不会一下子被整段长文本砸满终端窗口。
速度控制比效果本身更重要
逐字输出虽然更自然,但参数如果没调好,体验反而会变差。延迟太小,终端看起来像在高速刷屏;延迟太大,又会把本来已经生成出来的内容硬生生拖慢。
文中的示例使用了 `10*time.Millisecond`,这类数值更适合作为起点,而不是固定标准。是否合适,最终要看两件事:一是模型真实返回的速度,二是你的工具主要用于短问答还是长文本生成。命令行工具的体验优化,很多时候就在这种小细节上拉开差距。
适合用 Go 来做,但重点仍然是交互细节
把这几个部分合在一起看,一个可用的 Go 版 AI 命令行工具并不需要很重的工程结构:先有稳定的输入循环,再接上 SSE 流式响应,最后根据终端阅读习惯调整输出方式,就已经能形成一个体验不错的基础版本。
Go 在这里的优势很明确。并发模型和标准库让网络请求、流式读取、终端输出这些环节都能用比较简洁的方式完成;编译成单文件后,也适合做开发辅助工具或内部快速分发。不过,真正决定这个工具是否好用的,通常不是“功能有没有”,而是交互是否顺手、输出是否足够自然、等待过程是否让人愿意继续用下去。









