


很多 Go 开发者都踩过同一个坑:明明插入顺序没变,`for range` 遍历 `map` 的输出却时常不同,像是每次运行都在重新洗牌。这个现象表面上像实现细节,实际上是 Go 明确坚持的语言行为。下面从设计目的、底层原因和替代写法三个层面拆开说明,帮助你判断什么时候该接受无序,什么时候该主动补上顺序控制。
为什么 Go 的 map 遍历就是无序的
很多人第一反应是:`map` 底层用的是哈希表,所以无序只是哈希结构带来的副作用。这个理解只对了一半。
Go 的 `map` 确实基于哈希表实现,键会按照哈希值分散到不同的桶(bucket)中,本身就不具备像数组或切片那样的天然顺序。但 Go 并没有停留在“无序即可”的层面,而是进一步在运行时中强化了这一点:遍历 `map` 时,不保证固定顺序,实际遍历过程还会从不同位置开始。
也就是说,开发者看到的“每次输出都不太一样”,不是语言没定义清楚,而是语言在用行为提醒你:不要把 `map` 当成有序容器。
这一设计从 Go 早期版本开始就存在,目的非常明确,不是后来为了修补问题才加上的补丁。
这不是缺陷,而是刻意的语言设计
防止代码偷偷依赖遍历顺序
如果某种实现碰巧总按近似固定的顺序遍历,业务代码就很容易在不知不觉中依赖这种“表面规律”。这类依赖最危险的地方在于,它一开始往往不会报错,只有在 Go 版本变化、数据规模变化,或运行环境变化时才会暴露。
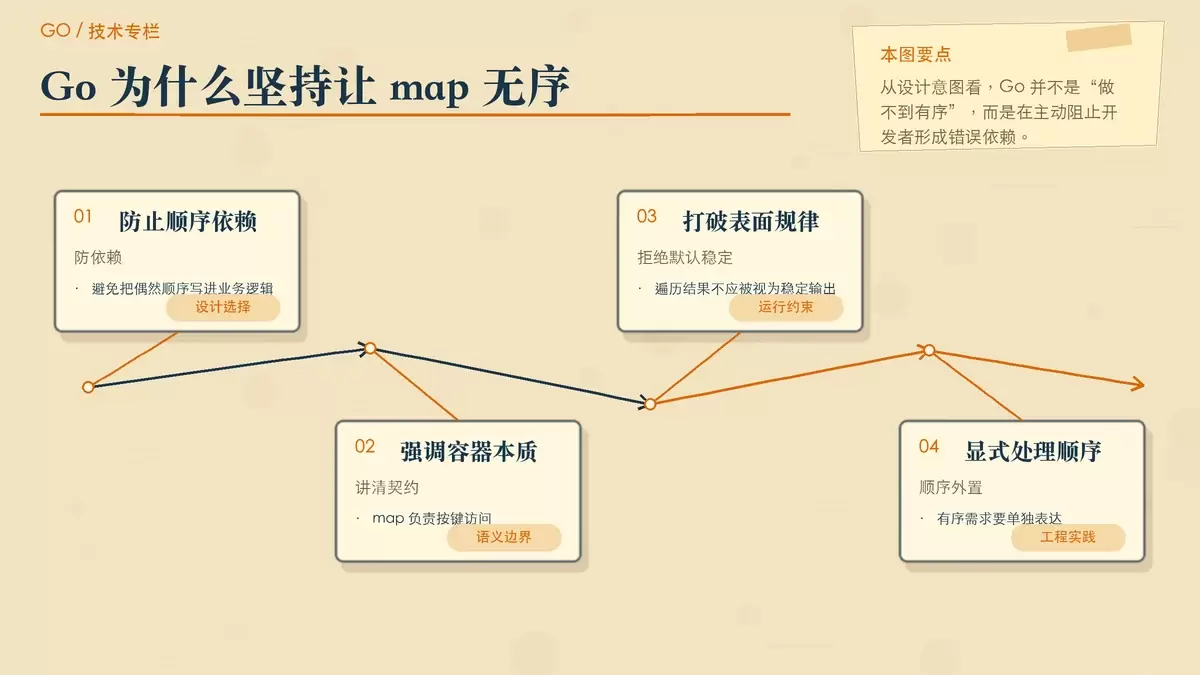
Go 团队希望把这种脆弱依赖尽量扼杀在早期,因此直接让遍历顺序不稳定。你一旦写出依赖顺序的逻辑,问题通常会尽快暴露,而不是拖到线上才发现。
强调 map 的抽象边界
`map` 在 Go 里表达的是“按键访问的集合”,重点是通过键快速查值,而不是按插入顺序、字典序或数值顺序访问元素。语言通过无序遍历这个特性,把容器的职责边界划得很清楚。
换句话说,Go 不是在告诉你“顺序刚好不可控”,而是在告诉你“顺序从来不属于 `map` 的契约”。
也有安全层面的考虑
哈希表如果让外部过于容易预测内部分布和访问模式,在某些场景下会增加被构造性输入针对的风险。遍历过程保持非固定顺序,虽然不是安全问题的唯一防线,但确实能减少开发者或攻击者对内部行为做静态假设的空间。
底层为什么会表现得不稳定
哈希存储天然不是线性排列
即使你按固定顺序插入键值对,这些元素进入 `map` 后,也会根据键的哈希结果落到不同的桶里。存储位置分散,决定了它本来就不适合提供可预测的线性遍历结果。
扩容后元素还会重新分布
当 `map` 中元素逐渐增多,运行时会触发扩容,并把已有元素重新分散到新的桶结构中。这样一来,同一批键值对在不同阶段所处的位置可能已经变化,遍历结果自然更不可能长期稳定。
遍历起点并不固定
Go 运行时在遍历 `map` 时,不是机械地永远从同一个桶、同一个偏移位置开始。起始位置的变化,会进一步放大“不可预测”这一特征,让开发者更难误以为某种输出顺序是可靠行为。
因此,`map` 的无序不是只由某一个因素造成,而是由哈希结构、扩容重排和遍历策略共同决定的。
需要有序遍历时,应该怎么做
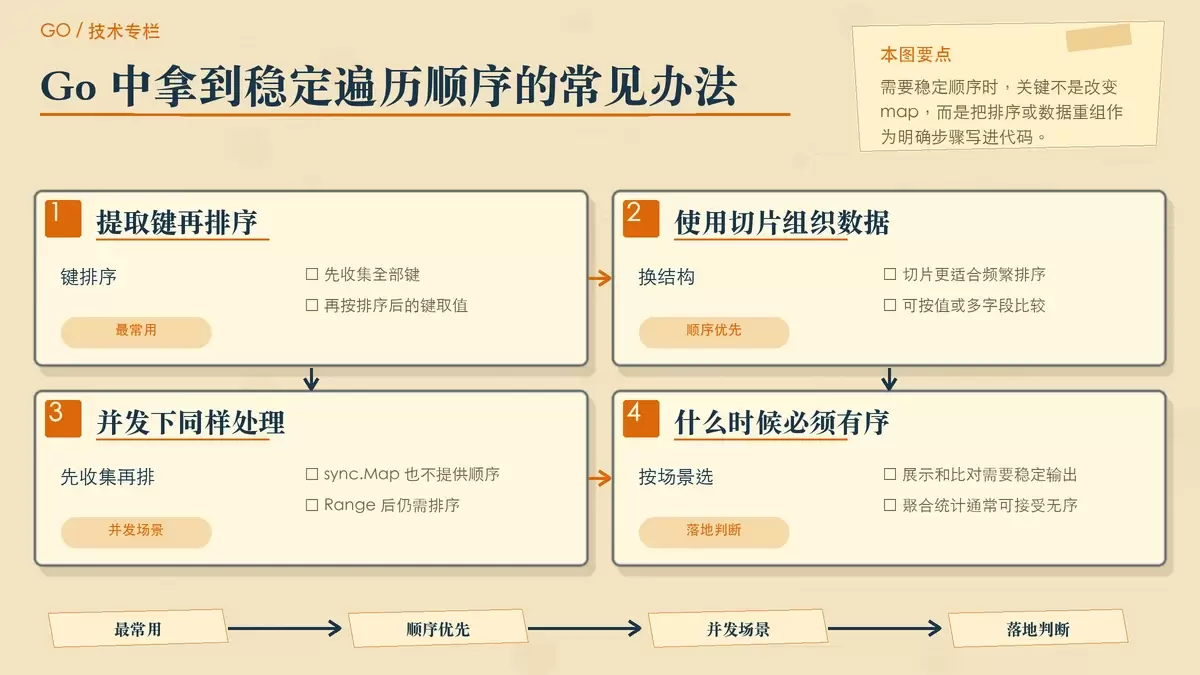
结论很简单:不要试图从 `map` 本身拿顺序,而是把顺序需求显式写出来。这是最符合 Go 设计思路的做法。
先取键,再排序
这是最常见、也最通用的方式。先把所有键提取到切片,再排序,最后按排好序的键访问 `map`。
package main
import (
    "fmt"
    "sort"
)

func main() {
    m := map[string]int{
        "apple": 5,
        "banana": 2,
        "orange": 4,
    }

    // 提取键到切片
    keys := make([]string, 0, len(m))
    for k := range m {
        keys = append(keys, k)
    }

    // 对键排序
    sort.Strings(keys)

    // 按排序后的键遍历
    for _, k := range keys {
        fmt.Printf("%s: %dn", k, m[k])
    }
}
这种写法的好处是意图明确。你要的是字典序,那么就调用 `sort.Strings(keys)`;你要的是别的规则,也可以换成自定义排序。
顺序访问很多时,考虑换数据组织方式
如果你的核心需求不是“按键快速查值”,而是“经常按某种顺序遍历”,那就要重新判断 `map` 是否还是主结构。原文里给出的思路是使用切片配合结构体:
type Pair struct {
    Key string
    Value int
}

pairs := []Pair{{"apple", 5}, {"banana", 2}}
// 按需排序
sort.Slice(pairs, func(i, j int) bool {
    return pairs[i].Value < pairs[j].Value
})
这种方式牺牲了一部分按键直取的便利,但换来了更直接的顺序控制。适合展示列表、排名结果、需要多字段排序的数据集等场景。
并发场景也一样,顺序要自己补
即使用的是 `sync.Map`,也不能指望遍历结果天然有序。要有序处理,仍然要先收集键,再排序,再逐个读取值:
var m sync.Map
// ... 存储数据 ...

var keys []string
m.Range(func(k, _ interface{}) bool {
    keys = append(keys, k.(string))
    return true
})

sort.Strings(keys)
for _, k := range keys {
    v, _ := m.Load(k)
    // ... 处理数据 ...
}
这也说明一个核心原则:无论是 `map` 还是 `sync.Map`,有序遍历都不是容器默认提供的保证,而是调用方要显式追加的一步。
实际开发里该怎么判断
如果你只是做查找、计数、去重、聚合,`map` 的无序通常完全不是问题,接受它即可。真正要警惕的是下面这类写法:测试里默认某个遍历顺序、接口输出直接依赖 `map` 迭代结果、生成配置或签名时未做排序就直接拼接。
一旦结果要参与展示、序列化、比对、缓存键生成,或者任何需要稳定输出的场景,就应该主动加上排序步骤,或者改用更适合顺序访问的数据结构。
从这个角度看,Go 对 `map` 遍历无序的坚持,其实是在逼着代码把“顺序需求”写明白。短期看像限制,长期看反而能减少隐藏依赖,提升代码的可维护性和可迁移性。
所以,这件事不是语言缺陷,而是 Go 故意保留下来的约束。理解这一点后,再看到 `map` 遍历结果变化,就不必把它当成异常;真正该检查的是:你的业务逻辑是否错误地假设了它应该有序。









