


在 API 网关、防火墙黑白名单和高并发网络服务里,IP 解析、比对和查表往往是最常见也最容易被忽视的热点路径。很多 Go 项目还在沿用 net.ParseIP 与 net.IP,但从 Go 1.18 起,标准库其实已经给出了更适合新代码的选择。下面就按工程里最关心的几个问题展开:旧类型到底慢在哪里、netip.Addr 为什么更稳,以及它在查表、网段判断和地址组合场景里能带来什么实际收益。
为什么旧版 net.IP 容易埋下性能和并发隐患
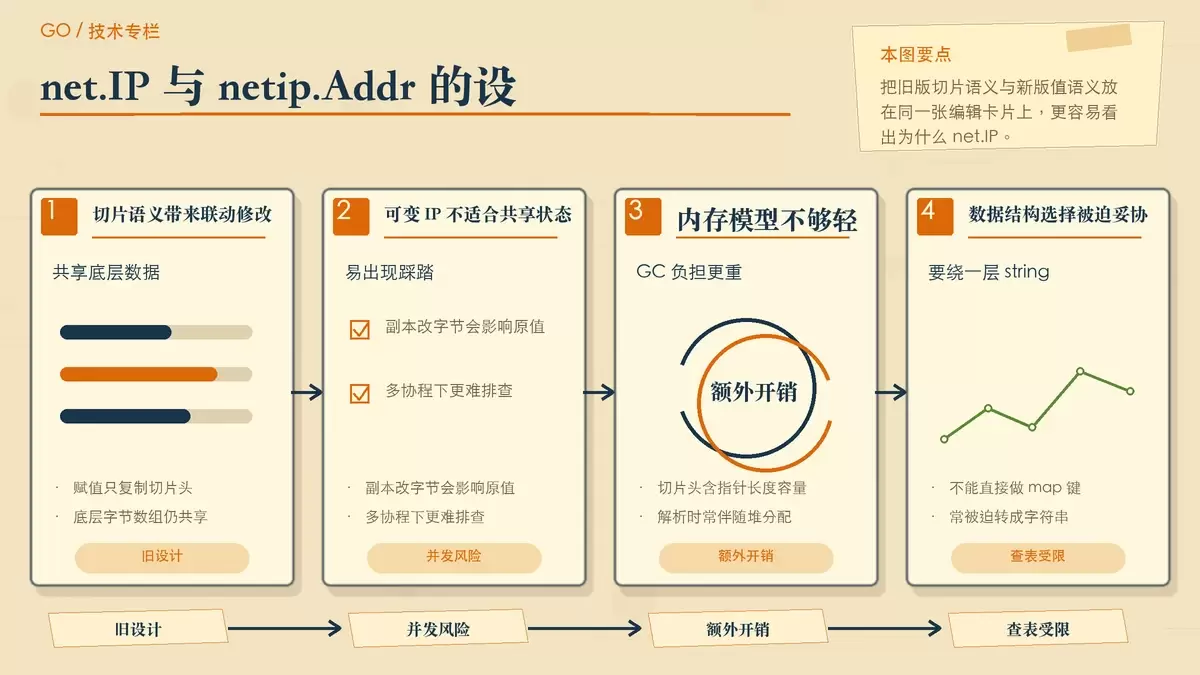
要理解 net/netip 为什么值得单独引入,先得看清 net.IP 的设计问题。标准库里它的底层定义非常直接:
// net 包中的原始定义
type IP []byte
这意味着 net.IP 本质上只是一个 []byte 切片。切片在 Go 里是引用语义:变量赋值、参数传递时,复制的是切片头,底层字节数组仍然共享。对工程代码来说,这会直接带来第一个问题:IP 值并不是天然只读的。
如果某段逻辑把一个 net.IP 复制给别的变量后又修改了其中某个字节,原始数据也会一起被改掉。这类问题在配置缓存、规则下发、并发共享对象里尤其难排查。
// 篡改子变量导致原始 IP 被破坏
oldIP := net.ParseIP("192.168.1.1")
ipCopy := oldIP
ipCopy[0] = 10 // 修改副本的第 0 位

// 此时 oldIP 被默默篡改为 10.168.1.1(IPv4 映射形式)
这里的风险不只是“写法不优雅”,而是会演变成真实的数据竞争。多个协程共享同一份 IP 数据时,只要其中一个路径发生意外修改,其他模块读取到的就是被污染后的结果。
第二个问题是内存模型不够轻。切片头本身包含指针、长度、容量,在 64 位环境下通常占 24 个字节;而切片引用的底层数组又往往在堆上。即便只是一个 IPv4 地址,net.ParseIP 解析后也可能触发堆分配。更麻烦的是,为了兼容 IPv4 和 IPv6,旧实现经常把 IPv4 统一表示成 16 字节的 IPv4-mapped IPv6 形式,这会进一步放大额外开销。
第三个问题出现在最常见的查表场景里。由于切片不可比较,net.IP 不能直接作为 map 的键使用,像 map[net.IP]string 这样的写法会直接编译失败。于是很多项目都退而求其次,把 IP 转成字符串再做键:
// 必须转为 string 才能作为 Key
ipMap := make(map[string]bool)
ipMap[ip.String()] = true问题在于,ip.String() 每次都要生成新的字符串值。对于每秒数万次甚至更高频率的黑白名单命中判断,这类临时对象会持续制造内存垃圾,把 GC 压力抬上去。
netip.Addr 为什么能做到更快且不可变
net/netip 的核心类型是 netip.Addr。它不是对 net.IP 的小修小补,而是换了一种底层建模方式:把 IP 设计成值类型,而不是切片。
// netip.Addr 简化的内部结构示意
type Addr struct {
    ipBits uint128
    z      *intern.Value
}从工程角度看,这个变化有两个关键点。第一,netip.Addr 是按值传递的结构体;第二,它没有暴露可直接改写内部字节的接口。也就是说,你拿到一个地址值后,默认就是不可变的。
这和 net.IP 的差别非常大。以前复制一个 IP,复制的是“对同一块底层数据的引用”;现在复制一个 netip.Addr,得到的是独立的值语义,不会因为别处的修改而联动变化。对于并发代码,这等于天然削掉了一类共享可变状态问题。
文章给出的示例也能说明这一点:
// 不可变设计:Next() 返回新值,原地址不受影响
newAddr, _ := netip.ParseAddr("192.168.1.1")
nextAddr := newAddr.Next()
像 Next() 这样的操作,不会原地改写已有地址,而是返回一个新的 netip.Addr。调用方既能得到目标结果,也不用担心旧值被悄悄污染。
此外,值类型还有一个很现实的收益:减少堆对象和指针追踪。文中提到,在 64 位机器上,netip.Addr 的大小被控制在 24 字节以内,和一个切片头接近,但它不再依赖外部字节数组来保存 IP 数据。这样在函数传递、临时比较和结构体嵌套时,编译器更容易把它留在寄存器或栈上处理,GC 也就少了一批需要扫描的堆对象。
直接做 map Key,性能差异到底有多大
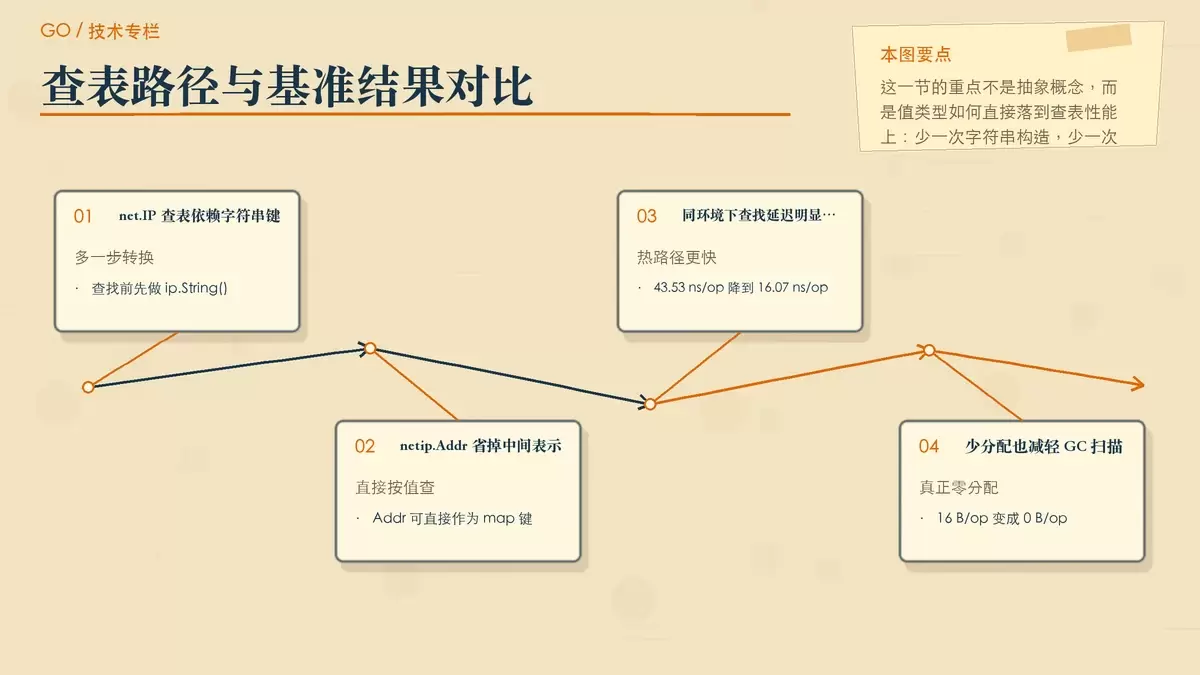
netip.Addr 的另一个决定性优势,是它可以比较。可比较意味着两件事:一是可以直接用 == 判断相等;二是可以直接作为 map 的键。这对规则匹配、ACL、网关路由表之类的代码非常重要。
// 直接使用 netip.Addr 作为 map 的 Key
ipRules := make(map[netip.Addr]string)
addr, _ := netip.ParseAddr("192.168.1.1")
ipRules[addr] = "allow"
一旦能直接拿值做键,原来那条“先转字符串再查表”的绕路就不需要了。少掉的不只是代码步骤,还有字符串分配、哈希对象构造和后续 GC 扫描。
原文给出了一组对比基准。先看旧方式,也就是 net.IP 配合字符串键:
// 使用 net.IP 查找:必须先转为 string,触发堆内存分配
func BenchmarkNetIPMapLookup(b *testing.B) {
    m := make(map[string]int)
    ip := net.ParseIP("192.168.1.1")
    m[ip.String()] = 1
    for i := 0; i < b.N; i++ {
        _ = m[ip.String()]
    }
}
再看 netip.Addr 的版本:
// 使用 netip.Addr 查找:直接按值对比,0 内存分配
func BenchmarkNetipAddrMapLookup(b *testing.B) {
    m := make(map[netip.Addr]int)
    addr, _ := netip.ParseAddr("192.168.1.1")
    m[addr] = 1
    for i := 0; i < b.N; i++ {
        _ = m[addr]
    }
}
测试环境和结果如下:
// CPU 架构: Intel(R) Core(TM) i7-9700KF CPU @ 3.60GHz
// Go 版本 : go1.26.4 darwin/amd64

BenchmarkNetIPMapLookup-8       27229502    43.53 ns/op    16 B/op    1 allocs/op
BenchmarkNetipAddrMapLookup-8 73322674 16.07 ns/op 0 B/op 0 allocs/op这组数据的含义很直接:同样是查一次哈希表,netip.Addr 把耗时从 43.53 ns/op 压到 16.07 ns/op,大约提升了 63%;同时把 1 allocs/op 降到 0 allocs/op。对单次调用看似只是几十纳秒的差距,但如果这个路径处在高并发请求的热循环里,累计效果就会非常明显。
更重要的是,0 分配带来的收益不仅是“更快”,还意味着更稳定。对象少了,GC 扫描负担更轻,尾延迟抖动通常也更容易控制。这也是为什么官方会明确建议在新代码里优先采用 net/netip。
不只 Addr:Prefix 和 AddrPort 也一起补齐了常见场景
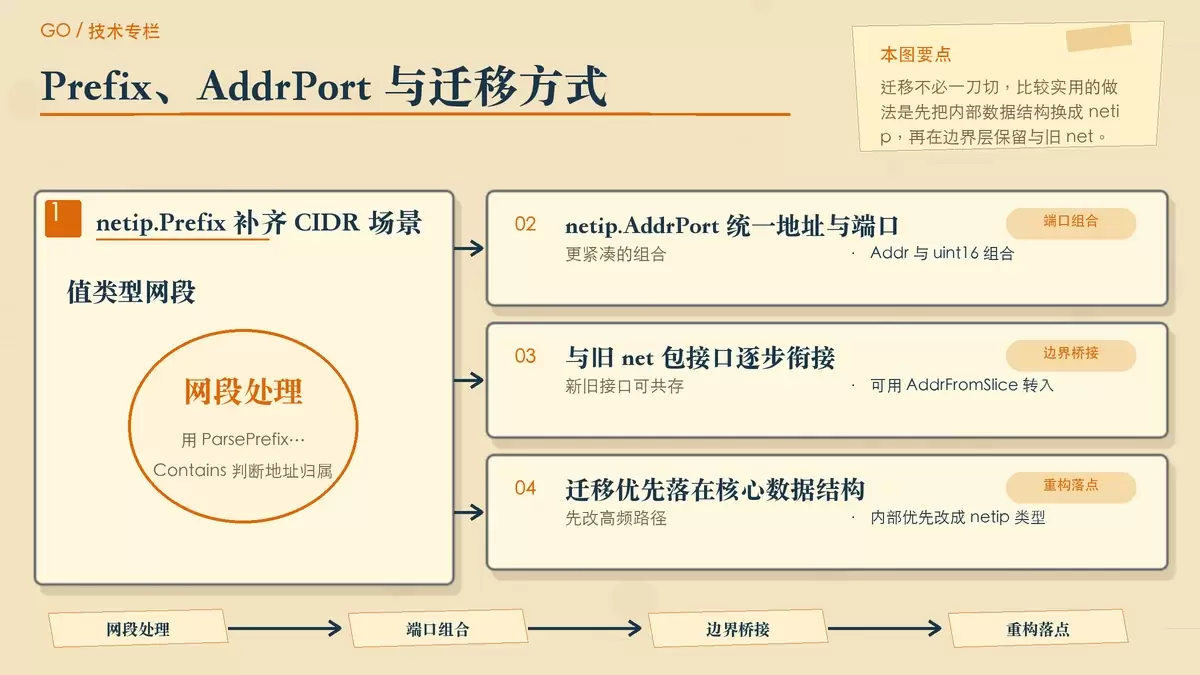
IP 地址本身只是网络编程的一部分。工程里常见的另外两类数据是 CIDR 网段,以及“IP + 端口”这样的 socket 地址组合。net/netip 也把这两块一起做了值类型化。
网段处理方面,旧标准库常用的是 net.IPNet。它内部包含 IP 和 Mask 两个切片,天然带着和 net.IP 相似的内存与分配问题。对应的新类型是 netip.Prefix:
// 创建并判断 IP 是否属于目标网段
prefix, _ := netip.ParsePrefix("192.168.1.0/24")
contains := prefix.Contains(addr)
netip.Prefix 同样是不可变、按值传递的表示方式。对于路由匹配、网段归属判断、白名单段校验这类逻辑,这种建模比旧式的切片组合更适合作为内部核心结构。
另一类常见需求是把地址和端口绑在一起。以往很多代码会使用 net.TCPAddr 或 net.UDPAddr,它们本身是带指针的结构。net/netip 提供的 netip.AddrPort 则更紧凑:
// 优雅组合 IP 与端口,无指针开销
addrPort := netip.AddrPortFrom(addr, 8080)
这样一来,地址、网段、地址加端口这三类最常见的数据模型,在新包里都能统一为更接近值语义的处理方式。对于中间件、代理、服务发现、连接跟踪这类需要大量缓存和比对的模块,这种一致性本身就很有价值。
什么时候该迁移,怎么和旧接口共存
如果你的项目还在维护老代码,不一定要一次性把所有 net.IP 全部替换掉,但新模块和高频路径确实值得优先迁到 net/netip。尤其是这些场景,收益通常最明显:
- 黑白名单、ACL、限流规则等高频查表逻辑
- 网关、代理、防火墙、服务网格等网络中间件
- 并发共享 IP 配置、缓存对象或路由状态的服务
- 需要大量处理 CIDR、Socket 地址组合的底层网络模块
原文也提到了一点很实用的工程建议:如果必须和旧标准库 API 共存,例如继续对接 net.Dialer、net.Listen 这类接口,可以通过桥接方法逐步过渡,而不是硬切整套代码。
转换时可以使用 netip.AddrFromSlice(slice) 把切片转成 Addr,也可以调用 addr.AsSlice() 导出切片形式。这样做的意义在于,把旧接口限制在边界层,把内部状态尽量收敛到 netip.Addr、netip.Prefix、netip.AddrPort 上。
如果再进一步落实到数据结构层面,一个很直接的重构动作就是,把原先为了兼容 net.IP 而写出的 map[string]Value 迁成 map[netip.Addr]Value。这既能减少字符串分配,也能让代码语义更贴近“按 IP 值查找”本身,而不是借助字符串做中间表示。
归根结底,net/netip 的价值不只是某个 API 更现代,而是它把 Go 在网络地址处理上的几个老问题一起收拾干净了:可变切片导致的数据污染风险、无法直接做键的结构限制、额外的堆分配以及由此带来的 GC 压力。对于今天还在写新 Go 网络代码的团队来说,把 netip 作为默认方案,已经不是“可以考虑”,而是更符合标准库演进方向的工程选择。









