

MySQL千万级大表优化:从设计到分库实战指南
面对MySQL千万级数据量导致的查询卡顿,在升级硬件前需优先优化表结构与SQL。核心策略包括:选型合适数据类型与引擎(如InnoDB)、规范索引创建原则、优化SQL写法避免全表扫描、采用RANGE或HASH分区提升单表性能,以及在必要时进行垂直/水平分表与读写分离。
2026-10-15
8
面对MySQL千万级数据量导致的查询卡顿,在升级硬件前需优先优化表结构与SQL。核心策略包括:选型合适数据类型与引擎(如InnoDB)、规范索引创建原则、优化SQL写法避免全表扫描、采用RANGE或HASH分区提升单表性能,以及在必要时进行垂直/水平分表与读写分离。
本文介绍 MySQL 数据库开启 binlog 日志的方法,并通过模拟误删除数据的场景,演示如何利用 mysqlbinlog 工具基于 position 或时间点进行数据精准恢复,提供完整操作步骤与常用参数说明。
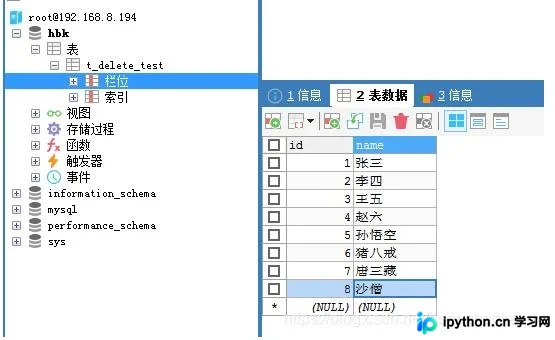
本文深入解析MySQL中DISTINCT与GROUP BY在去重场景下的本质区别。通过MyBatis-Plus实战发现,多列去重时DISTINCT需包含所有选择字段,否则可能导致主键缺失;而GROUP BY可按指定字段分组并保留其他统计信息。附带针对10万条数据的索引与去重效率测试,结论表明两者在无索引情况下性能差异极微。
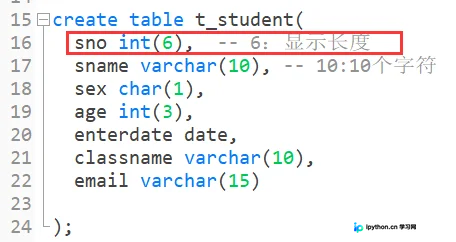
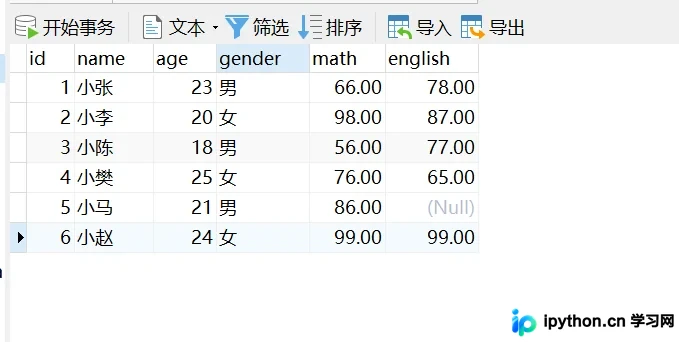
本文详解MySQL中使用INSERT INTO语句向表中添加数据的两种核心方式。介绍全字段值匹配的语法及注意事项,包括日期格式处理、字符类型限制(Char/Varchar)及当前时间函数now()的应用。同时演示当未插入全部字段时,必须显式指定目标列名以避免报错的操作规范,确保数据准确写入。
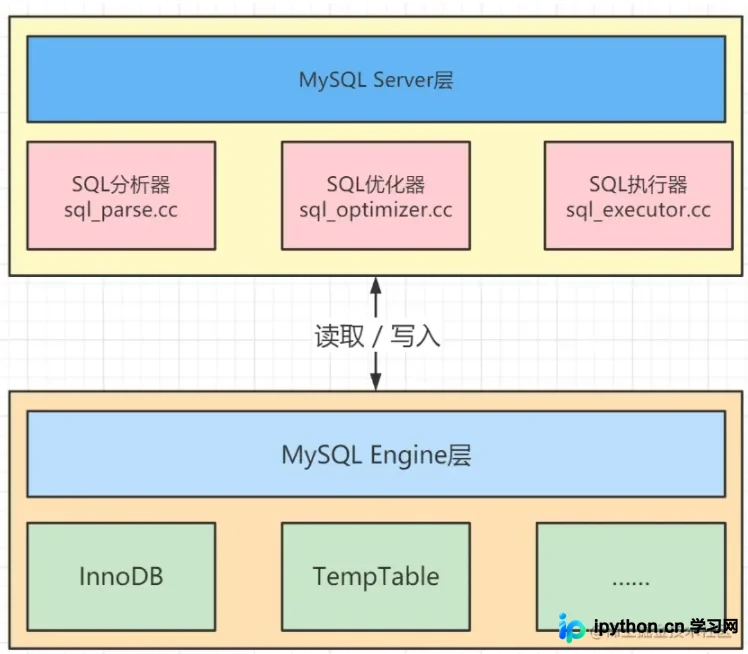
本文深入解析MySQL查询优化器(CBO)的选择机制,详解Server层与Engine层的职责划分。通过SQL成本模型(CPU+IO)说明索引筛选依据,并结合EXPLAIN JSON输出解读read_cost等关键指标,帮助理解SQL执行全过程以优化数据库性能。
本文介绍利用Python将大型CSV数据文件高效写入MySQL数据库的方法。重点解析pd.io.sql.to_sql()函数的使用,包括create_engine连接参数配置及if_exists选项(append、fail、replace)的区别。通过上海公交卡数据实例,展示如何避免内存拥堵并实现数据持久化存储。

本教程详解MySQL单表查询的核心操作,涵盖基础字段选取、条件筛选(含模糊查询)、结果排序、聚合函数统计、多条件分组及分页限制。通过建表实例与具体代码演练,帮助开发者掌握高效检索数据库数据的完整方法,满足日常数据展示与分析需求。
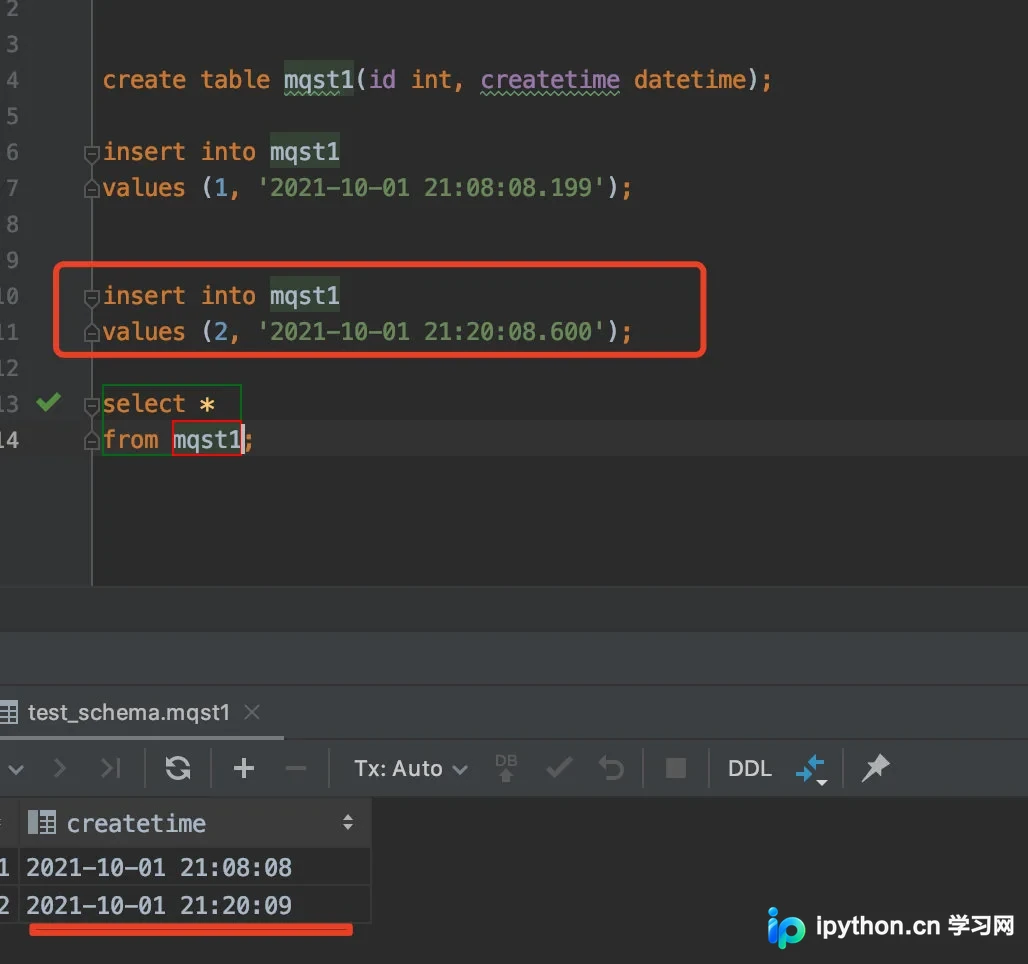
本文解析 MySQL DateTime 字段在处理高精度时间时的精度丢失问题。通过实例说明,当存储精度低于传入值时,数据会四舍五入;在查询范围判定时,若字符串转换超出字段最大精度(6位),可能导致边界值意外匹配或遗漏。建议统一设置精度为6以提升兼容性并避免查询误差。
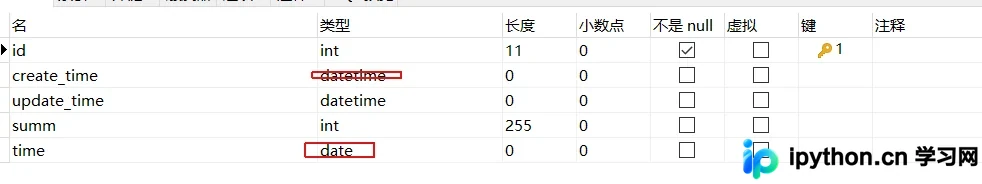
本文详解MySQL中date与datetime类型的时间大小比较方法及常见查询坑点。针对datetime字段,介绍通过 unix_timestamp() 转换为时间戳直接比较,或使用 date_format() 格式化后范围查询的正确姿势,避免遗漏数据。同时说明date类型可直接比较的特性,帮助开发者写出准确高效的SQL语句。
针对 SQL Server 日志文件 (.ldf) 占用过大磁盘空间的问题,本文提供通过修改数据库恢复模式并执行 DBCC SHRINKFILE 命令来释放未使用空间的详细方法。操作需切换至简单模式截断日志,收缩后再恢复完整模式,以兼顾空间回收与数据安全。
本文深入解析 SQL 中 AND、OR、NOT 运算在遇到 NULL 值时的真值表逻辑。通过三值逻辑(TRUE/FALSE/NULL)揭示查询条件的真实结果,并说明 BETWEEN 和 IN 子句在 NULL 场景下的行为。文章指出标准 NULL 测试应使用 IS [NOT] NULL,以确保查询结果的准确性。
本文详细解析 MySQL 8.0 环境下的主从复制配置流程。涵盖主库 server-id 设置、只读权限管理、专用复制账号创建及 binlog 坐标查看;重点区分了 MySQL 8.0.23 前后版本的语法差异(如 CHANGE REPLICATION SOURCE vs CHANGE MASTER),提供从库完整配置命令及状态检查方法,确保数据同步稳定运行。