

MySQL单表查询核心语法与实战指南

在软件开发中,将数据库中的信息提取并展示给用户是高频需求。掌握MySQL单表查询,需要理解从字段选择到条件过滤、排序、聚合、分组以及分页限制的完整流程,以确保查询既准确又高效。
查询操作的基础准备
在进行进阶查询之前,首先需要明确一条完整 SQL 查询语句的逻辑结构,其执行顺序大致如下:
SELECT:指定要返回的列。FROM:指定数据来源表。WHERE:进行行级过滤。GROUP BY:按列分组。HAVING:对分组后的结果进行过滤。ORDER BY:设定排序规则。LIMIT:限制返回的记录数量。
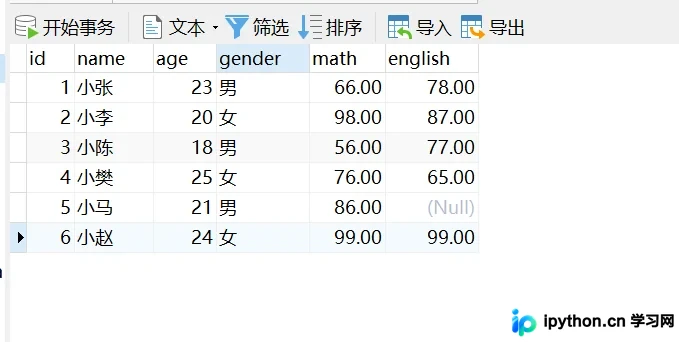
为了演示以下所有查询操作,我们建立一张包含学生信息的测试表 stu,并向其中插入若干记录:
-- 1. 如果存在同名表则删除
DROP TABLE IF EXISTS stu;
-- 2. 创建表结构
CREATE TABLE stu (
  id int,
  name varchar(10),
  age int,
  gender varchar(5),
  math double(5,2),
  english double(5,2)
);
-- 3. 填充测试数据
INSERT INTO stu(id,name,age,gender,math,english)
VALUES
(1,'小张',23,'男',66,78),
(2,'小李',20,'女',98,87),
(3,'小陈',55,'男',56,77),
(4,'小樊',20,'女',76,65),
(5,'小马',20,'男',86,NULL),
(6,'小赵',57,'男',99,99);
在数据库中成功执行上述脚本后,可得到如下初始状态:
第1步:基础查询操作
基础查询用于从表中获取特定或全部的数据列。掌握去重和别名有助于提升可读性。
选取指定字段与全部字段
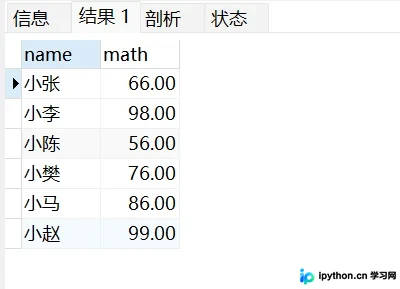
若只需查看学生的姓名和数学成绩,可以使用逗号分隔字段名:
SELECT name, math FROM stu;
运行结果仅显示对应两列:
若需获取该表所有的字段和数据,直接使用通配符 *:
SELECT * FROM stu;
去除重复与起别名
当某一列存在多条完全相同的记录时,可使用 DISTINCT 关键字消除重复值。
例如:SELECT DISTINCT gender FROM stu;
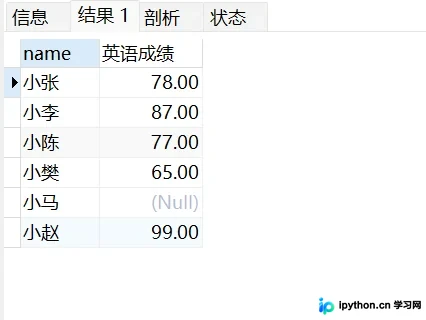
在查询过程中,为了方便前端展示,可以为字段设置别名。使用 AS 关键字或直接空格连接均可。
示例:SELECT name, english AS "英语成绩" FROM stu;
结果中 english 列将显示为自定义标题:
第2步:条件查询与筛选
实际业务中极少返回全表数据,必须通过 WHERE 子句定义严格的过滤条件。
基本比较运算符
支持大于 (>)、小于 (<)、等于 (=)、不等于 (<> 或 !=) 等运算。结合逻辑运算符 AND 与 OR 可组合复杂条件。
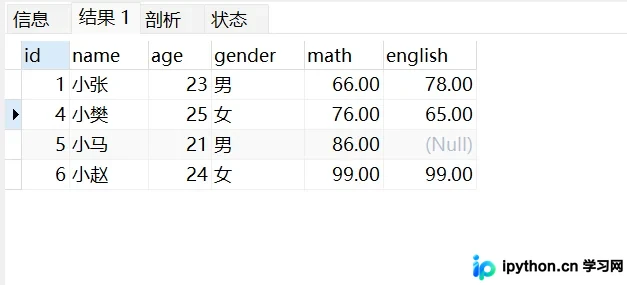
例如,查询年龄严格大于20岁的学生:
SELECT * FROM stu WHERE age > 20;
结果排除了20岁以下的记录:
范围与多选匹配 (IN / BETWEEN)
当需要在多个离散值中查找数据时,使用 IN 比多个 OR 更清晰。
查询年龄在18、20或21岁的学生:
SELECT * FROM stu WHERE age IN (18, 20, 21);
同时匹配的结果展示如下:
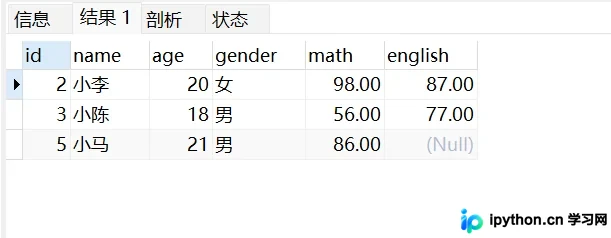
此外,BETWEEN ... AND ... 可用于指定闭区间范围内的数值筛选。
空值判断
NULL 无法用 = 判断,必须使用专用关键字:
IS NULL 或 IS NOT NULL。
模糊查询 (LIKE)
在处理字符串文本时,利用 LIKE 配合通配符非常实用:
%:代表任意长度的任意字符。_:仅代表单个任意字符。
若要查找名字中包含“张”字的学生,采用前后夹击的通配符模式:
SELECT * FROM stu WHERE name LIKE '%张%';
精准命中目标学生信息:
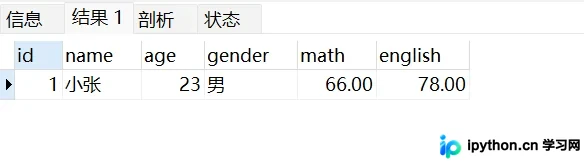
第3步:数据排序 (ORDER BY)
默认的查询结果是无序的,使用 ORDER BY 可以对输出流进行重排。
基本语法:指定排序字段及升降序方向。默认方向为升序 (ASC),降序需显式标注 DESC。
例如,按照数学成绩从高到低排列:
SELECT * FROM stu ORDER BY math DESC;
此操作通常配合其他过滤条件一起使用,以快速定位排名靠前的数据。
第4步:聚合函数统计
针对整列数据进行汇总计算时,需要使用内置聚合函数。这类函数忽略单行数据,作用于整个列集。
常用聚合函数列表
| 函数 | 作用说明 |
|---|---|
COUNT() | 统计记录总行数(注意 NULL 处理方式) |
MAX() | 获取列内的最大值 |
MIN() | 获取列内的最小值 |
SUM() | 求和运算 |
AVG() | 计算平均值 |
重要提示:所有聚合函数在执行时会自动跳过值为 NULL 的单元格。因此在统计行数时,推荐优先使用主键或自增字段(如 id),或者使用 *,以避免因个别空值导致计数偏差。
练习示例:统计与平均分
使用 COUNT 获取学生总数,这里使用主键 id 确保准确性:
SELECT COUNT(id) FROM stu;
系统返回当前表的总行数:
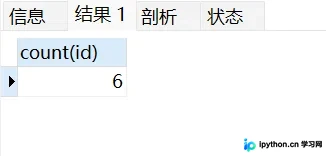
若想确认所有列均非空时的计数效果,可对比:
SELECT COUNT(*) FROM stu;
接下来计算某科目的平均表现。由于小马可用的英语成绩为 NULL,直接对英文科算平均值会导致分母变化(具体取决于数据库实现,但在多数引擎中自动排除Null行):
SELECT AVG(math) FROM stu;
屏幕呈现剔除异常值后的最终平均分值:
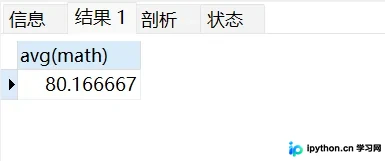
第5步:分组统计 (GROUP BY)
当需要根据某种属性(如性别、班级)将数据归类并进行批量统计时,使用分组查询。
标准流程:先由 WHERE 做初步粗筛 -> 再由 GROUP BY 分类 -> 最后使用 HAVING 做细筛。
语法结构与关键差异
WHERE 发生在分组前,因此不能在其中使用聚合函数进行判断。而 HAVING 发生在分组和聚合计算之后,专门用于过滤组内统计数据。
综合练习:跨维度统计
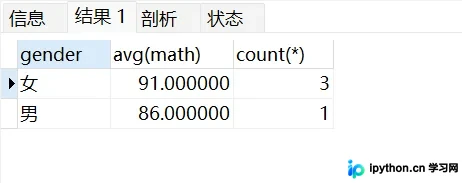
任务要求:统计男生和女生各自的数学平均分及人数,且只计入数学成绩大于70分的同学;并且在分组完毕后,剔除掉人数不足2人的类别。
步骤分解:
- 使用
WHERE math > 70滤除低分考生。 - 使用
GROUP BY gender按性别拆分。 - 使用聚合函数
AVG(math)和COUNT(*)获取组内指标。 - 使用
HAVING COUNT(*) > 2过滤掉人数少于2人的组。
合并后的 SQL 语句如下:
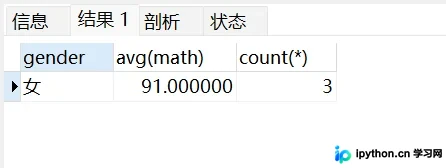
SELECT gender, AVG(math), COUNT(*) FROM stu WHERE math > 70 GROUP BY gender HAVING COUNT(*) > 2;
此时控制台展示出符合条件的汇总报表:
倘若修改阈值去掉 HAVING 的限制,即可看到原始分组下的详细状况:
第6步:分页查询控制 (LIMIT)
面对海量数据时,一次性加载会导致严重的性能损耗。分页查询通过在 SQL 尾部追加 LIMIT 关键字,每次只向客户端推送一页所需数据。
双参数语法:LIMIT 起始偏移量, 每页条目数。
- 起始偏移量 (Offset):指从第几条开始取。因为计算机索引从 0 起算,所以取第一页第一条数据的偏移量为 0。
- 每页条目数 (Count):本次请求返回的最大行数。
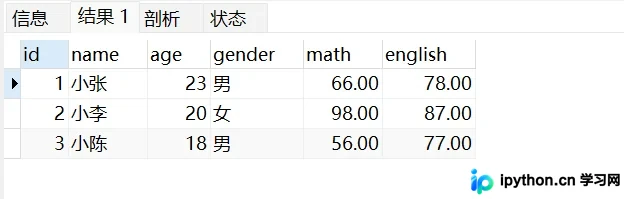
例如,直接从索引 0 开始,截取前 3 条记录:
SELECT * FROM stu LIMIT 0, 3;
系统将精确返回这三条最新的数据切片:
在实际网页开发中,公式通常为:
起始索引 = (当前页码 - 1) × 每页显示条数
例如查询第 3 页(假设每页 3 条),则索引应为 (3-1)*3 = 6,即传入 LIMIT 6, 3。
总结
通过上述六个维度的梳理,我们构建了完整的 MySQL 单表检索知识体系。从简单的字段读取到复杂的嵌套条件筛选、动态排序、分组聚合以及大数据量下的分页处理,每一步都紧密相关。熟练掌握这些底层逻辑,是开发高性能后端应用的前提。建议在本地环境中反复修改参数进行测试,以加深记忆。
以上就是 MySQL 单表查询进阶与实操的详细内容,更多关于 MySQL 高级查询技巧的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









