

ClickHouse常用表引擎详解:MergeTree家族与日志引擎
本文详细讲解ClickHouse的核心表引擎,重点分析MergeTree家族的ORDER BY、PRIMARY KEY及分区策略,阐述TTL机制管理数据生命周期,并介绍ReplacingMergeTree与SummingMergeTree在去重和聚合场景的应用,最后对比TinyLog、Memory等小型引擎的特性。
2026-10-15
7
本文详细讲解ClickHouse的核心表引擎,重点分析MergeTree家族的ORDER BY、PRIMARY KEY及分区策略,阐述TTL机制管理数据生命周期,并介绍ReplacingMergeTree与SummingMergeTree在去重和聚合场景的应用,最后对比TinyLog、Memory等小型引擎的特性。
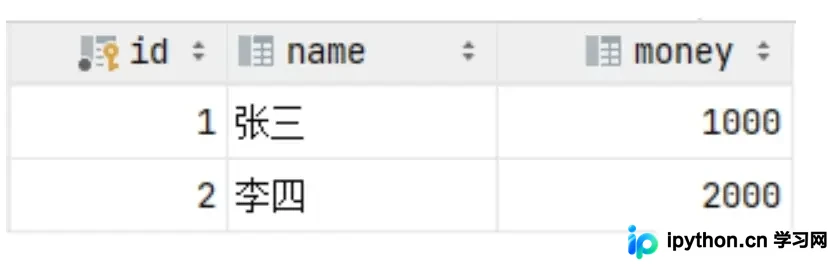
本文讲解 MySQL 中事务控制的两种常用方法:修改自动提交开关和使用 START TRANSACTION 手动管理。通过转账案例演示操作失误后的数据恢复,并详细解析事务四大特性(ACID)及并发处理中的脏读、不可重复读和幻读现象及其成因。
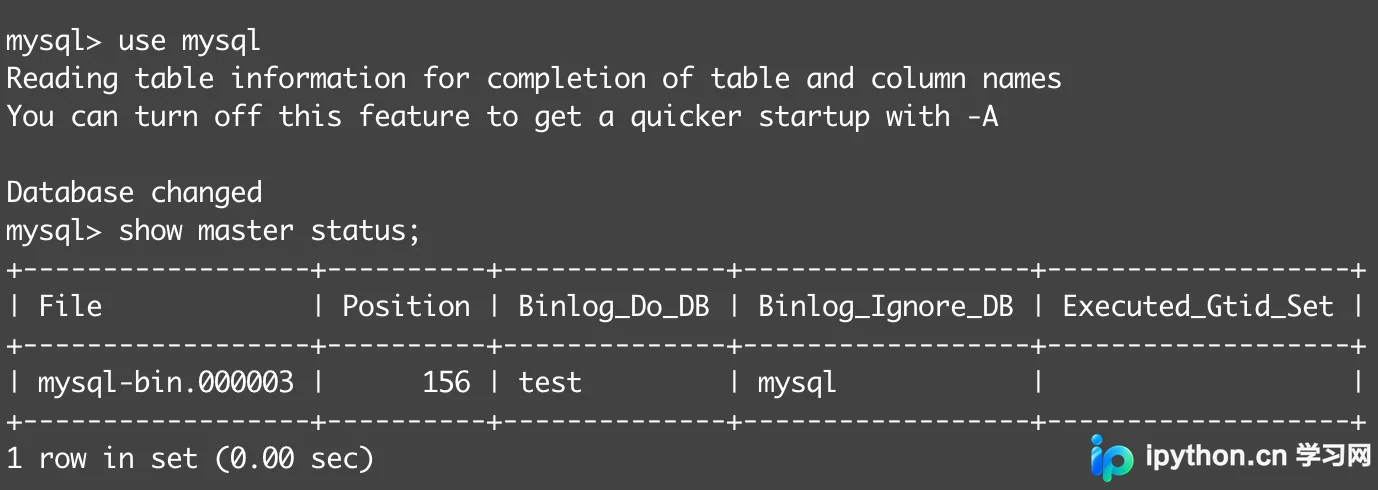
本文详述在Ubuntu环境下搭建MySQL 8.0主从复制的完整流程。涵盖基础安装、主库binlog配置与备份快照、从库数据导入及Slave状态初始化,通过具体命令和配置文件参数,实现数据库数据的实时异步同步,确保数据安全与读写分离基础。
在 SQL Server 中,普通唯一索引允许重复的 NULL 值,无法满足“非空值唯一”的需求。本文介绍了三种解决方案:利用带逻辑判断的自定义函数配合 CHECK 约束(适用于所有版本),以及使用 SQL Server 2008 及之后版本的筛选索引功能(推荐)。筛选索引通过 WHERE 子句仅对非空行建立唯一索引,语法简洁且性能更优。
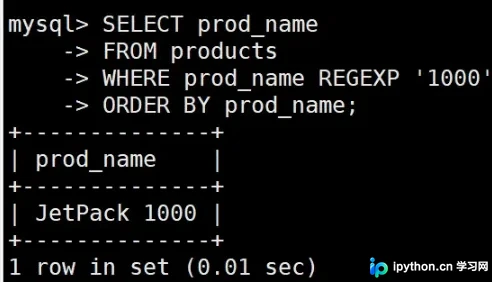
本文详细介绍如何在MySQL中使用REGEXP操作符进行灵活的字符串匹配。涵盖基本字符匹配、OR逻辑(|)、字符集合([ ])、特殊字符转义、字符类、重复元字符及定位符(^ $)的使用方法与注意事项,并对比了LIKE与REGEXP的区别,助力精准检索数据库字段。
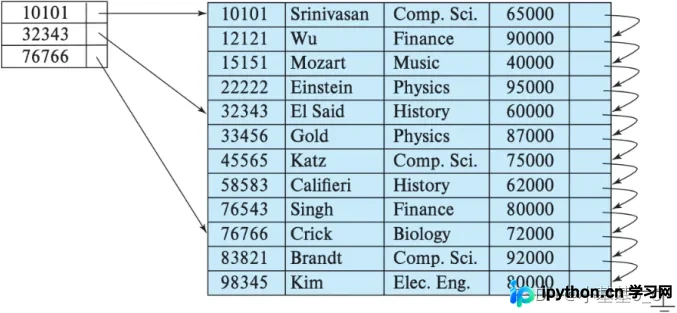
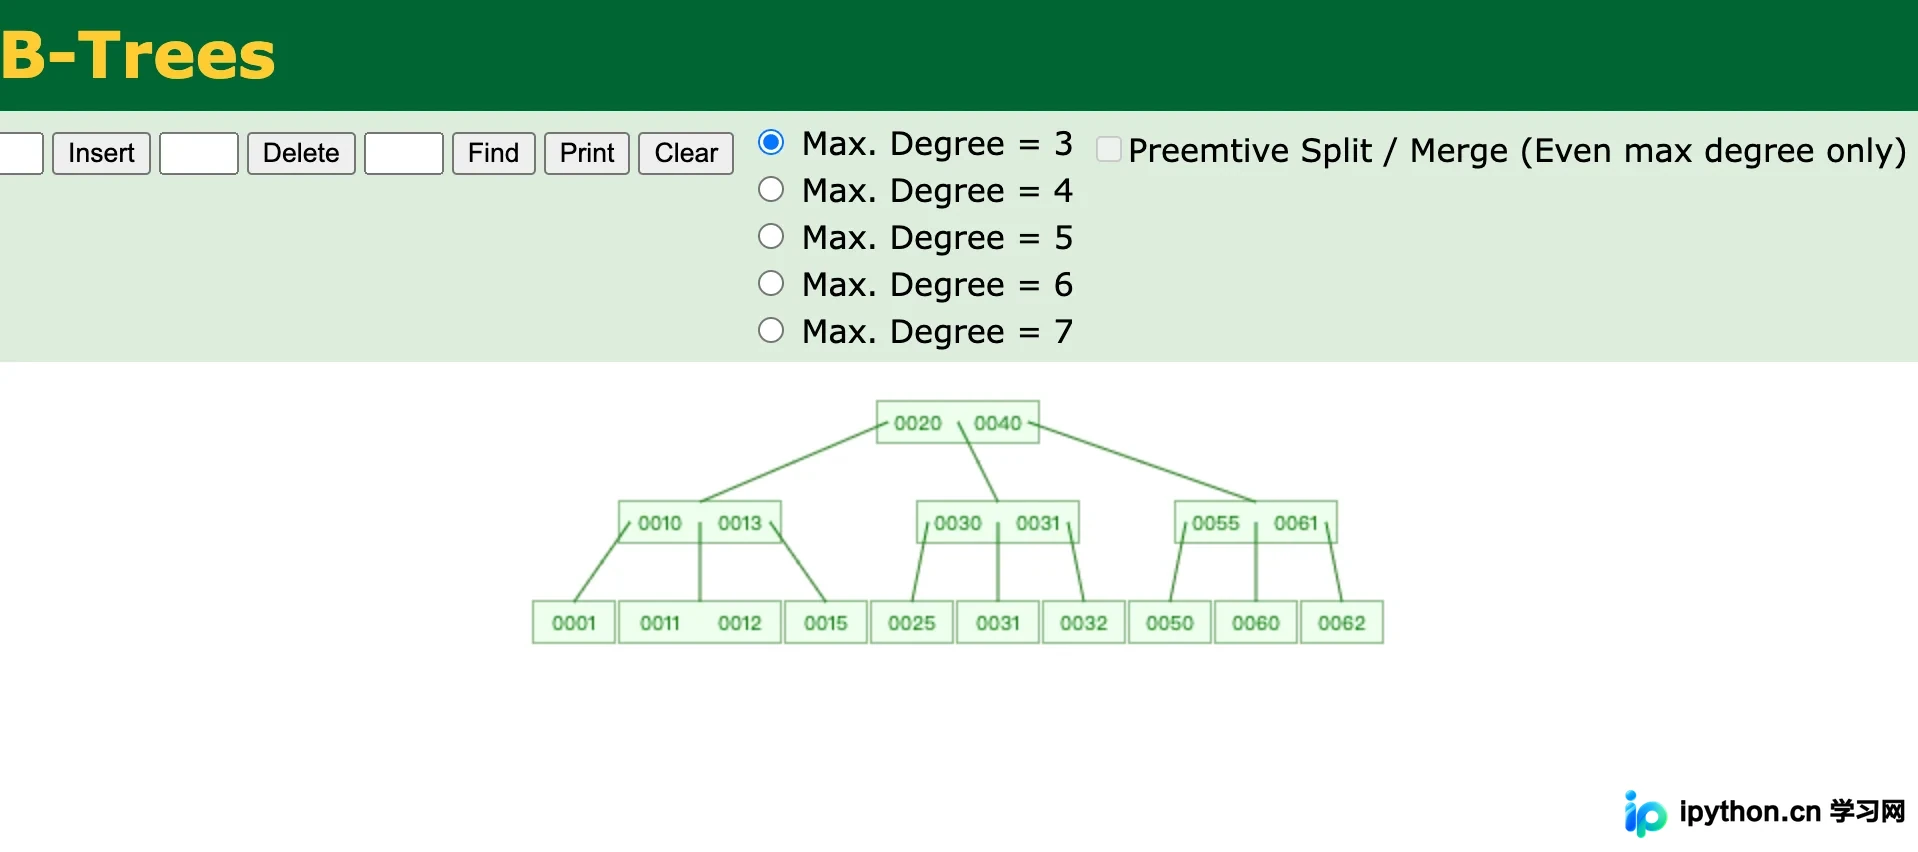
深入解析MySQL索引底层数据结构,对比B-Tree与B+Tree在存储机制、查询效率及I/O次数上的差异。重点阐述B+Tree如何通过非叶子节点仅存键值、降低树高及范围查询特性,成为InnoDB默认索引结构的原因。
MySQL因连接错误数超过阈值触发ERROR 1129导致主机被封锁。可通过执行FLUSH HOSTS命令即时清除缓存,或修改配置文件my.ini中的max_connect_errors参数提高阈值。本文提供命令行与配置文件的完整解决方案。
本文深入解析MySQL中利用WHERE子句进行数据过滤的核心操作。涵盖比较运算符、范围查询(BETWEEN)及空值判断(IS NULL)的具体用法,重点阐述服务端SQL过滤优于应用层过滤的性能优势,并详细说明字符串引号使用规范及NULL值在匹配与非匹配查询中的特殊表现,帮助开发者编写高效且准确的SQL语句。
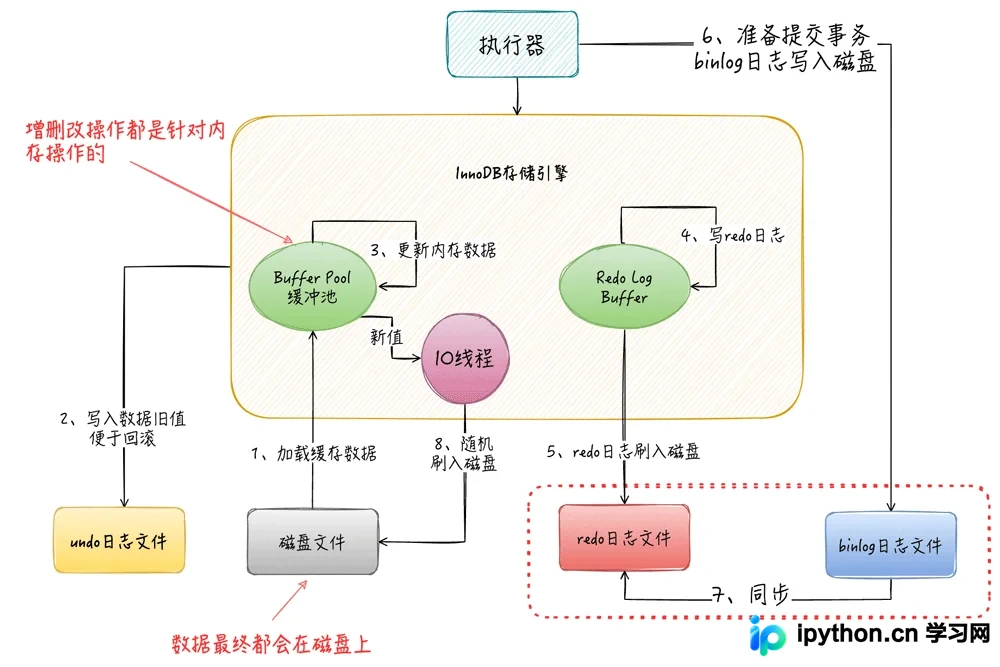
MySQL InnoDB 引擎通过 Buffer Pool 缓存磁盘数据以提升性能。本文解析其内部结构,包括 16KB 标准数据页的映射机制、描述元数据的存储位置及占比(约5%),以及脏数据恢复原理。同时提供生产环境中根据服务器内存合理调整 innodb_buffer_pool_size 的配置方法。
本文详解MySQL元数据管理机制及用户账户全流程操作,涵盖创建、修改密码、授权与撤销权限等核心命令。同时对比分析InnoDB、MyISAM等主流存储引擎特性,帮助开发者根据事务需求与读写场景选择合适配置,确保数据库安全与性能优化。
在MySQL开发中,当需要根据参数动态调整SQL查询条件时,若不使用存储过程或拼接SQL字符串,可采用IF()函数简化逻辑。本文通过实例演示如何利用IF(expression, true_expr, false_expr)结合默认值占位符,在WHERE子句中实现多条件过滤或全量查询的灵活切换。
MySQL报错Error 1071通常因唯一索引涉及字段总长度超过InnoDB最大键长3072字节引起。可通过设置innodb_large_prefix和innodb_file_format参数放宽限制,或调整字段类型、缩减varchar长度等优化手段解决。本文提供具体的参数修改与代码修正方案。