

MySQL中DISTINCT与GROUP BY去重差异及性能测试

在使用MySQL进行数据去重时,许多开发者首选DISTINCT关键字,但在处理复杂查询(如需要返回非去重字段)时往往会遇到意外结果。本文将对比DISTINCT与GROUP BY的底层逻辑差异,并通过实际代码演示错误原因,最后提供基于真实数据的性能测试结论。
DISTINCT与GROUP BY的业务逻辑差异
在业务开发中,当我们需要对某几列数据去重时,首先想到的通常是DISTINCT。然而,它的使用有其严格的限制:
1. DISTINCT的特性
DISTINCT的作用是对SELECT列表中的所有字段组合进行去重。只有当列表中所有字段的值完全相同时,才会被判定为重复记录并合并为一行。
- 单列去重:仅指定一列时,简单有效,相同值只保留一个。
- 多列去重:若指定多列,必须这些列的组合完全一致才算重复。如果在
SELECT中包含了主键(如id),由于主键唯一性,DISTINCT实际上将不起任何去重作用。
2. GROUP BY的优势
GROUP BY的核心功能是按照指定字段进行分组,并通常配合聚合函数使用。但在没有聚合函数的情况下,它也可以用于去重。
- 可以根据部分字段(如
project_id)进行分组去重。 - 在分组后,MySQL通常会从每组中选取第一条记录的其余字段(如
company_name、id等)返回,这使得它在需要“保留分组依据字段外的其他详细信息”的场景下比DISTINCT更灵活。
实战案例:为什么我的DISTINCT没去重?
在基于MyBatis-Plus的实际开发中,我们常遇到如下困境:
场景:查询项目公司的去重数据,但希望同时返回project_id、company_id等非主键信息。
错误尝试一:仅DISTINCT非主键字段
QueryWrapper<ProjectCompany> wrapper = new QueryWrapper<>();
// 注意:这里只选了去重相关的业务字段,未选主键id
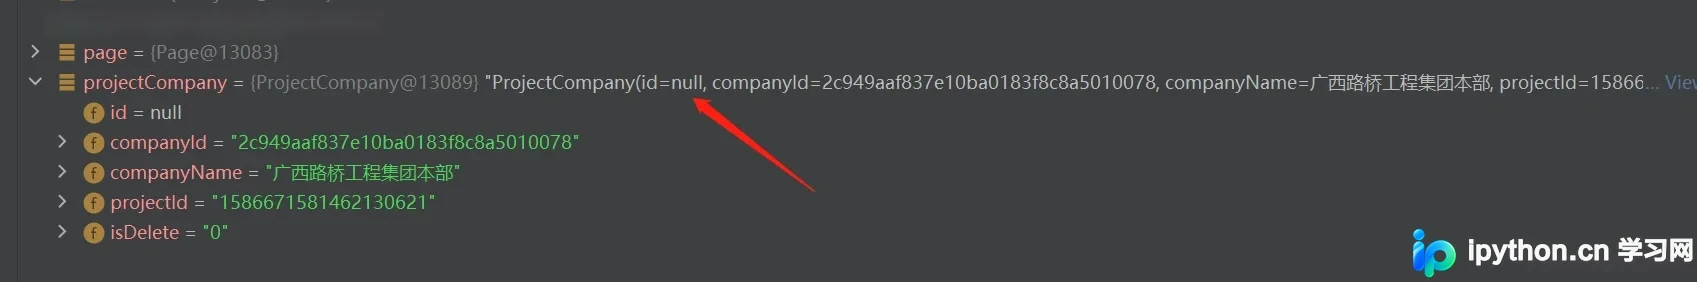
wrapper.select("DISTINCT project_id,company_id,company_name,is_delete")
       .eq("project_id", projectId)
.eq("is_delete", "0");上述代码执行后,返回的结果集可能为空或id为null(取决于ORM框架处理)。这是因为业务上的“重复”是基于这几列定义的,但数据库表中每行有唯一的id。如果我们不在SELECT中包含id,返回的对象属性映射会出现混乱,导致后续业务逻辑无法获取正确的记录ID。
错误尝试二:DISTINCT包含主键id
若在select中加入id,即
"DISTINCT id,project_id,...",由于id唯一,查出的数据将是全部数据,DISTINCT失效。
正确方案:使用GROUP BY
当我们只需要根据project_id去重,且需要获取对应的公司信息时,使用GROUP BY是更稳妥的选择。
LambdaQueryWrapper<ProjectCompany> wrapper = new LambdaQueryWrapper<>();
wrapper.eq(ProjectCompany::getProjectId, projectId)
       .eq(ProjectCompany::getIsDelete, "0")
       .groupBy(ProjectCompany::getProjectId);
这种方式能确保以project_id为组,并自然带回该组中的其他字段(如id),既实现了去重目的,又保留了业务所需的完整对象信息。
DISTINCT与GROUP BY的性能对比实验
很多观点认为DISTINCT比GROUP BY快,或者反之。为了验证这一点,我们在MySQL 5.7.17环境下进行了基准测试。实验排除了缓存干扰,主要考察在不同索引情况和不同离散度下的执行时间。
1. 测试环境准备
- 数据库版本:MySQL 5.7.17
- 存储引擎:InnoDB
- 测试表结构:每个表包含
id(自增主键)和value(测试字段)。 - 数据量:10万条记录(
tab_1至tab_4)。
2. 实验变量设计
| 表名 | 记录数 | 查询字段有无索引 | 不同值个数(离散度) |
|---|---|---|---|
| tab_1 | 100,000 | No | 3 (低离散度) |
| tab_2 | 100,000 | Yes (idx_value) | 3 (低离散度) |
| tab_3 | 100,000 | No | 10,000 (高离散度) |
| tab_4 | 100,000 | Yes (idx_value) | 10,000 (高离散度) |
3. 生成数据的SQL过程
使用存储过程批量插入随机整数,确保数据分布符合预期。
-- 创建带索引和无索引的两类基础表
DROP TABLE IF EXISTS `tab_1`;
CREATE TABLE `tab_1` (
  `id` int(10) unsigned NOT NULL AUTO_INCREMENT,
  `value` int(10) unsigned NOT NULL,
  PRIMARY KEY (`id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8;

DROP TABLE IF EXISTS `tab_2`;
CREATE TABLE `tab_2` (
  `id` int(10) unsigned NOT NULL AUTO_INCREMENT,
  `value` int(10) unsigned NOT NULL,
  PRIMARY KEY (`id`),
  KEY `idx_value` (`value`) -- 建立索引
) ENGINE=InnoDB DEFAULT CHARSET=utf8;

-- 复制表结构生成tab_3和tab_4
DROP TABLE IF EXISTS `tab_3`;
CREATE TABLE `tab_3` LIKE `tab_1`;

DROP TABLE IF EXISTS `tab_4`;
CREATE TABLE `tab_4` LIKE `tab_2`;
-- 调用存储过程填充数据
-- tab_1/tab_3无索引,tab_2/tab_4有索引
call generateRandomData('tab_1','value',3,100000);   -- value取值只有1,2,3
INSERT INTO tab_2 SELECT * FROM tab_1;

call generateRandomData('tab_3','value',10000,100000); -- value取值1~10000
INSERT INTO tab_4 SELECT * FROM tab_3;
4. 测试结果数据
| 表名 | 索引情况 | DISTINCT耗时 | GROUP BY耗时 |
|---|---|---|---|
| tab_1 | 无索引 | 0.058s | 0.059s |
| tab_2 | 有索引 | 0.030s | 0.027s |
| tab_3 | 无索引 | 0.072s | 0.073s |
| tab_4 | 有索引 | 0.047s | 0.049s |
结果分析:
- 性能几乎一致:在所有测试场景下,
DISTINCT和GROUP BY的执行时间差均在毫秒级别(甚至更小),在实际生产环境的感知中无明显区别。 - 索引的影响显著:启用索引后,两者的速度均有大幅提升(例如从0.072s降至0.047s左右)。
- 离散度的影响:不同值的数量增加会导致全表扫描时的去重成本略微上升,但对于百万级以下的数据量,这种差异可忽略不计。
总结与建议
如何选择?
- 如果只需单纯过滤掉重复行,且返回所有列,两者皆可,优先使用
DISTINCT语义更直观。 - 如果需要按某些字段去重,同时保留其他字段的具体值(如最近的一条、金额最大的一条等),**强烈建议使用
GROUP BY**。对于复杂的多字段关联去重,通常还需要结合ROW_NUMBER()窗口函数或子查询优化来实现,单纯的DISTINCT无法满足“取特定行”的需求。
性能建议:
无论使用哪种方式,确保去重涉及的字段上有合适的索引,是提升查询效率最关键的手段。在不涉及大量聚合运算的场景下,不必纠结于DISTINCT和GROUP BY的微秒级性能差异,应根据代码可读性和业务需求的灵活性进行选择。
以上就是MySQL中去重操作DISTINCT和GROUP BY的区别浅析及性能测试的详细内容,更多关于MySQL去重技巧与优化的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









