

Python爬虫实战:Requests模块GET请求参数与请求头处理详解
本文详解Python中Requests模块发起GET请求的两种常见场景:携带查询参数与自定义请求头。通过搜狗首页及搜索接口的实战代码,演示如何利用params字典传递URL参数,以及通过headers参数设置User-Agent以模拟浏览器访问,帮助开发者掌握基础爬虫请求构造技巧。
2026-10-13
12
本文详解Python中Requests模块发起GET请求的两种常见场景:携带查询参数与自定义请求头。通过搜狗首页及搜索接口的实战代码,演示如何利用params字典传递URL参数,以及通过headers参数设置User-Agent以模拟浏览器访问,帮助开发者掌握基础爬虫请求构造技巧。
本文介绍了使用Python实现某论坛自动签到功能的方法。通过模拟用户登录和请求,实现了自动签到功能。文章提供了完整的Python代码示例,并详细解释了代码的实现过程。
本文介绍使用Python zipfile模块批量解压ZIP文件的脚本实现。重点解决中文文件名乱码问题,通过修改源码将cp437编码替换为gbk。提供完整代码示例,包含解压、去重及清理功能,并强调测试备份的重要性。
本文详解Python爬虫中User-Agent(UA)的作用及反爬原理。通过对比默认urlopen与自定义Request对象,演示如何获取浏览器UA并封装进headers字典,成功伪装爬虫身份以绕过网站检测。包含搜狗搜索抓包获取UA及完整代码示例,帮助开发者解决基础反爬问题。
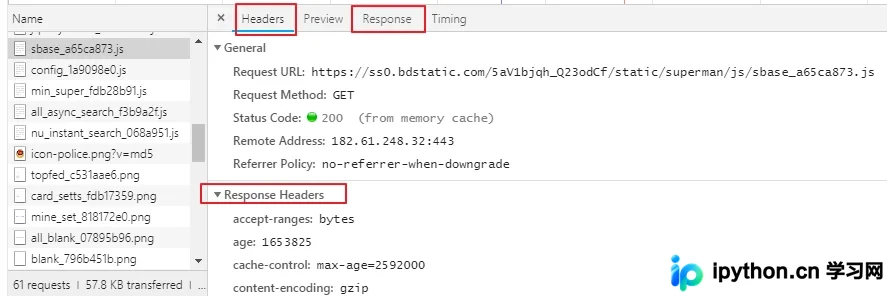
本文深入解析 Python 中非阻塞 IO 模型的工作原理,通过 Linux Socket 示例展示如何设置非阻塞模式及处理 BlockingIOError 异常。文章详细阐述了非阻塞 IO 在单线程并发中的应用,指出了 send 阻塞及 CPU 占用过高等缺陷,并引出 select 多路复用作为更优解决方案。
本文详解Python中logging模块的日志滚动机制,重点介绍TimeRotatingFileHandler的使用。通过配置when、interval和backupCount参数实现按时间周期生成日志文件,并解析suffix与extMatch正则匹配规则,确保过期日志能被正确清理,避免磁盘空间耗尽。
本文详细介绍Python中列表的核心操作方法。涵盖列表的创建与类型检查,讲解使用+号拼接、append()与extend()添加元素的区别,以及乘法运算对列表的影响。同时深入解析insert()插入、索引访问、元素交换、index()查找及remove()/del()删除等关键功能,帮助开发者掌握列表的高效使用技巧。
本文深入解析Python multiprocessing模块中Process对象的join方法。通过对比主进程独立运行与依赖子进程结果的两种场景,阐明join用于阻塞主进程直至子进程结束的核心机制。重点澄清常见误区:多次调用join不会导致子进程串行执行,总耗时取决于最长子进程。通过代码示例展示并发与串行调用的时间差异,帮助开发者正确使用join进行资源回收和流程控制。
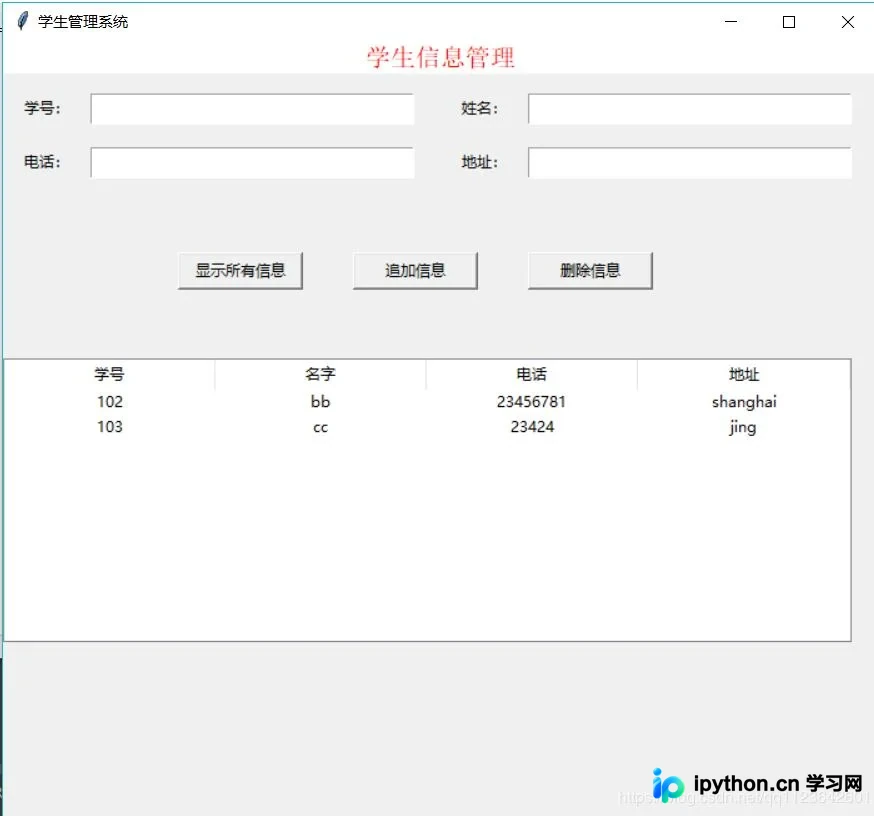
本文提供基于Python和Tkinter库构建的学生管理系统完整代码。系统利用SQLite进行数据存储,通过图形界面实现学号、姓名、电话及地址的录入与展示,包含界面布局、变量绑定及数据表格控件配置,适合Python初学者参考学习GUI应用开发。
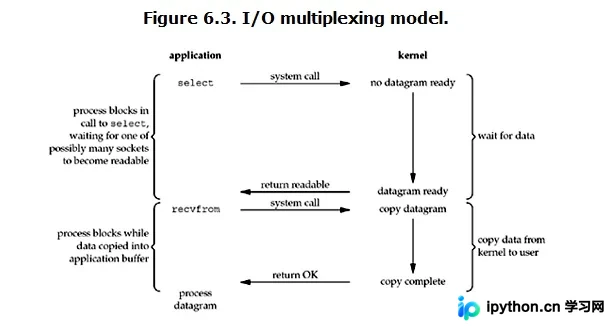
本文深入解析Python中的多路复用IO模型,重点阐述Select机制的工作原理。通过对比阻塞IO与非阻塞IO,说明Select如何在单进程中高效处理多个网络连接。文章包含Select函数的使用示例、底层fd监听机制分析,并探讨其局限性及Epoll等替代方案,帮助开发者理解高并发场景下的IO处理策略。
本文深入解析Django内置User模型的字段与验证机制,并详细对比四种扩展用户模型的方法:Proxy模型、一对一外键、继承AbstractUser及继承AbstractBaseUser。重点说明各方案的适用场景、代码实现及settings配置,帮助开发者根据需求选择最优的用户管理策略。
本文介绍如何在Python交互控制台中启用Tab键自动补全功能,并通过配置环境变量PYTHONSTARTUP实现自定义清屏命令。通过创建启动脚本,用户可在进入Python环境时自动加载readline模块及自定义函数,提升开发效率与体验。