


Python中合并字典相同Key对应Value的两种实现方法
本文介绍了在Python中如何处理字典(dict)中相同Key对应的Value合并问题。通过具体代码示例,展示了利用setdefault方法简化逻辑以及常规遍历更新两种实现方式,帮助开发者更高效地处理数据聚合场景。
2026-10-13
10
本文介绍了在Python中如何处理字典(dict)中相同Key对应的Value合并问题。通过具体代码示例,展示了利用setdefault方法简化逻辑以及常规遍历更新两种实现方式,帮助开发者更高效地处理数据聚合场景。
本文介绍在Python中合并两个字典并累加相同键对应值的两种方法。第一种为手动遍历字典进行判断与累加,执行效率较高;第二种利用collections模块的Counter类,通过加法运算合并,代码简洁但速度相对较慢。
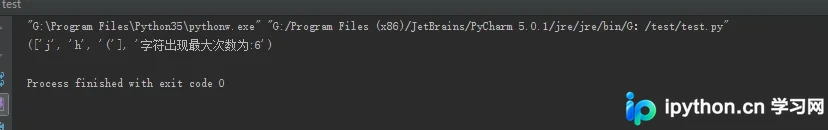
本文介绍在Python中统计字符串出现次数最多字符的两种实现方式。第一种方法通过遍历构建列表,能返回所有并列最高频的字符及次数,逻辑更严谨;第二种方法利用max函数配合count参数,代码极简但仅返回首个匹配字符。文中还附带了在线字数与字符统计工具的链接,供开发者快速参考。
本文详解Python中字典嵌套的使用方法及递归调用的实现原理。通过决策树构建中的字典嵌套示例,展示如何多层级访问数据;同时以阶乘计算为例,剖析递归函数的执行流程与返回值机制,帮助开发者掌握核心编程技巧。
本文详解Python中浮点数精度误差的成因,并重点介绍如何使用decimal模块进行精确的小数运算。通过对比float与Decimal的行为,演示了字符串参数的重要性、localcontext与getcontext的精度控制用法,以及math.fsum处理大数累加误差的技巧,帮助开发者在金融或科学计算中避免精度丢失。
本文介绍如何使用 Python 的 NumPy 库对二维数组进行按行归一化处理。通过计算每行的最大值与最小值,利用公式 (Z - Zmin) / (Zmax - Zmin) 将数据映射到 0 到 1 区间。文中提供了完整的代码示例,展示了随机生成数组及执行归一化的具体步骤,适用于机器学习中的数据预处理场景。
本文详细解析了Python中将自定义对象设置为可迭代的两种主要实现方式。第一种是通过定义 __getitem__ 方法,利用系统默认从0开始的索引机制实现迭代;第二种是通过实现 __iter__ 和 next 方法,使对象具备生成器般的迭代行为。文章提供了具体的代码示例,帮助开发者理解并应用这两种技术。
本文通过Python代码实测对比了DFA(确定有限状态自动机)算法与普通循环查找算法在敏感词过滤场景下的性能差异。实验结果显示,当敏感词数量较少(如100个)时,普通算法效率更高;而当敏感词库扩大至1000个时,DFA算法的优势显现。文章进一步从理论上推导了两种算法的时间复杂度,指出DFA算法的处理时间与敏感词数量基本无关,主要取决于文本长度和词长,从而明确了DFA算法在大规模敏感词库中的适用场景。
本文介绍如何在Python中根据字典值的数值大小进行过滤。通过示例展示了利用字典推导式结合float()转换与条件判断,筛选出值大于0的键值对。该方法简洁高效,适用于需要基于数值条件清洗或筛选字典数据的场景。
本文介绍如何使用Python实现桌面壁纸的自动切换功能。通过requests库从指定网站抓取图片URL并下载,结合win32api和win32gui模块修改Windows注册表及调用SystemParametersInfo接口,实现定期自动更换壁纸。代码包含完整的抓取、下载及设置流程,适合希望自定义桌面环境的用户参考。
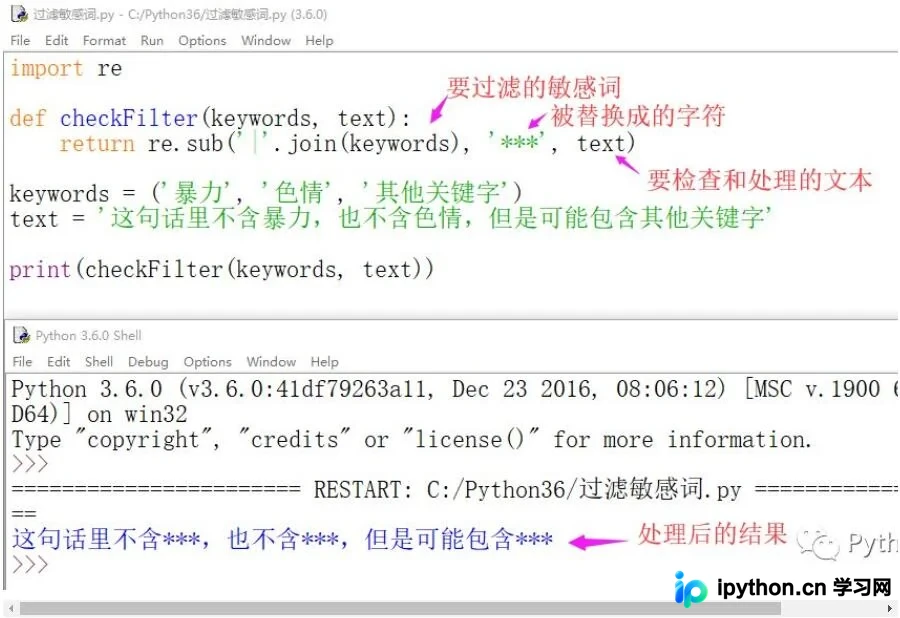
本文介绍如何利用Python的re模块sub()函数结合正则表达式中的竖线“|”语法,实现对用户发帖内容中敏感词的自动检测与字符替换。通过具体代码示例,展示如何高效构建过滤规则,适用于网站内容安全审核场景。
本文介绍如何使用Python的Pillow库实现单通道灰度图像的颜色翻转功能。通过ImageOps模块的invert方法,可以高效完成图像像素值的反向处理,适用于需要灰度图像处理的场景。