Python pandas数据差分运算实战:一阶与二阶差分详解
本文介绍如何利用Python pandas库进行数据差分运算。通过df.diff()方法,可实现纵向一阶、横向一阶及多阶(如periods=2)差分计算。文章包含完整代码示例,展示如何处理空值及不同轴向的差分结果,适用于时间序列分析与特征工程场景。
2026-10-13
9
本文介绍如何利用Python pandas库进行数据差分运算。通过df.diff()方法,可实现纵向一阶、横向一阶及多阶(如periods=2)差分计算。文章包含完整代码示例,展示如何处理空值及不同轴向的差分结果,适用于时间序列分析与特征工程场景。
本文介绍在 Python 中如何高效处理包含连续空格的字符串。通过结合使用 split() 和 join() 方法,可以自动忽略多余空格并将剩余单词用单个空格连接。例如 'line dd' 经处理后变为 ['line', 'dd'],再拼接即可得到规范化的单空格字符串,适用于数据清洗和文本预处理场景。
本文介绍在Python中实现输入数字反向输出的具体方法。通过示例代码展示如何利用循环和取余操作完成数字反转,适用于初学者理解基础算法逻辑与字符串处理技巧。
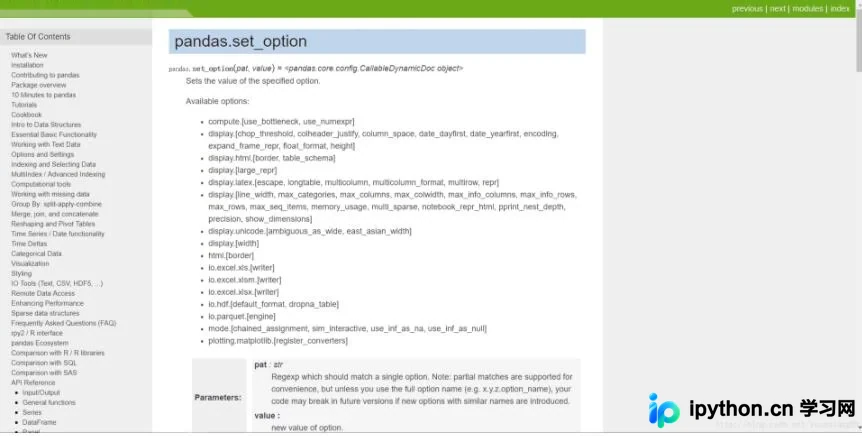
本文介绍在Python中使用Pandas打印Dataframe时,因行数过多导致中间数据显示省略号的问题。通过调用pandas.set_option()函数,配置display.max_rows为None及调整display.width,即可强制输出完整数据,避免信息截断。
本文介绍如何使用Python将TXT文件内容逐行读取并转换为字典对象。通过按空格分割行数据,利用冒号提取键值对,最终生成包含多个字典的列表。代码特别处理了中文字符的编码问题,确保写入新文件时数据格式正确,适合需要批量处理结构化文本数据的场景。
本文介绍在Python3中利用csv模块将CSV文件数据读取并转换为字典格式的具体实现方式。通过示例代码展示了如何打开文件、获取字段名以及逐行处理数据生成字典对象,供开发者参考使用。
本文介绍如何使用Python读取通达信股票数据文件(.day)。通过struct模块解析二进制数据,处理日期、价格及成交量字段,最终将结果封装为pandas DataFrame对象,便于后续数据分析与处理。
本文详解Python 3.x中print函数的格式化输出技巧,涵盖数字与字符串的左右对齐方法。通过%运算符演示右对齐(如%3d、%10.3f)及左对齐(%-3d)的具体用法,解析占位符含义及补零规则,帮助开发者掌握类似C语言printf的格式控制能力,实现精确的输出排版。
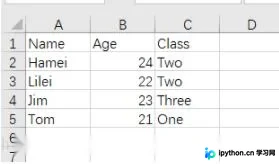
本文介绍在Python中将TXT文件数据读取并转换为NumPy数组或列表的方法。针对包含混合数据的TXT文件,提供逐行处理并转为数组的代码示例;针对纯数字文件,推荐loadtxt直接读取。同时详细解析split和strip函数的语法、参数及实际应用案例,帮助开发者高效处理文本数据。
本文介绍如何在Python3环境中使用pandas和pandas_datareader库获取股票数据。详细记录了安装步骤,并针对运行时报错的ImportError(is_list_like导入失败)和ImmediateDeprecationError(Yahoo Daily弃用)提供了具体的代码修改方案,包括修改fred.py和data.py文件中的导入路径及注释弃用报错语句。
本文介绍在Python中读取TXT文件并提取特定位置字符的方法。通过open函数打开文件,使用readlines()读取所有行,再结合split()方法以固定字符为分隔符进行分割,最后通过索引n获取目标字符串并写入新文件。
本文详细介绍如何使用Python构建基础爬虫架构。通过解析urllib库的网络请求功能与BeautifulSoup的HTML解析能力,演示从导入模块、打开网址到提取节点信息的完整流程。同时涵盖常见错误如HTTPError和None值的排查与处理,帮助开发者掌握基础爬虫的核心步骤与异常处理机制。