


Python批量生成1000个TXT文件的高效实现
本文介绍如何使用Python脚本批量生成1000个TXT文件。通过遍历数字范围并结合文件路径格式化,实现自动化文件创建。文中提供了核心代码示例,并针对Windows与Linux系统下文件创建函数的差异进行了说明,帮助用户快速掌握批量文件处理技巧。
2026-10-13
9
本文介绍如何使用Python脚本批量生成1000个TXT文件。通过遍历数字范围并结合文件路径格式化,实现自动化文件创建。文中提供了核心代码示例,并针对Windows与Linux系统下文件创建函数的差异进行了说明,帮助用户快速掌握批量文件处理技巧。
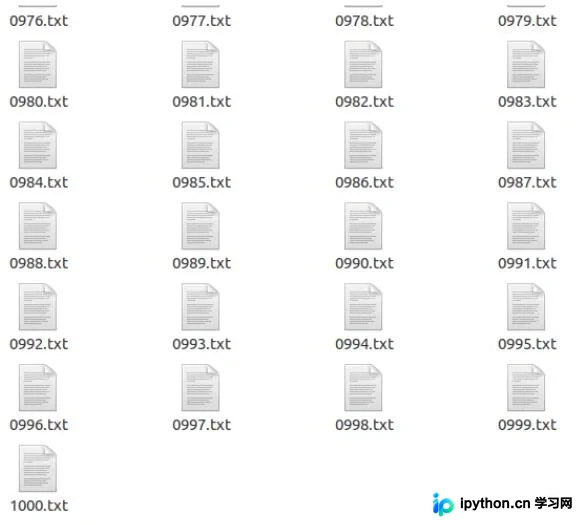
本文介绍如何利用Python循环结构批量生成文本文件。核心难点在于文件名需动态变化,通过将变量转换为字符串并与扩展名拼接,传递给open()函数,即可在循环中为不同数据行创建对应的txt文档并写入内容。
本文介绍如何使用Python脚本对指定文件夹内的图像文件进行连续重命名。通过遍历目录并提取JPG格式文件,程序自动将文件按顺序重命名为从101开始的连续数字。该方法适用于需要整理大量图像资源的场景,代码简洁且易于扩展。
本文介绍利用Python脚本检测项目中未调用的接口方法。通过遍历指定目录下的所有文件,结合正则表达式匹配待查接口名列表,自动识别并输出从未被引用的接口名称至结果文件,辅助代码清理与优化。
本文介绍利用Python脚本批量整理图片文件的实现方法。通过递归遍历深层子文件夹,精准定位并复制特定后缀(如_co.pgm)的文件至目标目录,同时使用xlwt库将采集日期等元数据写入Excel表格,实现文件管理与数据记录的自动化处理。
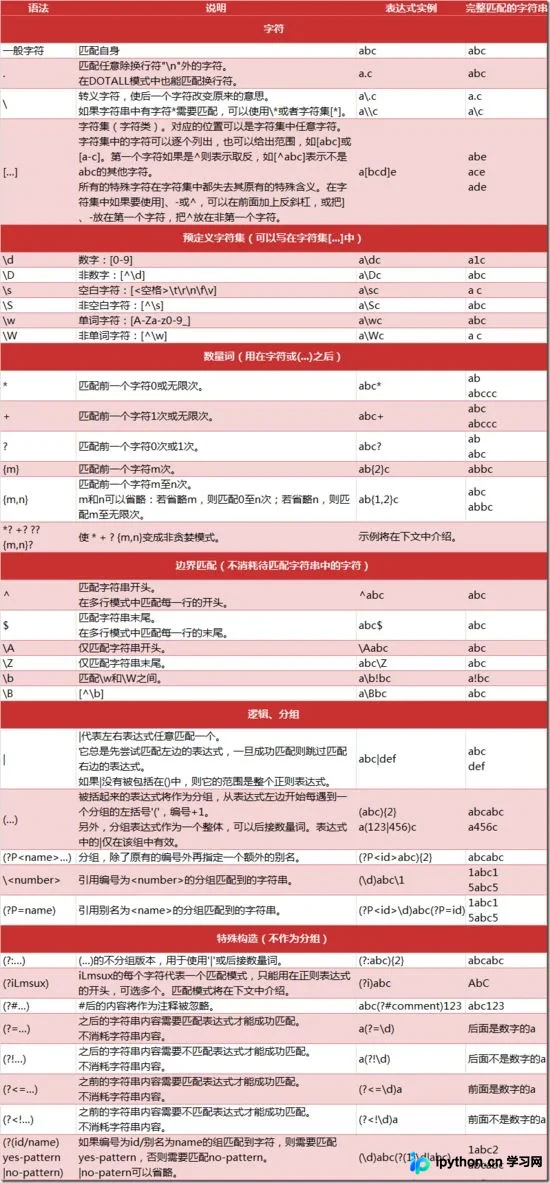
本文详解Python中re模块的核心用法,涵盖match与search的区别、贪婪与非贪婪匹配、分组提取及编译优化。通过HTML解析、字符串替换等实例,演示如何高效利用正则表达式进行数据抓取与处理,助力爬虫开发。
本文详细介绍Python中os.rename()方法的使用,包括语法、参数及返回值。通过实验演示如何重命名文件和目录,并重点分析当目标路径已存在或源路径不存在时抛出的OSError错误(如Error 2和Error 183),帮助开发者避免覆盖冲突和路径错误。
本文介绍利用Python标准库os模块实现批量文件重命名的方法。通过os.walk遍历指定目录,结合字符串分割逻辑匹配原文件名,并使用os.rename执行重命名操作。文中提供了基于文件数量过滤及特定命名规则(如分隔符处理)的代码示例,适用于需要高效处理大量文件重命名任务的场景。
本文详细解析Python中实现生产者消费者模型的两种主流方式。第一种基于queue模块结合多线程,通过队列缓冲解决同步问题;第二种利用yield关键字构建生成器(协程),实现轻量级的并行处理。文章提供完整代码示例,对比两种模式的适用场景与实现细节,帮助开发者根据实际需求选择最优方案。
本文介绍在Python中读取TXT文件每行数据并存入列表的方法。通过open函数以只读模式打开文件,逐行读取后去除换行符并按逗号分割,最终将结果追加至列表。
本文介绍如何使用Python的PyPDF2库将PDF文件按指定页码范围进行分割。通过定义起始页和结束页参数,遍历源文件并提取对应页面写入新文件,实现精确的PDF分页操作。代码示例展示了完整的读取、提取及保存流程,适用于需要批量处理或拆分PDF文档的场景。
本文介绍如何使用Python Fabric库实现远程服务器Hosts文件的动态更新。对比了命令行编辑与本地文件替换两种方案,推荐采用后者以提高脚本执行的稳定性和可操作性。通过示例代码展示了如何配置连接参数、备份原文件并上传新配置,适用于多机环境下的自动化运维场景。