

怎么用Python ord和chr函数实现字符ASCII值加5

ord() 将字符转换为对应的ASCII十进制整数,执行数值加5后,再使用内置函数 chr() 将得到的新整数转换回字符。完整单行表达为 chr(ord(c) + 5)。
一、核心机制:ord() 与 chr() 的双向转换原理
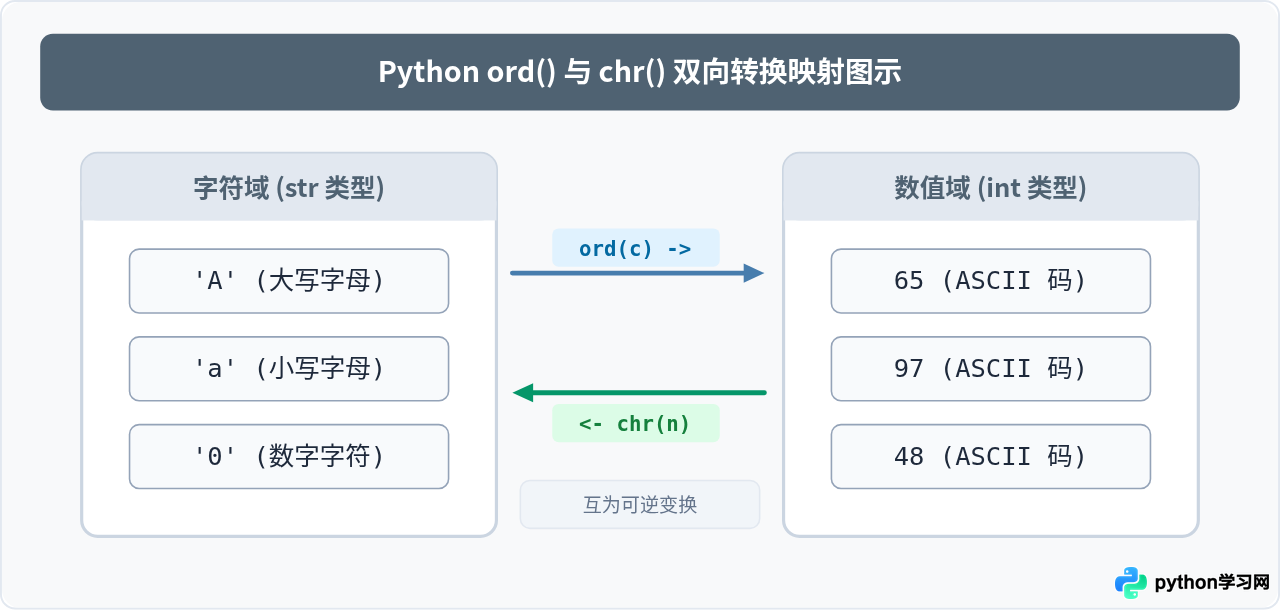
计算机在底层存储文本时,每个字符都会映射到一个固定的数字编号(编码)。在ASCII编码规范中,标准字符占用0到127的数值区间。Python内置了两个原生函数,专门用于在“字符”与“整数编码”之间建立桥梁:
ord(c):接收一个长度为1的字符串参数c,返回该字符对应的Unicode/ASCII码点整数。例如ord('A')返回整数65。chr(i):接收一个整数参数i,返回该码点所对应的单字符字符串。例如chr(70)返回字符串'F'。
这两个函数互为逆运算,即对于任意合法字符 c,始终满足 chr(ord(c)) == c。当我们需要对字符进行数值偏移时,必须先借由 ord() 进入数值运算域,完成加法后再通过 chr() 退回文本字符域。
二、单个字符 ASCII 值加 5 的具体实现步骤
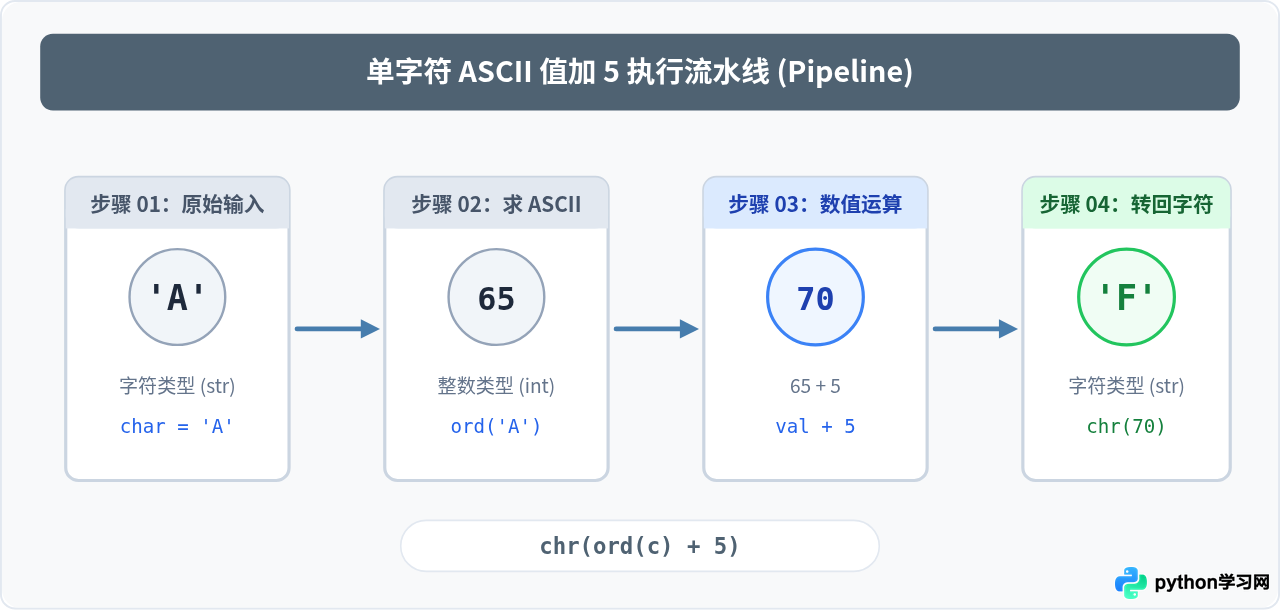
实现字符 ASCII 值加 5 的逻辑非常纯粹,整个计算可以拆解为四个具体阶段:
- 准备输入字符:确保目标变量是一个长度为 1 的
str对象。 - 获取 ASCII 数值:调用
ord(char),得到对应的正整数。 - 进行算术相加:在原有数值基础上直接执行
+ 5计算。 - 还原目标字符:调用
chr(new_val),将计算得到的新整数转回对应字符。
下面是完整的 Python 3 示范代码:
# 单字符 ASCII 值加 5 示例
original_char = 'A'

# 步骤 1:获取原始字符的 ASCII 整数值
ascii_val = ord(original_char)

# 步骤 2:对 ASCII 值加 5
new_ascii_val = ascii_val + 5

# 步骤 3:将新整数还原为字符
result_char = chr(new_ascii_val)

# 也可以合并为单行表达式
compact_result = chr(ord(original_char) + 5)

print(f"原字符: {original_char} (ASCII: {ascii_val})")
print(f"计算后 ASCII: {new_ascii_val}")
print(f"新字符: {result_char}")
print(f"单行运算结果一致性验证: {result_char == compact_result}")计算后 ASCII: 70
新字符: F
单行运算结果一致性验证: True
在上述执行过程中,大写字母 'A' 对应的 ASCII 码是 65,加上 5 之后得到 70,ASCII 码表中 70 对应的字符正是 'F'。整个运算过程直观且执行开销极小。
三、处理完整字符串:批量 ASCII 偏移实现
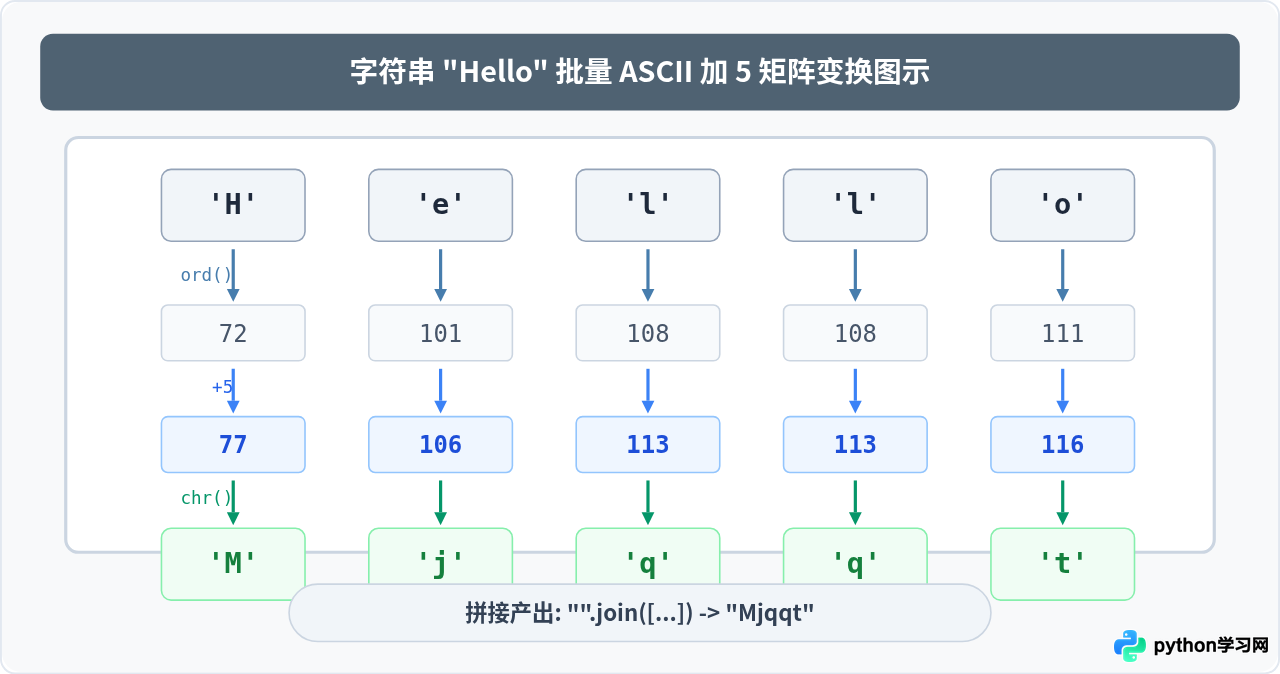
在开发实践中(如简易数据脱敏、加密解密或自定义编码转换),往往需要对整段字符串中的所有字符依次执行加 5 变换。针对这一需求,Python 提供了多种简洁高效的实现方式。
方法 1:使用列表推导式与 str.join()(推荐)
列表推导式配合空字符串的 join() 方法是 Python 中处理字符串变换的最地道(Pythonic)写法。它的执行效率高且代码紧凑:
# 列表推导式实现字符串字符 ASCII 值加 5
source_text = "Hello"

# 对每个字符应用 chr(ord(c) + 5)
transformed_text = "".join(chr(ord(char) + 5) for char in source_text)

print(f"原文本: {source_text}")
print(f"变换后: {transformed_text}")变换后: Mjqqt
方法 2:封装为具有防御性逻辑的处理函数
当需要在大型程序中复用该逻辑时,建议将其封装为一个独立的函数,并支持自定义偏移量(默认值为 5):
def shift_ascii_string(text: str, offset: int = 5) -> str:
    """
    将输入字符串中的每个字符按照指定 ASCII 偏移量进行移动。

    :param text: 待处理的原字符串
    :param offset: ASCII 码增加的步长,默认为 5
    :return: 偏移处理后的新字符串
    """
    char_list = []
    for c in text:
        new_char = chr(ord(c) + offset)
        char_list.append(new_char)
    return "".join(char_list)

# 测试调用
sample = "Python"
print("偏移前:", sample)
print("偏移后:", shift_ascii_string(sample, 5))偏移后: U~ymts
四、关键细节与边界条件处理
虽然 chr(ord(c) + 5) 逻辑直接,但在实际编码中如果不考虑参数边界和编码范围,程序很容易引发异常或输出不符合预期的乱码。开发时需要重点防范以下三类问题:
1. 参数长度严格限制为单字符
函数 ord() 仅接受长度严格为 1 的字符串。如果传入空字符串 "" 或长度大于 1 的字符串(如 "AB"),Python 将直接抛出 TypeError:
# 错误示例
try:
    ord("AB")
except TypeError as e:
print(f"抛出异常: {e}")2. ASCII 编码边界溢出 (0 ~ 127)
标准 ASCII 编码的最大值是 127(对应控制字符 DEL)。在纯 ASCII 应用场景中:
- 字符
'z'的 ASCII 值为122,加 5 后得到127。 - 字符
'{'的 ASCII 值为123,加 5 后得到128。
在 Python 3 中,由于字符串原生基于 Unicode,chr(128) 并不会直接报错崩溃,而是返回扩展 ASCII/Unicode 字符 '\x80'。但如果后续系统仅支持标准 7 位 ASCII 编码,这就会导致协议校验失败或解码异常。
3. 字母表内部循环滚动(凯撒位移)
很多开发者实现“字符加 5”的实际业务诉求是:希望 'v' 加 5 变成 'a'、'V' 加 5 变成 'A',即在字母表内闭环滚动。直接加 5 会将 'v' (118) 变成 '{' (123)。要实现字母表循环,必须使用模运算 % 26:
def shift_letter_wrap(char: str, offset: int = 5) -> str:
    """仅对英文字母进行 26 模运算闭环滚动加 5,非字母保持原样"""
    if 'a' <= char <= 'z':
        # 小写字母基准为 97 (ord('a'))
        return chr((ord(char) - ord('a') + offset) % 26 + ord('a'))
    elif 'A' <= char <= 'Z':
        # 大写字母基准为 65 (ord('A'))
        return chr((ord(char) - ord('A') + offset) % 26 + ord('A'))
    else:
        # 非字母字符(空格、标点、数字等)不参与位移
        return char

# 验证边界回绕
test_chars = ['a', 'v', 'w', 'x', 'y', 'z']
results = [f"{c} -> {shift_letter_wrap(c, 5)}" for c in test_chars]
print("字母回绕结果:", ", ".join(results))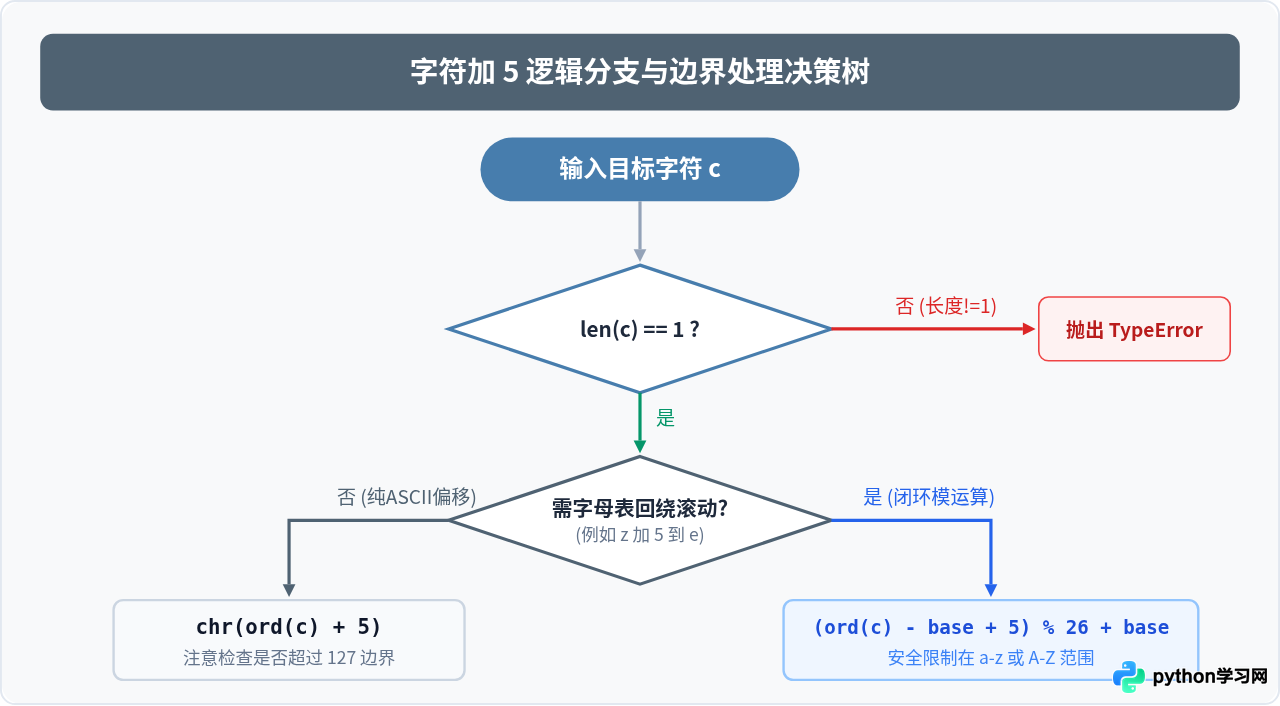
五、常见场景对比与速查总结
为了帮助读者在不同开发场景下快速选用正确的写法,下表总结了常见场景的处理方案与效果对比:
| 应用场景 | 输入示例 | 核心实现代码 | 输出结果 | 适用说明 |
|---|---|---|---|---|
| 单字符基础偏移 | 'A' |
chr(ord('A') + 5) |
'F' |
最基础的定长 ASCII 移动 |
| 字符串批量处理 | "Cat" |
"".join(chr(ord(c)+5) for c in s) |
"Hfy" |
文本内容无特殊符号的整体混淆 |
| 尾部字母回绕 | 'z' |
chr((ord('z')-97+5)%26+97) |
'e' |
凯撒密码(Caesar Cipher)式字母闭环位移 |
| 逆向还原(解密) | 'F' |
chr(ord('F') - 5) |
'A' |
减 5 即可精确还原原字符 |
Python 中利用 ord() 和 chr() 实现字符 ASCII 值加 5 的本质就是“字符转整数 -> 整数算术加 5 -> 整数转字符”。在编写具体代码时,单字符直接使用 chr(ord(c) + 5);整段文本使用生成器推导式与 str.join() 批量处理;如果业务要求英文字母循环滚动,则需配合 % 26 模运算规避边界溢出问题。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









