

Python实现A3 PDF转A4:自动拆分与合并脚本
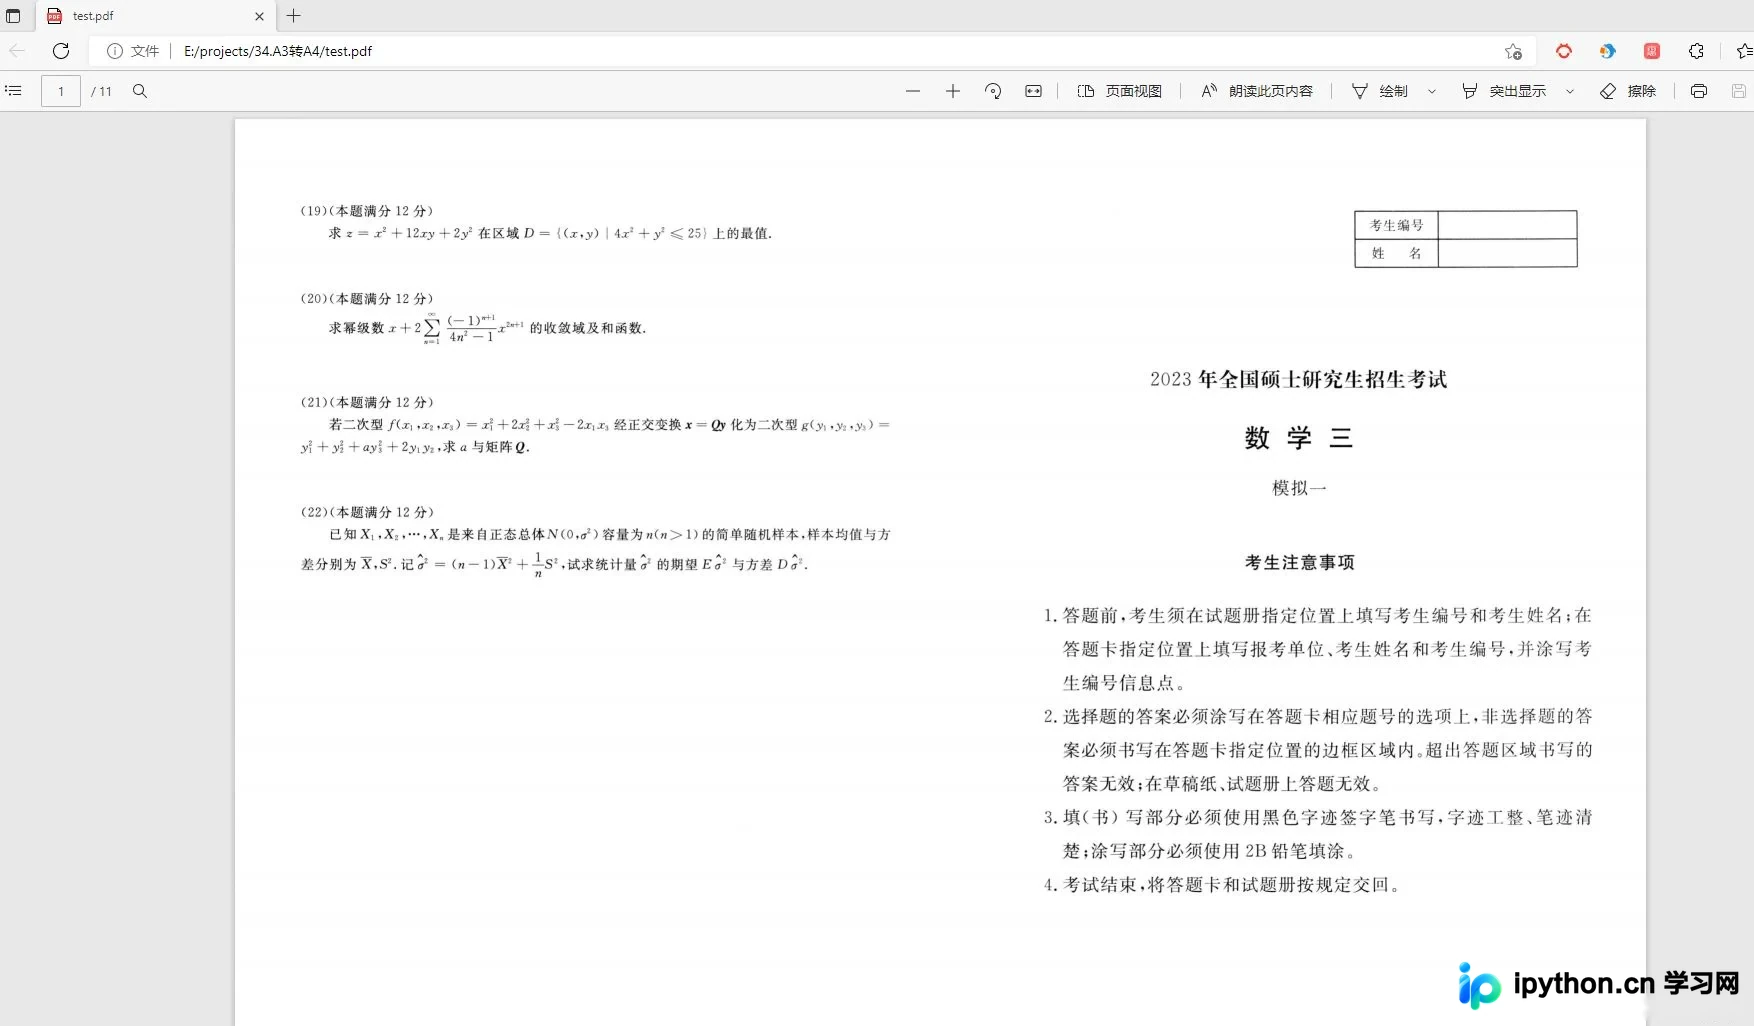
本文介绍如何使用Python将A3格式PDF文件转换为适合A4打印的双页格式。通过PyMuPDF提取高清图片,利用OpenCV进行图像切割,最后由FPDF重新合并为PDF。脚本自动创建中间文件夹,处理前后页面数量翻倍,解决单页过大无法打印的问题,提供完整可运行代码及效果展示。
2026-10-16
29
本文介绍如何使用Python将A3格式PDF文件转换为适合A4打印的双页格式。通过PyMuPDF提取高清图片,利用OpenCV进行图像切割,最后由FPDF重新合并为PDF。脚本自动创建中间文件夹,处理前后页面数量翻倍,解决单页过大无法打印的问题,提供完整可运行代码及效果展示。
本文介绍pandas处理Excel中超过14位数字自动转换为科学计数法的问题。提供两种解决方案:数据量小时使用to_csv替代to_excel;通用方法是在read_excel时指定dtype=str将所有数据读为字符串。此外,还讨论了将特定字段转为int类型时需先处理空值的注意事项,以避免转换错误。
本文深入解析Python中判断两个字符串是否为乱序排列的多种实现方式。从基础的遍历移除法(O(n^2))到排序比较法(O(nlogn)),再到基于字符计数的线性时间复杂度解法(O(n)),详细对比了各方案的时间复杂度与代码实现。文章还探讨了利用Counter优化计数的技巧,帮助开发者根据实际场景选择最优算法。
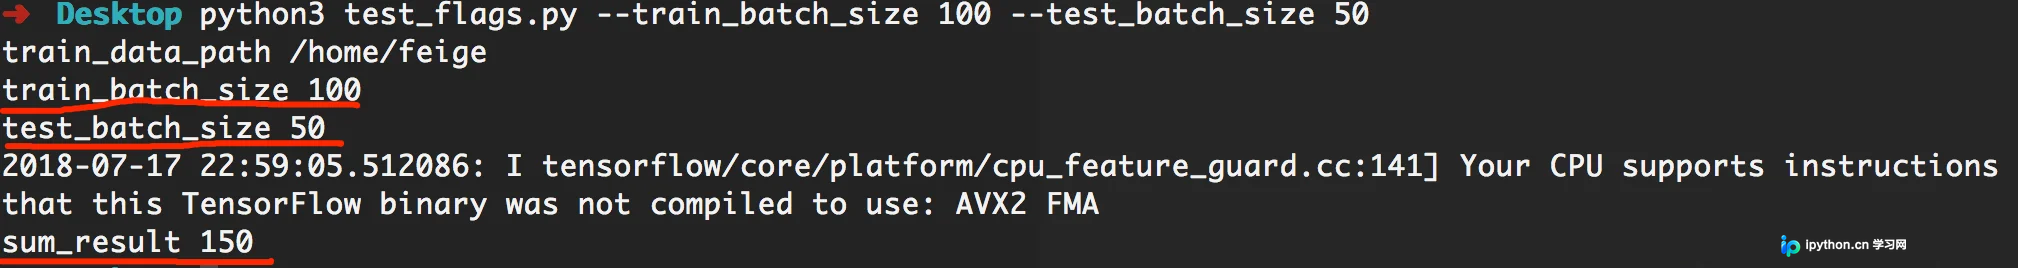
本文介绍TensorFlow中tf.app.flags模块的使用方法,该模块功能类似Python的argparse。通过示例代码展示如何定义字符串、整数和浮点型参数,并解析命令行输入。同时深入分析tf.app.run()的执行流程,揭示其调用main函数及解析参数的底层逻辑,帮助开发者理解并正确使用该模块。
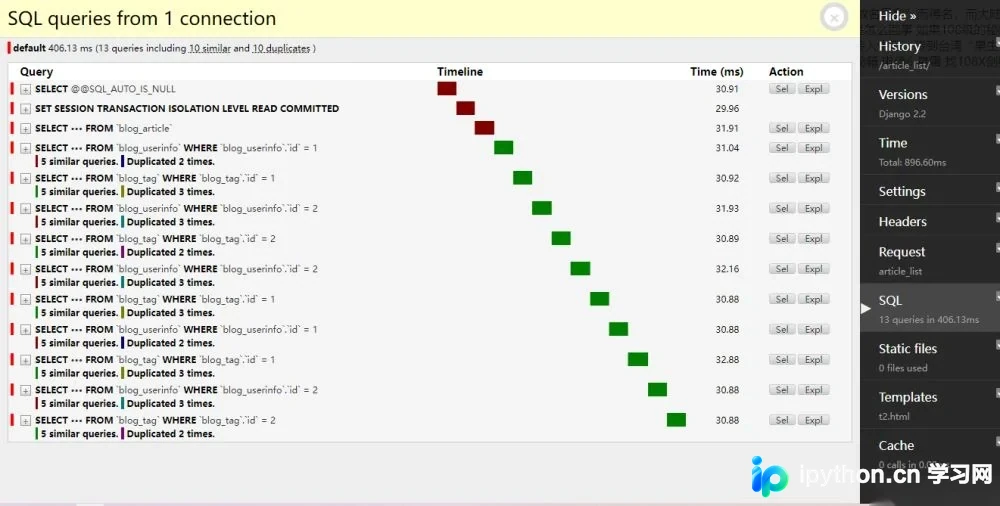
本文详解Django中select_related与prefetch_related的用法与区别。通过django-debug-toolbar展示原生查询导致的N+1问题,对比分析两者在单表关联与多表关联中的性能差异。文章提供完整代码示例,说明如何利用双下划线指定字段及Prefetch对象添加过滤条件,帮助开发者有效减少数据库查询次数,提升应用性能。
本文深入解析Python中字典和集合的核心概念与使用方法。详细讲解字典的定义、键值对特性及clear、get、pop等常用方法,涵盖元素的添加、修改与删除操作。同时介绍集合的无序可变特性,演示add、update、discard等元素管理方法,并对比union、intersection等集合运算符号与函数的区别,帮助开发者掌握高效的数据处理技巧。
本文详解Python中单下划线与双下划线的命名约定及其对访问权限的影响,区分保护变量、私有成员及特殊方法。同时深入解析绝对导入与相对导入的区别、使用场景及潜在限制,结合硬编码概念说明模块维护的最佳实践。
本文介绍Python中实现字符串模式匹配的方法,以及利用内建函数maketrans和translate进行字符映射与替换的技术。通过具体示例展示如何构建映射表、执行字符串替换,并指出该方法在加密解密中长度一致且字符唯一的限制条件。
本文深入解析 Python 中 ValueError 异常的三种典型场景:将非数字字符串转为整数、直接遍历字典键值对导致的解包错误,以及在二进制模式下读取文件时指定编码参数。通过具体代码示例与规避方案,帮助开发者快速定位并修复此类类型或参数不匹配引发的运行时错误。
本文深入解析Python中字符串截取与切片的核心机制,涵盖正向与反向索引规则、切片语法[start:end:step]的具体用法及实例演示。同时提供两种自定义字符串截取函数的实现方案,分别适用于单次提取和批量提取特定标签间内容的场景,助力开发者高效处理XML、JSON等字符串数据。
本文详解Python中numpy库的log系列函数。np.log()对应自然对数ln,np.log10()对应常用对数lg。通过换底公式可计算任意底数的对数值。此外还介绍了数组算术运算符、绝对值、三角函数及指数对数等通用函数的使用方法。
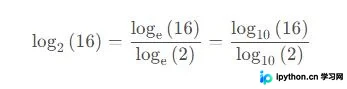
本文详细介绍Python中int()函数的使用方法。涵盖将浮点数、布尔值及字符串转换为整型的规则,重点解析二进制、八进制、十六进制及自定义进制的转换语法。同时指出int()无法直接处理含小数点的字符串,并提供正确的转换路径,最后列举base参数越界及非法字符导致的常见报错与解决方案。