

Python实现A3 PDF转A4:自动拆分与合并脚本

发布时间:2026-10-16| 4人浏览过
本文介绍如何使用Python将A3格式PDF文件转换为适合A4打印的双页格式。通过PyMuPDF提取高清图片,利用OpenCV进行图像切割,最后由FPDF重新合并为PDF。脚本自动创建中间文件夹,处理前后页面数量翻倍,解决单页过大无法打印的问题,提供完整可运行代码及效果展示。
1. 需求概述
近期收到一份PDF文档,其页面格式为A3尺寸,但现有的打印设备仅支持A4纸张输出。
为解决此问题,计划将每一张A3大页面裁剪并拼接为两张较小的A4页面,从而确保打印流程顺畅。
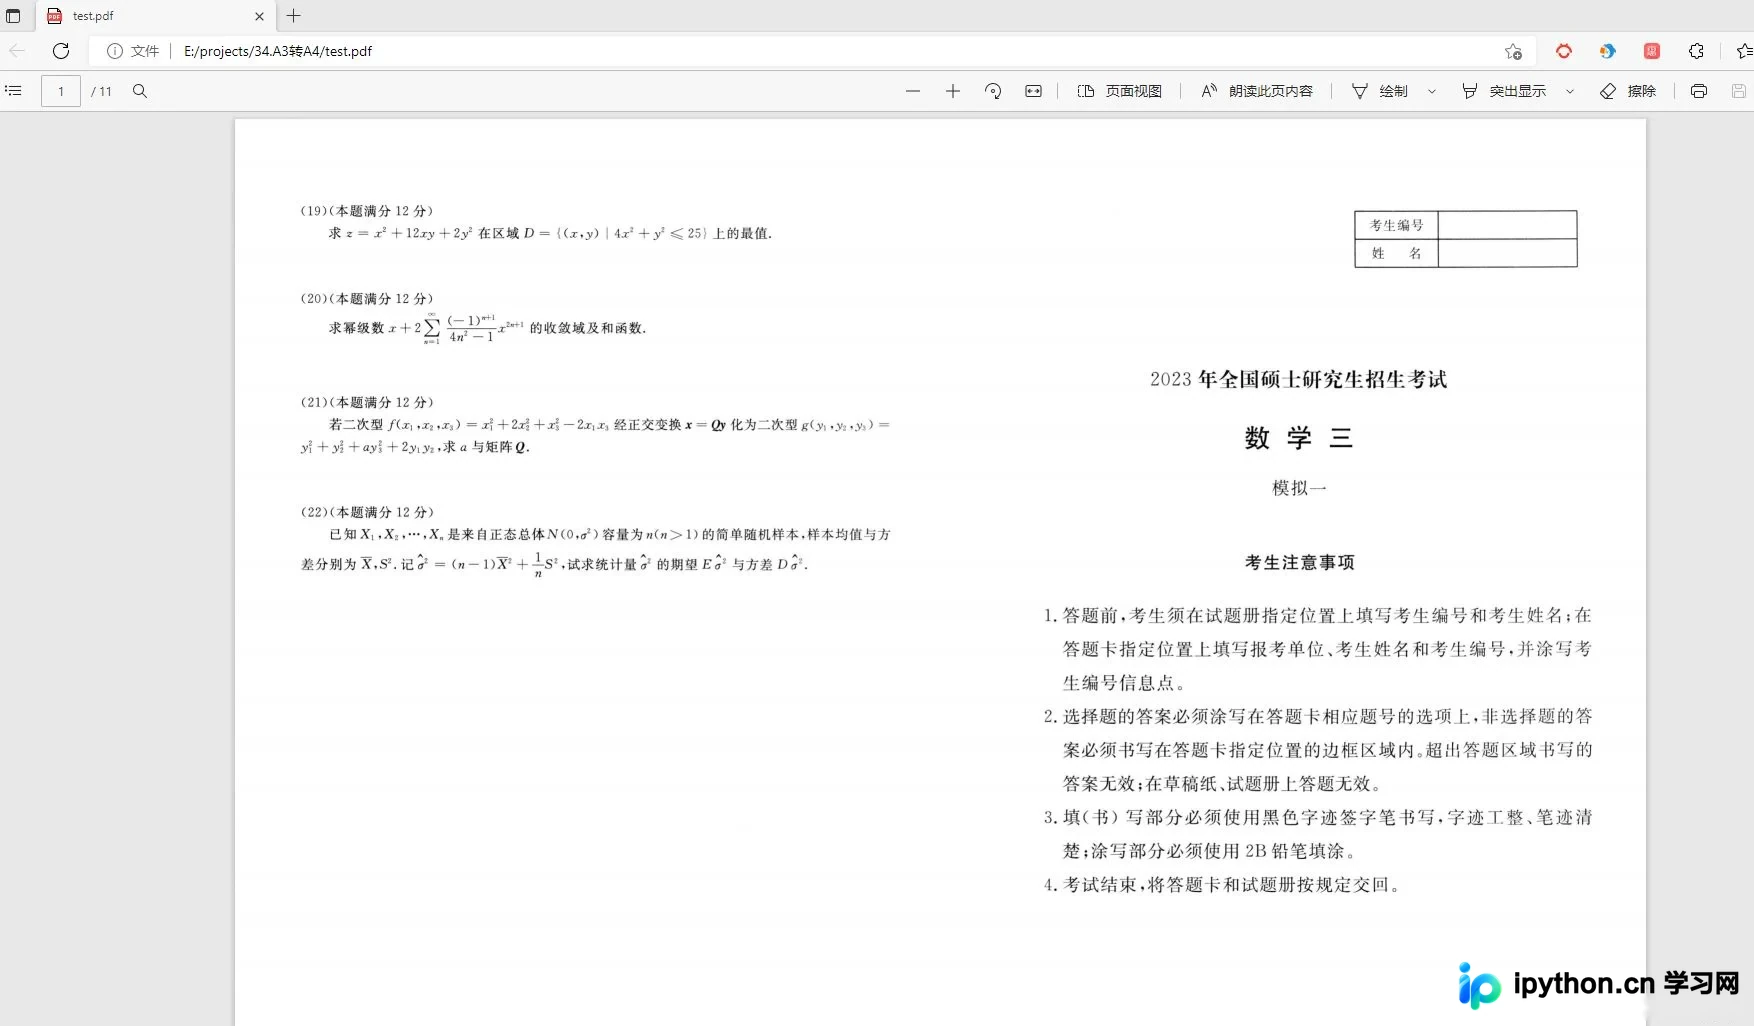
因此,决定编写一段Python程序来自动化执行这一转换任务。
2. 代码实现
首先,在当前工作目录下新建一个Python脚本文件,并录入以下代码。
引入必要的依赖库后,整个程序主要包含三个核心函数的定义。
第一个函数负责将原始PDF文档逐页转换为高清图片,并将这些图片保存至自动创建的images1目录中。
第二个函数对images1中的每张图片进行几何切割处理,将单张大图切分为两张小图,结果存入自动生成的images2目录。
第三个函数读取images2目录下的所有切割后图片,并将它们依次合并生成一个新的PDF文件。
import fitz
import time
import os
import cv2
from fpdf import FPDF
from PIL import Image


# 将pdf分割为图片,并建立一个images1文件夹保存之 传入要拆解的pdf文件名
def to_image(file_name):
    dir1 = "images1"
    if not os.path.exists(dir1):
        os.mkdir(dir1)
    time_start = time.time()
    doc = fitz.open(file_name)
    rotate = int(0)
    zoom_x = 2.0
    zoom_y = 2.0
    trans = fitz.Matrix(zoom_x, zoom_y)
    print("%s开始转换..." % file_name)

    pg = 0
    for page in doc:
        timep_start = time.time()
        pg += 1
        pm = page.get_pixmap(matrix=trans, alpha=False)
        new_full_name = dir1 + "/" + file_name.split(".")[0]
        filename1 = "{0:s}{1:0>3d}.jpg".format(new_full_name, pg)
        pm.save(filename1)
        timep_end = time.time()
        print('第 ' + str(pg) + ' 页生成图片累计用时:' + str(timep_end - timep_start))

    time_end = time.time()
    print('拆解累计用时:' + str(time_end - time_start))


# 将images1文件夹中的每个图片,左右分割为两张,并新建images2文件夹以保存文件
def cut_img():
    for img in os.listdir("images1"):
        image = cv2.imread("images1/" + img)
        x0 = int(image.shape[1]/2)
        dir2 = "images2"
        if not os.path.exists(dir2):
            os.mkdir(dir2)
        img1 = image[:, 0:x0]
        img2 = image[:, x0:]
        cv2.imwrite(dir2 + "/" + img[:-4] + '1.jpg', img1)
        cv2.imwrite(dir2 + "/" + img[:-4] + '2.jpg', img2)


# 将images2文件夹中的图片合并成为一个pdf,按照文件名的顺序 传入输出的pdf文件名
def makePdf(pdfFileName):
    listPages = ["images2/" + imgFileName for imgFileName in os.listdir('images2')]
    cover = Image.open(listPages[0])
    width, height = cover.size
    pdf = FPDF(unit="pt", format = [width, height])
    for page in listPages:
        pdf.add_page()
        pdf.image(page, 0, 0)
    pdf.output(pdfFileName, "F")


# 执行
if __name__ == "__main__":
    to_image("test.pdf")
    cut_img()
    makePdf("result.pdf")
处理完成后生成的文件即result.pdf,打开该文件后的视觉效果如图所示。
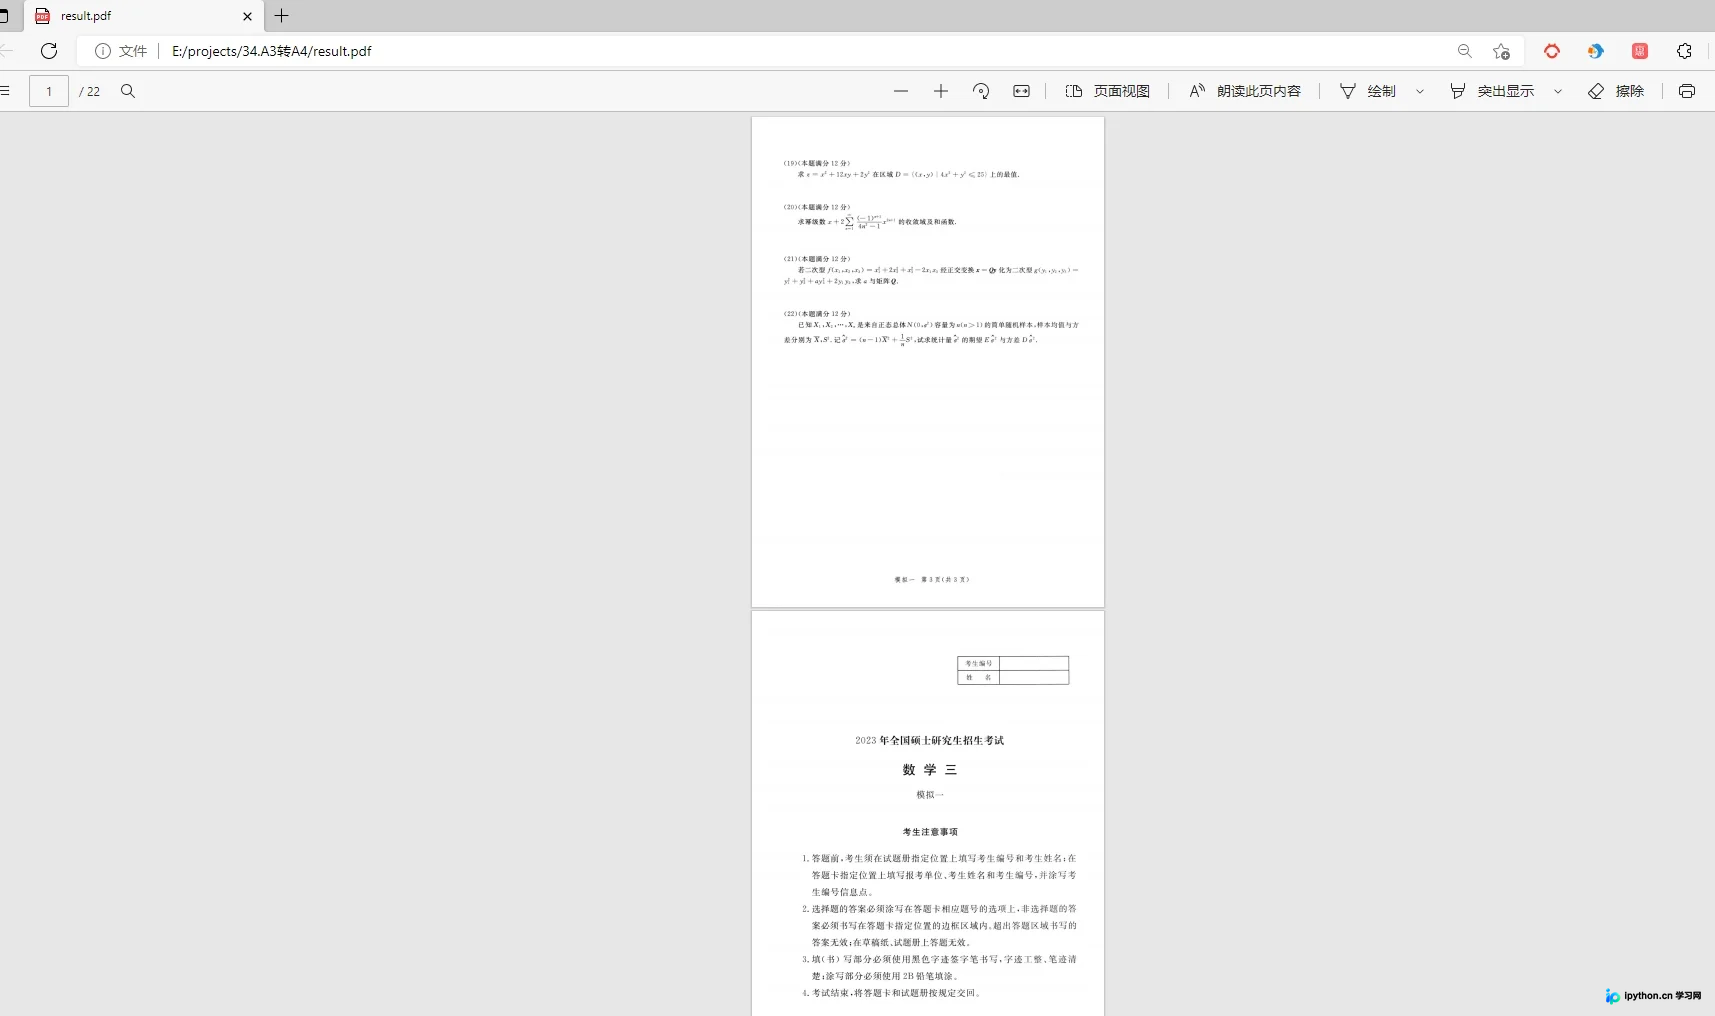
从图中可见,页面已成功分割,原始文档的11页内容现已扩展为22页,完美适配A4打印需求,打印工作得以顺利推进。
至此,关于利用Python操作PDF文件实现A3页面转A4的教程介绍完毕。如需了解更多Python处理PDF或A3转A4的相关内容,欢迎查阅本站过往文章或继续浏览后续内容,感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









