

Python图像批量缩放实战:从原理到命令行工具构建
本文深入解析Python中图像缩放的底层原理,对比OpenCV与Pillow两大库的实现差异,并指导读者使用Click库构建一个支持批量处理、参数配置的命令行图像缩放工具。
2026-10-14
27
本文深入解析Python中图像缩放的底层原理,对比OpenCV与Pillow两大库的实现差异,并指导读者使用Click库构建一个支持批量处理、参数配置的命令行图像缩放工具。
本文深入解析Python多线程编程中共享全局变量引发的数据竞争问题。通过引入互斥锁(Mutex)机制,确保多个线程安全访问共享资源。文章详细阐述了同步概念、互斥锁的工作原理及acquire/release方法的使用,并提供了完整的代码示例,展示如何正确使用上锁与解锁来保证数据一致性,同时强调了最小化锁范围以优化性能的最佳实践。
本文介绍如何在Scrapy框架中配置动态代理IP以应对网站反爬机制。通过设置DOWNLOADER_MIDDLEWARES启用ProxyMiddleware和CheckProxyMiddleware,并在settings中定义PROXIES列表,实现请求IP的随机切换与基础验证,帮助爬虫稳定获取数据。
本文详细解析 Scrapy 中 settings.py 的关键配置项。涵盖字符编码设置、Redis 连接参数(含密码与数据库指定)、请求超时与重试机制优化,以及基于 scrapy-redis 的去重组件、调度器和持久化断点续爬功能的配置方法。通过调整 DUPEFILTER_CLASS、SCHEDULER 及 SCHEDULER_QUEUE_CLASS 等参数,实现高效分布式爬虫与数据持久化存储。
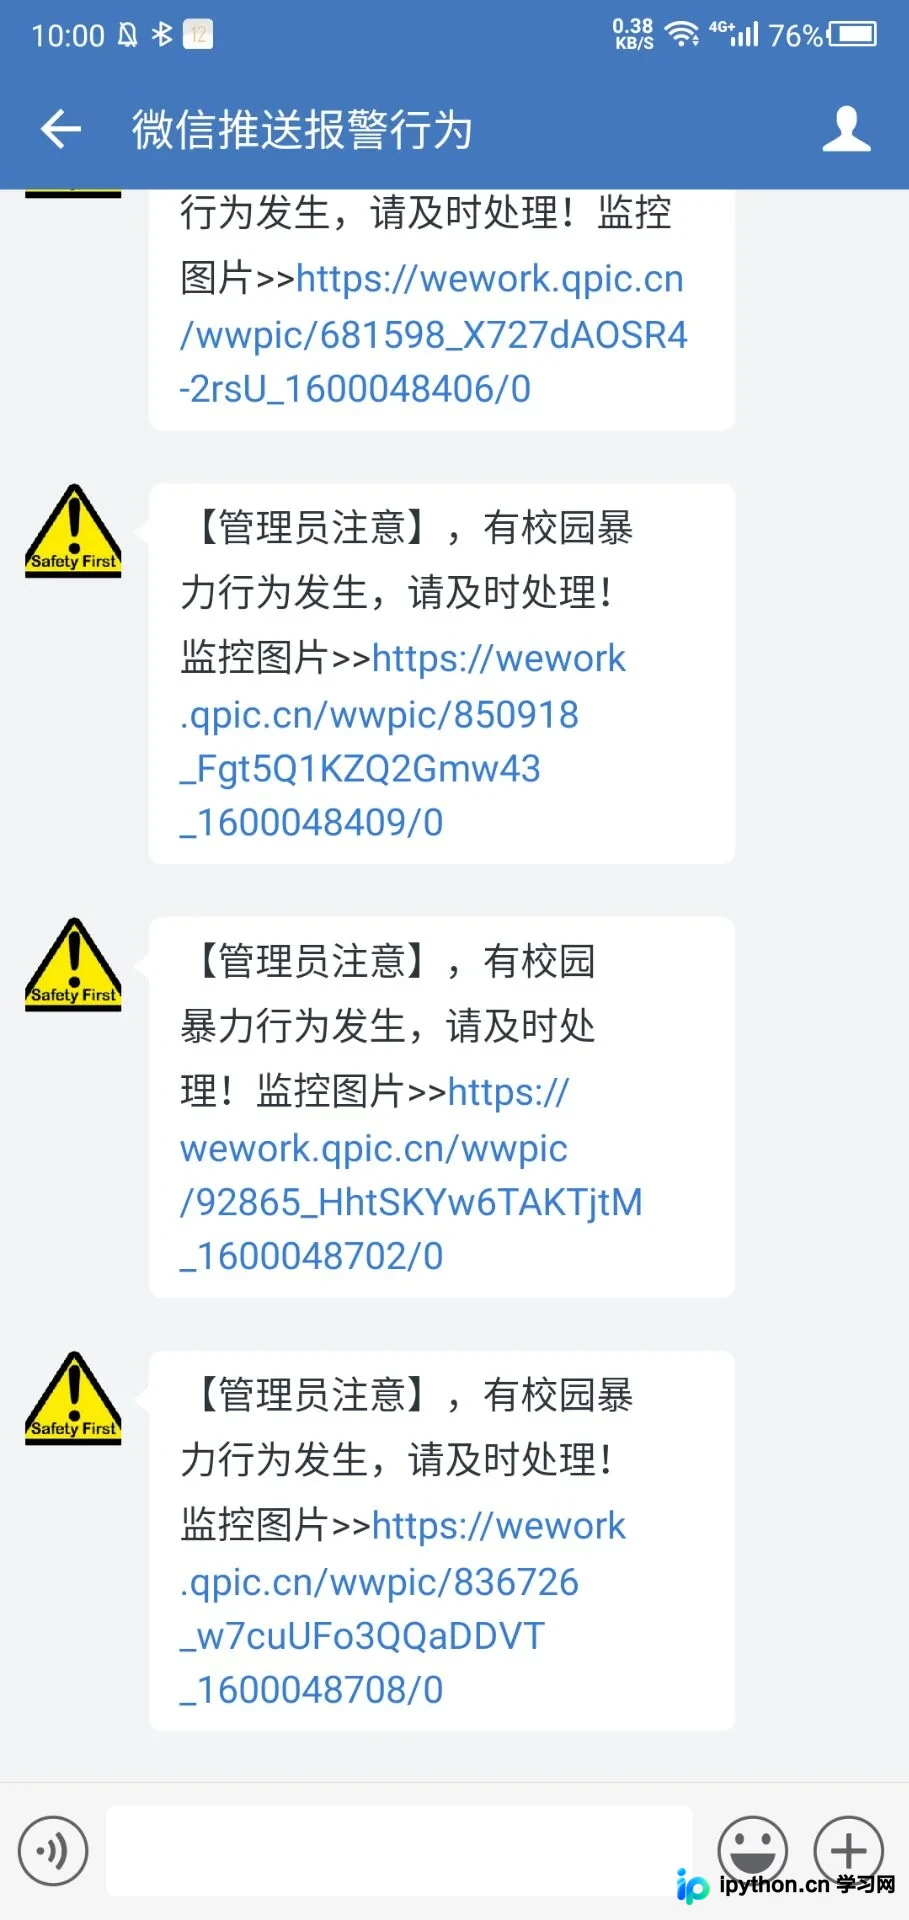
本文详解如何使用Python调用企业微信API发送包含图片链接的消息。针对图片上传导致主线程阻塞的问题,提供基于多线程的封装方案,并结合OpenCV处理图像,实现高效稳定的消息推送。
本文详解Scrapy中向Spider传递参数的两种主流方法。第一种通过命令行crawl命令的-a选项传入参数,并在Spider构造函数中接收;第二种通过scrapyd调度schedule.json接口使用-d选项添加参数。此外,还介绍了利用Request的meta属性在页面解析间传递数据的技巧,帮助开发者灵活控制爬虫行为。
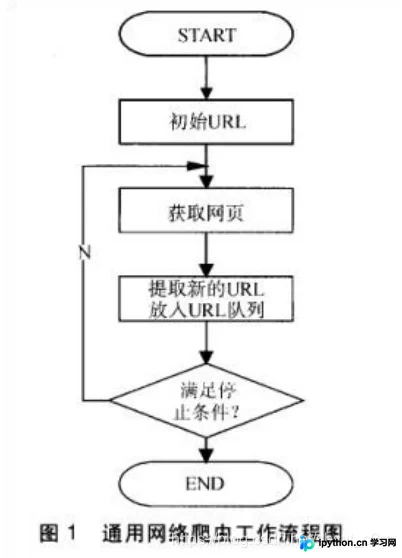
本文深入解析Python网络爬虫的两大核心类型:通用爬虫与聚焦爬虫。详细阐述通用爬虫在搜索引擎中的工作流程,包括种子URL选取、页面抓取、数据存储及预处理(分词、索引构建)等关键步骤,并探讨Robots协议的作用与局限性。同时,介绍聚焦爬虫如何通过主题筛选算法实现精准数据采集,对比两者在覆盖率、资源消耗及应用场景上的差异,并简述常见的反爬虫手段如IP限制与数据投毒,为开发者提供全面的技术参考。
本文提供基于Python Turtle库的贪吃蛇游戏完整实现代码。通过定义蛇身坐标、苹果随机位置及方向控制函数,利用ontimer实现游戏循环。代码涵盖键盘监听、碰撞检测及绘图逻辑,适合Python初学者参考学习经典游戏开发流程。
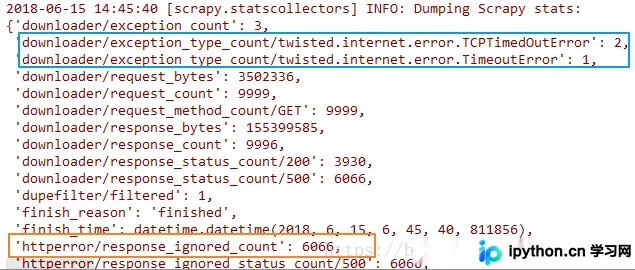
本文详解Scrapy中处理下载错误的两种主要场景:HTTP状态码异常(如403/500)与代码执行异常。通过深入分析RetryMiddleware源码,揭示process_response与process_exception的工作机制,并提供一个自定义中间件模板,用于兜底捕获未重试成功的请求,确保爬虫在长时间运行时的稳定性与数据完整性。
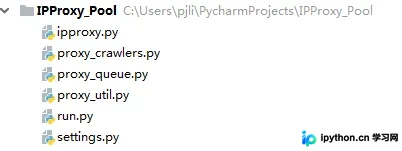
本文详细介绍Python爬虫代理池的搭建流程。针对IP访问频率限制问题,提出通过代理池轮询IP的解决方案。涵盖从代理网站抓取、可用性验证、Redis存储到队列管理的完整代码实现,包含IPProxy类、配置管理及多爬虫基类设计,并提供测试与GitHub源码地址。
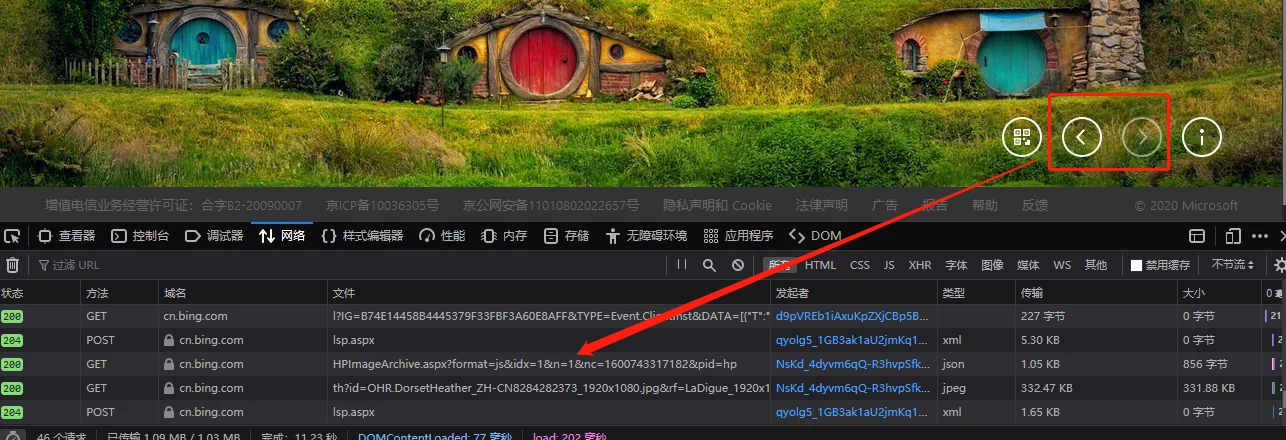
本文介绍如何使用 Python 的 requests 库调用 Bing 官网提供的图片接口,自动获取并下载每日高清壁纸。文章详细解析了接口参数含义,提供了完整的代码示例,包括请求构造、JSON 数据解析及图片保存逻辑,并提及了官方 Windows 应用作为替代方案。
本文介绍了如何在Python和Node.js环境中生成当前时间戳。通过示例代码展示了如何格式化输出年月日时分秒,以及如何获取毫秒级时间戳。同时,文章提供了命令行参数处理逻辑,支持按指定次数批量生成递增的时间戳数据,适用于脚本自动化测试或日志生成场景。