Python循环导入模块的原理与解决方案
本文深入解析Python中循环加载模块的底层机制,解释为何直接导入可能成功而间接调用却报错。通过具体代码案例演示AttributeError的产生过程,并提供修改导入时机等解决方案,帮助开发者理解模块初始化顺序并避免常见陷阱。
2026-10-13
27
本文深入解析Python中循环加载模块的底层机制,解释为何直接导入可能成功而间接调用却报错。通过具体代码案例演示AttributeError的产生过程,并提供修改导入时机等解决方案,帮助开发者理解模块初始化顺序并避免常见陷阱。
本文详细介绍Django中默认Path转换器的用法,包括str、int、slug、uuid和path五种类型。重点讲解如何创建自定义转换器(如Year_Converters)并通过register_converter注册,以及在urls.py中使用re_path进行正则表达式匹配的具体代码示例和注意事项。
本文详解Python开发中常见的模块命名冲突问题,通过具体案例说明自定义模块与标准库重名导致的导入错误及潜在风险。文章提供了实用的命名建议,并梳理了文本处理、二进制数据及数据类型等核心标准库模块,帮助开发者规避常见陷阱,规范代码结构。
本文深入解析Python生成器中next()与send()方法的核心区别。通过对比两者在控制执行流、返回值传递及参数注入方面的不同机制,结合具体代码示例,阐明next()仅用于推进迭代,而send()可向前生成器发送值以覆盖yield表达式的结果,帮助开发者更灵活地控制生成器状态。
在C#开发中,计算指定年份的第一个星期一需要基于1月1日进行星期推算。通过DateTime对象解析年初日期,利用循环配合DayOfWeek属性判断是否为周一,若非周一则递增天数直至满足条件,最终返回 formatted 的具体日期字符串,适用于报表生成等场景。
本文详细解析Python中threading模块的使用,重点介绍Thread类的target、args及kwargs参数配置。通过抓取天气数据的实例,演示如何创建线程列表、启动子线程以及利用join方法实现主线程与子线程的同步,确保程序逻辑完整执行。
本文详细介绍Python中的注释写法,包括以#开头的单行注释和多行字符串(三引号)的多行注释。通过实例演示如何查看函数文档字符串,帮助开发者规范代码说明,提升代码可读性。
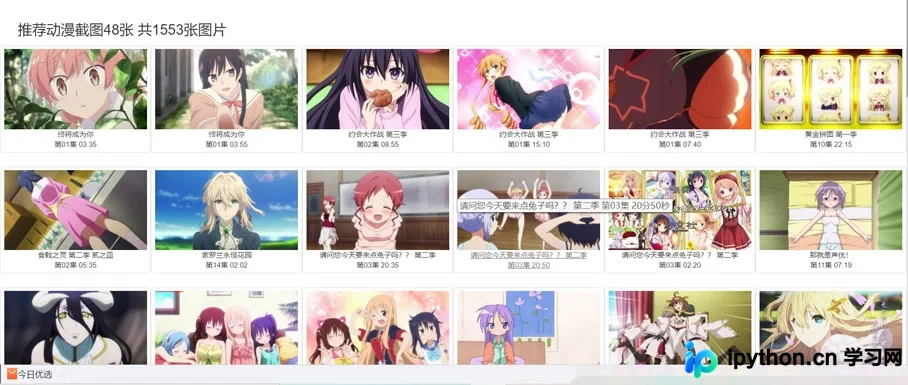
本文详细介绍使用Python爬虫批量获取动漫网站截图的完整流程。通过requests发送请求,利用正则表达式解析HTML提取图片链接与标题,结合os库管理文件存储,并引入time模块控制爬取频率以遵守网站规范。文章提供完整代码示例及分页处理技巧,帮助初学者快速掌握图片抓取实战技能。
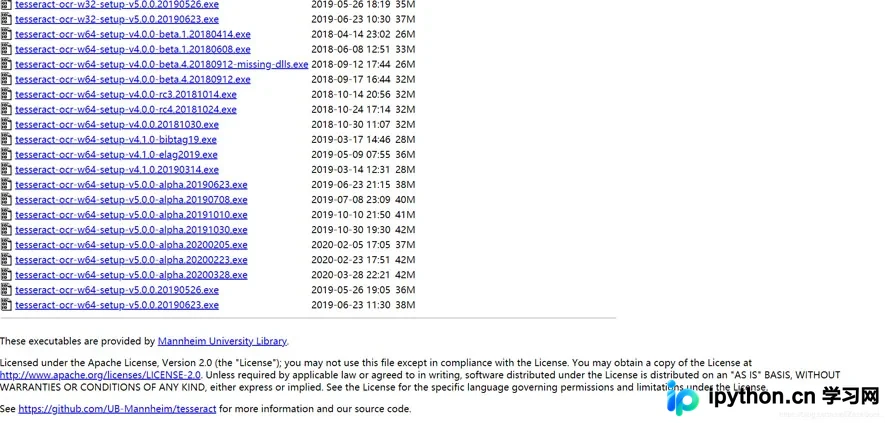
本文详细介绍如何利用Python结合Tesseract引擎实现图片文字识别。内容涵盖Tesseract的安装与系统环境变量配置、中英文语言包的下载与部署,以及使用pytesseract和Pillow库进行单张和批量图片识别的具体代码示例。同时分析了不同字体和倾斜角度对识别准确率的影响,为开发者提供实用的OCR解决方案。
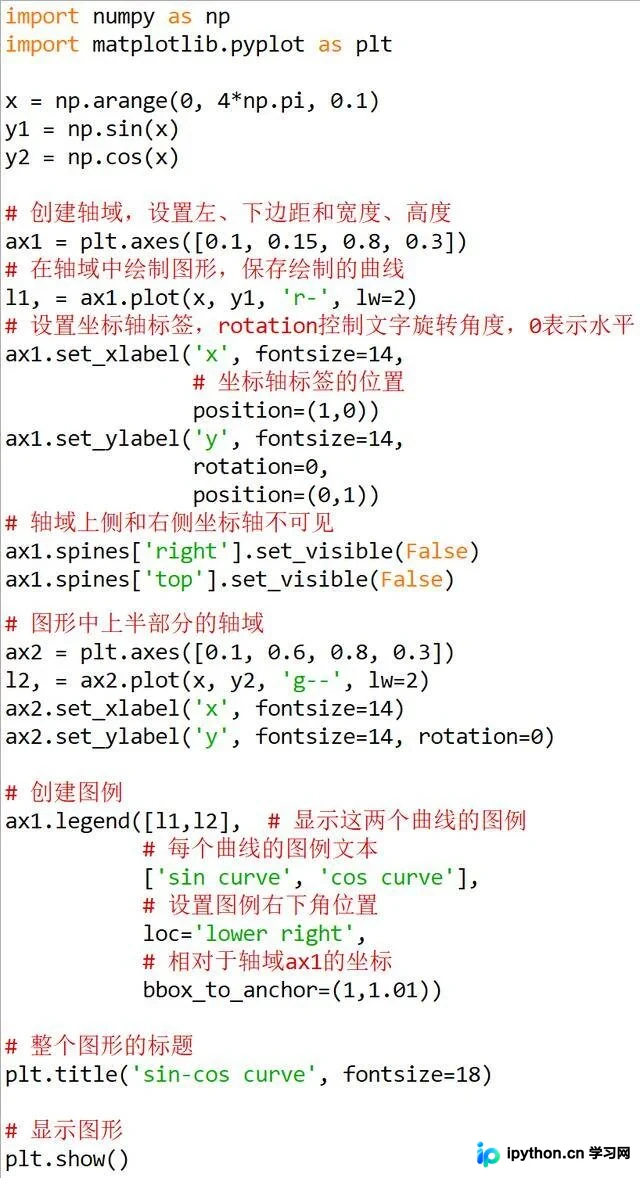
本文通过四个 Python matplotlib 实例,详细演示了如何创建轴域、设置坐标轴标签与图例位置。内容涵盖正余弦曲线绘制、图例字体与背景样式定制、多子图图例合并显示,以及复杂图形中多个图例的共存处理,帮助开发者掌握高级可视化技巧。
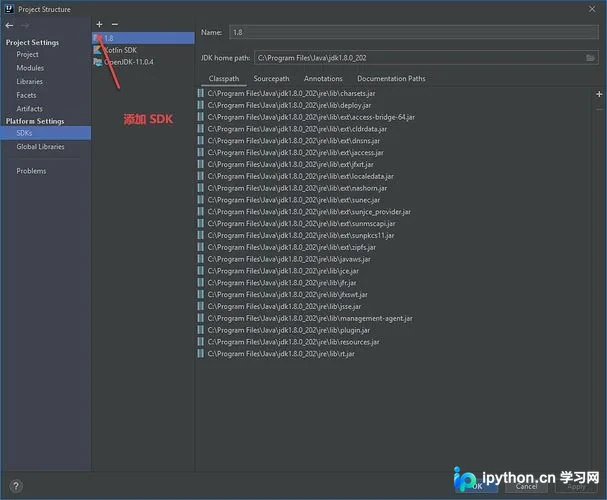
本文详解在 IntelliJ 中配置 Anaconda Python SDK 的操作流程。通过 Project Structure 添加 SDK,系统可自动识别已安装的 Anaconda,若未安装则需先完成环境部署。配置完成后保存并等待库刷新,即可在项目中正常使用 Python 环境进行开发。
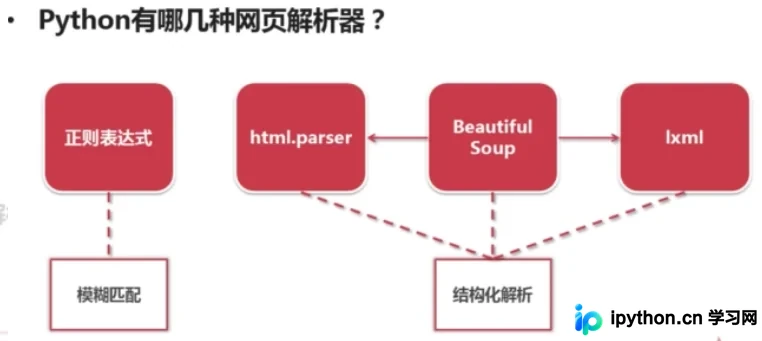
本文详解Python中常见的网页解析工具,包括正则表达式、html.parser、BeautifulSoup及lxml。重点介绍基于DOM树的结构化解析原理,并通过urllib与requests库结合BeautifulSoup的完整代码示例,展示如何获取和解析网页内容,帮助开发者快速掌握网页数据提取的核心方法。