

Python实现图片文字识别:Tesseract安装、配置与批量处理指南

本文详细介绍如何利用Python结合Tesseract引擎实现图片文字识别。内容涵盖Tesseract的安装与系统环境变量配置、中英文语言包的下载与部署,以及使用pytesseract和Pillow库进行单张和批量图片识别的具体代码示例。同时分析了不同字体和倾斜角度对识别准确率的影响,为开发者提供实用的OCR解决方案。
Python实现图片文字识别:Tesseract安装、配置与批量处理指南
一、前言
在软件使用或网页浏览过程中,常遇到无法直接复制文本的情况,例如部分文档仅允许复制片段。面对此类限制,用户通常采取截图保存的方式,但后续提取文字时需手动逐字输入,效率低下。通过技术手段直接识别图片中的文字内容,可以有效解决这一痛点。
二、Tesseract
Tesseract引擎安装与环境配置
光学字符识别(OCR)技术旨在将图像中的文字转换为可编辑的文本数据。Tesseract是一款开源的OCR引擎,结合Python语言能够高效实现文字识别功能。在开始编码前,需完成必要的软件安装与环境配置工作。
(1)Tesseract的安装及配置
访问Tesseract官方下载页面 https://digi.bib.uni-mannheim.de/tesseract/,界面显示多个可用版本。
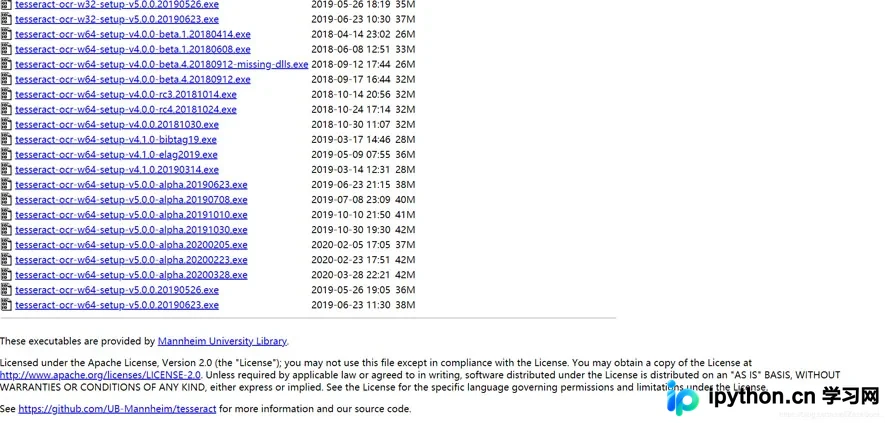
用户可根据操作系统架构选择对应版本,其中“w32”代表32位系统,“w64”代表64位系统。若下载速度缓慢,可使用备用链接 https://pan.baidu.com/s/1YQCMnx-wCeNrJEE3wcEnQA (提取码:rbc6)进行下载。安装过程中需记录安装路径,例如本例中的“D:\CodeField\Tesseract-OCR”,并将其添加到系统环境变量Path中。
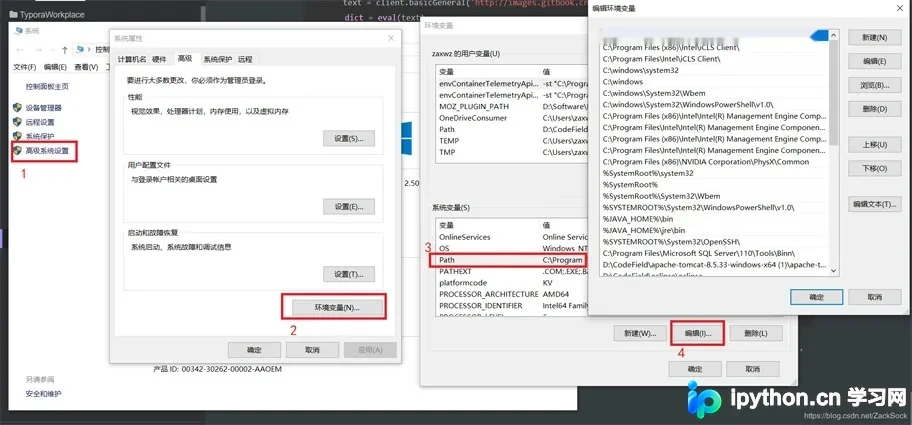
配置方法为:右键点击“我的电脑”或“此电脑”,选择“属性”,进入“高级系统设置”,点击“环境变量”,在“Path”变量中编辑并新建条目,粘贴Tesseract的安装路径,最后依次点击确定保存配置。
(2)下载语言包
Tesseract默认仅支持英文,识别中文或其他语言需额外下载对应语言包。官方数据文件下载地址为:https://tesseract-ocr.github.io/tessdoc/Data-Files 。
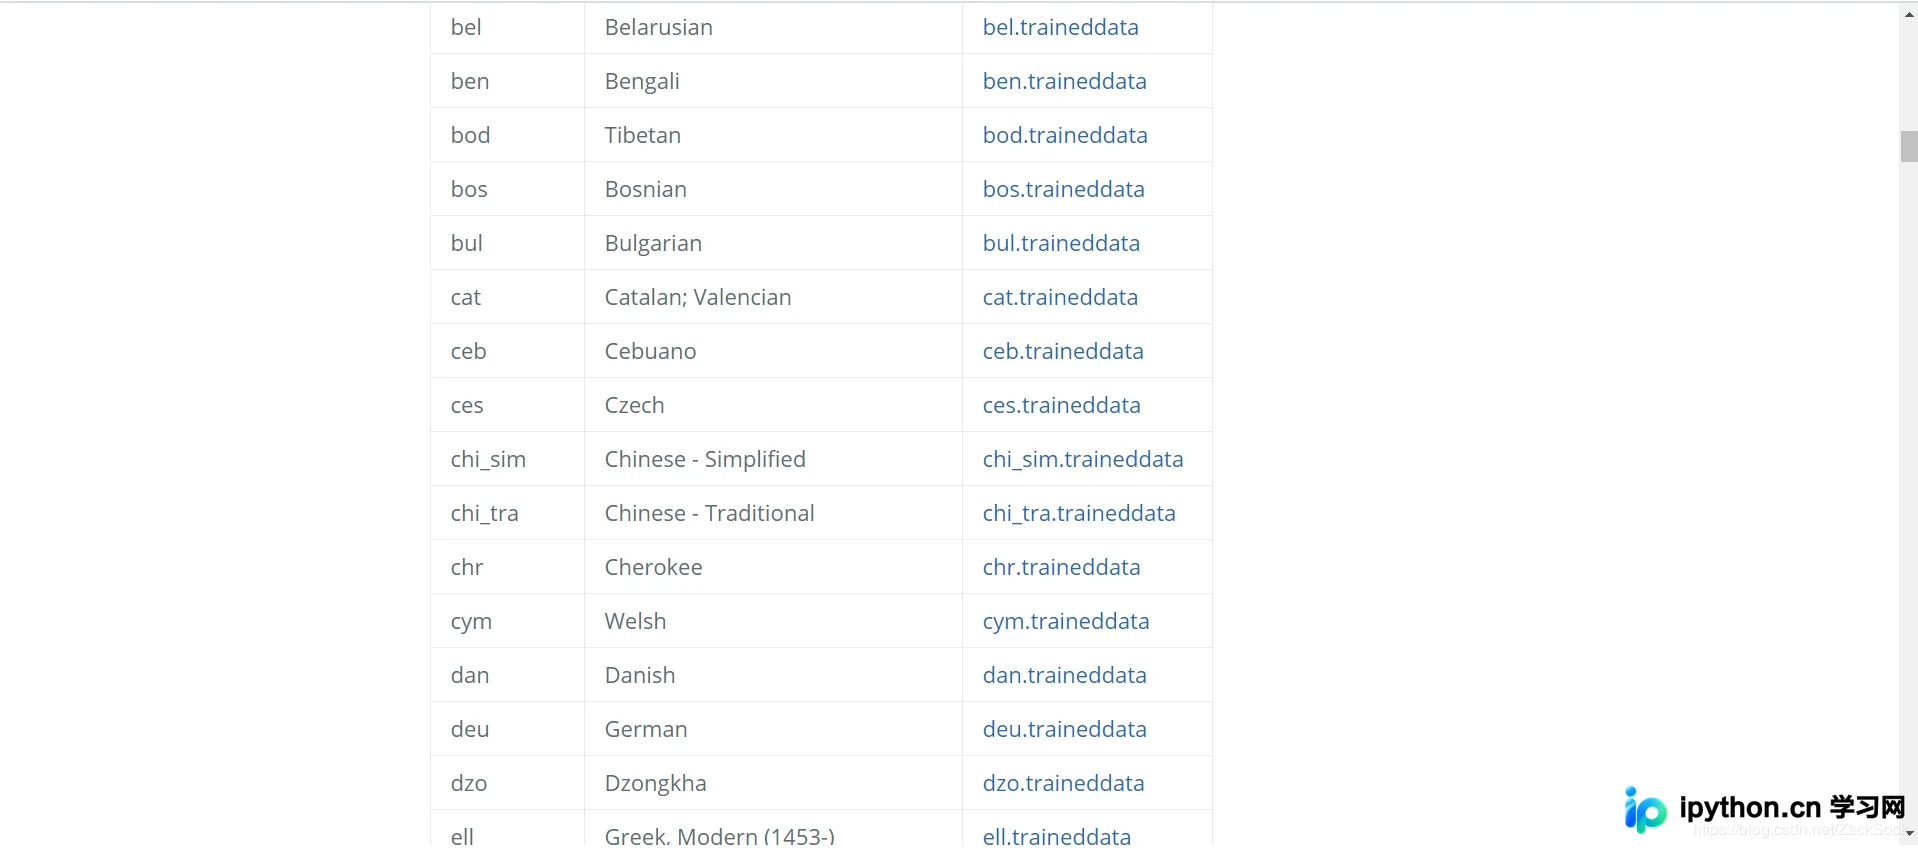
页面下方提供“Chinese-Simplified”(简体中文)和“Chinese-Traditional”(繁体中文)两个语言包,用户可根据需求下载。下载完成后,将语言包文件放置于Tesseract安装目录下的“tessdata”文件夹中,例如“D:\CodeField\Tesseract-OCR\tessdata”。
(3)其它模块下载
除Tesseract主程序外,还需安装两个Python模块以支持识别流程。
pip install pytesseract
pip install pillow
第一个模块用于调用Tesseract进行文字识别,第二个模块用于处理图片读取。完成上述步骤后,即可开始文字识别操作。
Python代码实现图片文字识别
三、文字识别
(1)单张图片识别
接下来的操作相对简单,待识别的图片示例如下:
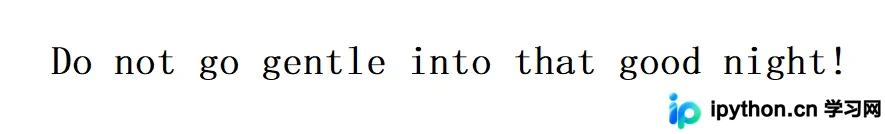
对应的Python识别代码如下:
import pytesseract
from PIL import Image
# 读取图片
im = Image.open('sentence.jpg')
# 识别文字
string = pytesseract.image_to_string(im)
print(string)
识别结果如下:
Do not go gentle into that good night!
由于Tesseract默认支持英文识别,因此可直接处理英文图片。若需识别中文或其他语言,则需进行相应配置修改。
import pytesseract
from PIL import Image
# 读取图片
im = Image.open('sentence.png')
# 识别文字,并指定语言
string = pytesseract.image_to_string(im, lang='chi_sim')
print(string)
在识别代码中设置参数“lang='chi_sim'”以指定简体中文语言。注意,只有当“tessdata”目录下存在简体中文语言包时,该设置才生效。待识别的图片示例如下:
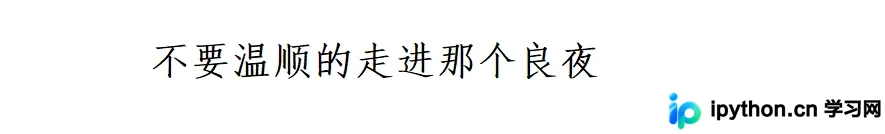
识别结果如下:
不 要 温 顺 的 走 进 那 个 良 夜
图片内容已被准确识别。值得注意的是,即使将语言设置为简体中文或其他非英文语言,Tesseract仍具备识别英文字符的能力。
批量图片识别与准确率分析
(2)批量图片识别
在实现单张图片识别的基础上,可进一步实现批量图片识别功能,这需要准备一个包含图片路径的txt文件。例如,创建“text.txt”文件,内容如下:
sentence1.jpg
sentence2.jpg
将代码修改为如下形式以读取txt文件:
import pytesseract
# 识别文字
string = pytesseract.image_to_string('text.txt', lang='chi_sim')
print(string)
手动编写txt文件较为繁琐,可通过以下代码自动获取图片路径并生成txt文件:
import os
import pytesseract
# 文字图片的路径
path = 'text_img/'
# 获取图片路径列表
imgs = [path + i for i in os.listdir(path)]
# 打开文件
f = open('text.txt', 'w+', encoding='utf-8')
# 将各个图片的路径写入text.txt文件当中
for img in imgs:
  f.write(img + '\n')
# 关闭文件
f.close()
# 文字识别
string = pytesseract.image_to_string('text.txt', lang='chi_sim')
print(string)
修改后,只需传入包含文字图片的根目录,即可实现批量识别。测试表明,Tesseract对宋体、印刷体等笔画严谨的字体识别准确率较高;但对于手写体、行楷等飘逸字体,识别效果不佳,复杂字体的识别率也有待提升。此外,若图片倾斜角度超过一定阈值,识别结果将出现显著偏差。
总结
本文介绍了利用Python进行图片文字识别的完整流程,包括环境配置、单张及批量识别的实现。更多关于Python识别图片文字的内容,可参考本站相关文章或继续浏览后续内容,感谢支持。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









