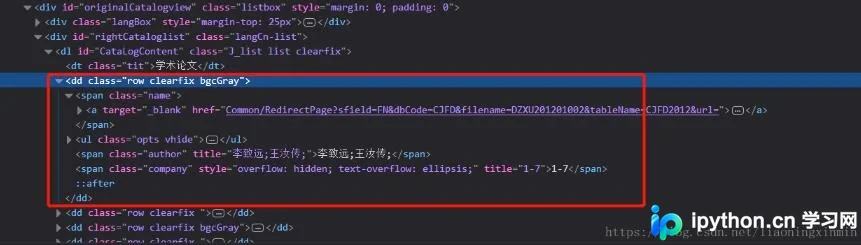
Python爬取梨视频实战:动态加载与URL拼接解析
本文详解使用Python爬取梨视频美食区视频的完整流程。针对视频URL动态加载及JSON数据中链接返回404的问题,通过分析请求头Referer参数及对比不同来源的URL结构,总结出正确的URL拼接规则。结合XPath解析与多线程下载,实现高效视频抓取。
2026-10-14
6

本文详解使用Python爬取梨视频美食区视频的完整流程。针对视频URL动态加载及JSON数据中链接返回404的问题,通过分析请求头Referer参数及对比不同来源的URL结构,总结出正确的URL拼接规则。结合XPath解析与多线程下载,实现高效视频抓取。
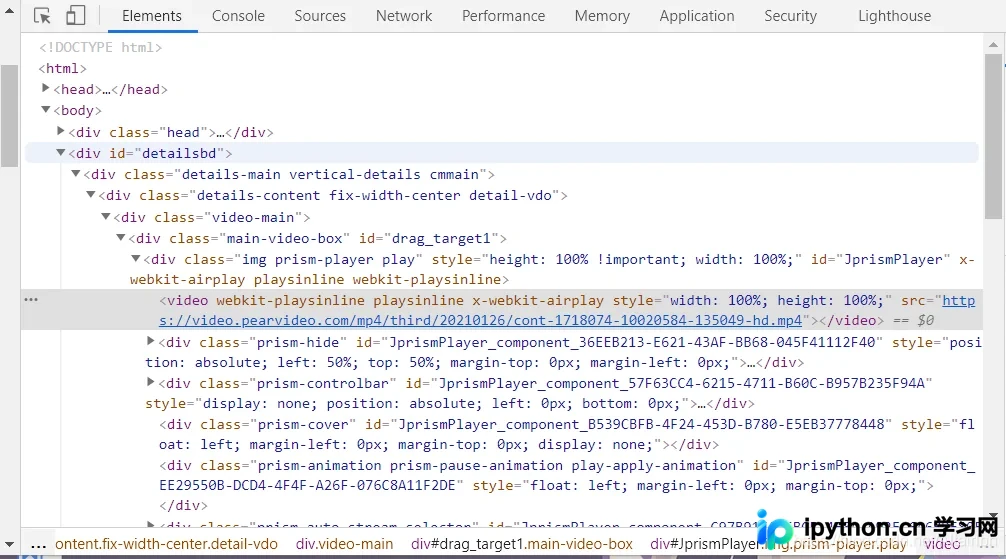
本文通过B站爬虫案例,指出Selenium中使用XPath直接获取属性(如./a/@href)会报错,正确做法是先定位元素节点再调用get_attribute()方法。文章提供了完整的Python代码示例,展示了如何在无头浏览器环境下解析网页数据并提取链接与标题。
本文介绍Python中高性能的lxml库,它基于C语言实现,支持HTML和XML数据的解析与提取。文章详细讲解了通过pip、PyCharm及官网三种方式安装lxml的方法,并演示了如何利用该库自动修复不规范HTML代码,以及通过字符串解析和文件读取两种方式提取数据的基本操作。
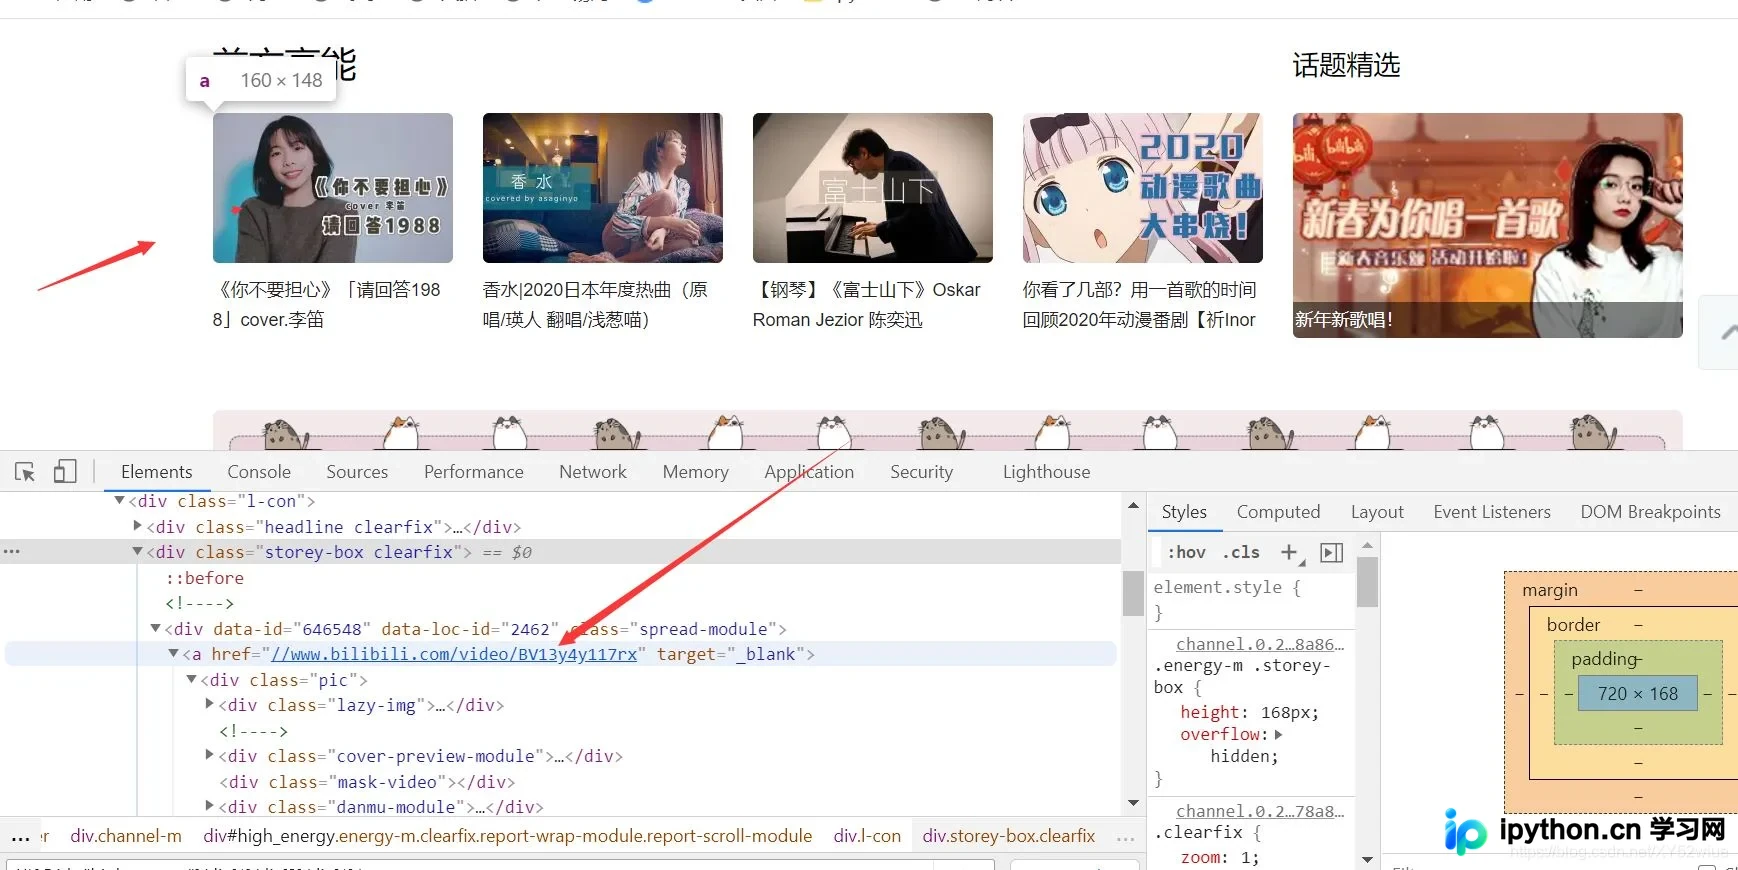
本文详解在Python Selenium中如何利用XPath根据元素文本内容精准定位元素。针对无固定ID或Class的场景,深入解析text()精确匹配与contains()模糊匹配两种核心方法,并附带完整代码示例,帮助开发者解决动态页面元素查找难题。
在使用Python lxml库解析HTML数据时,常因网页编码与程序解码不一致导致中文显示为乱码。本文介绍通过XPath定位节点后,利用encode('ISO-8859-1').decode('UTF-8')方法进行编码转换的技巧,有效解决数据抓取中的字符显示异常问题。
本文详解在PHP中通过DOMDocument加载XML文件,并利用DOMXPath对象执行XPath表达式查询特定节点的方法。包含构建查询对象、使用query()方法获取DOMNodeList及读取节点值的完整代码实现,适用于快速定位并提取XML数据。
本文全面介绍XPath(XML路径语言)的核心概念,包括其作为XSLT和XPointer共享语法的用途。详细解析了XPath的四种返回类型、节点树模型及地址路径语法(如/、//、@的使用)。同时系统梳理了核心函数库,涵盖节点集合、字符串处理、布尔逻辑及数字运算函数,为XML数据提取和Web自动化测试提供基础参考。
本文介绍使用 Python 的 Selenium 库抓取页面点击后弹出的窗口信息。通过 Firefox 浏览器配合 GeckoDriver,利用 XPath 定位元素并切换窗口句柄获取数据。针对自动化测试中点击按钮弹窗不显示的问题,提供使用模拟键盘 Enter 键替代 click() 的解决方案,并附带完整代码示例。
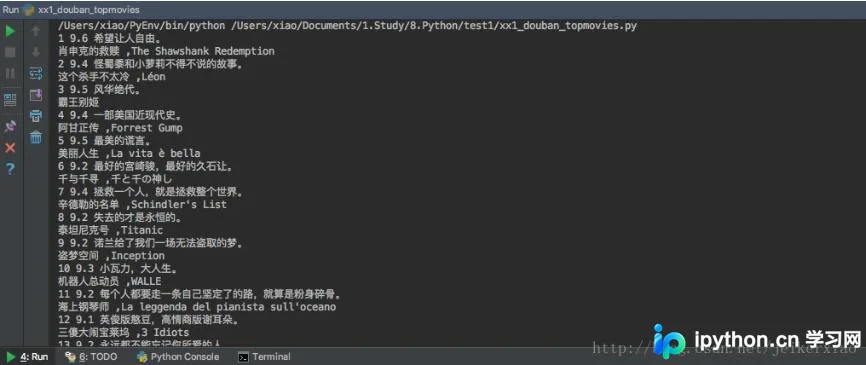
本文通过豆瓣电影Top250及新浪新闻两个实例,详细演示了Python3中requests库发送HTTP请求与lxml库etree模块进行XPath解析的完整流程。内容涵盖会话保持、编码处理、节点定位及数据清洗,帮助开发者掌握基础的网页抓取与解析技术。
本文详细介绍Python3中xml.etree.ElementTree模块支持的有限XPath表达式语法。内容涵盖标签名、通配符、属性过滤、文本匹配及位置索引等核心用法,并通过具体代码示例演示如何在XML文档中精准定位子元素、孙子元素及特定属性节点,帮助开发者高效进行XML数据提取与处理。
本文详解Python中XPath解析定位的六种核心方法。内容涵盖绝对路径与相对路径的区别、基于索引的定位、节点属性精确匹配、部分属性值模糊匹配(如contains、starts-with),以及多条件组合定位技巧。通过具体代码示例,帮助开发者掌握高效精准的网页数据抓取定位策略。
本文介绍如何使用Python的lxml库通过XPath定位HTML文档中的特定元素,并解决提取内容中出现的中文乱码问题。通过html.tostring获取字节流后,利用HTMLParser.unescape方法将HTML实体编码转换为可读字符串,从而完整保留原始文本内容。