Python爬虫突破反爬:通过设置Cookie爬取蚂蚁短租数据详解
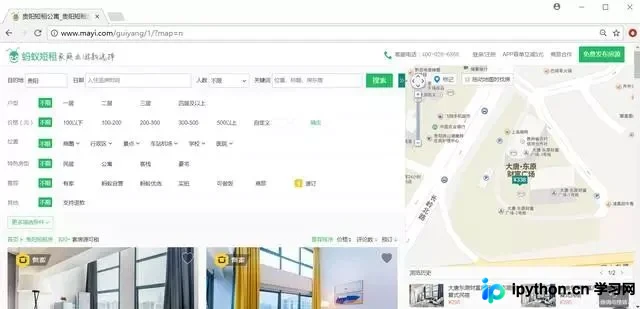
本文详细介绍如何使用Python爬虫应对网站反爬机制。针对蚂蚁短租的访问拦截,通过浏览器开发者工具获取Cookie和User-Agent,并在Python代码中通过urllib2设置Headers提交请求。结合BeautifulSoup解析HTML节点,成功获取贵阳地区短租房的名称、价格、评分及链接等详细信息,并存储为CSV文件。
2026-10-15
5

本文详细介绍如何使用Python爬虫应对网站反爬机制。针对蚂蚁短租的访问拦截,通过浏览器开发者工具获取Cookie和User-Agent,并在Python代码中通过urllib2设置Headers提交请求。结合BeautifulSoup解析HTML节点,成功获取贵阳地区短租房的名称、价格、评分及链接等详细信息,并存储为CSV文件。
本文详细讲解使用Python爬取微博评论的完整流程。内容涵盖微博爬虫的难度分级、接口URL构造、HTML标签去除及正则表达式应用,并提供了基于requests和pandas的两种代码实例,帮助开发者掌握从确定用户ID到保存CSV文件的实际操作步骤。
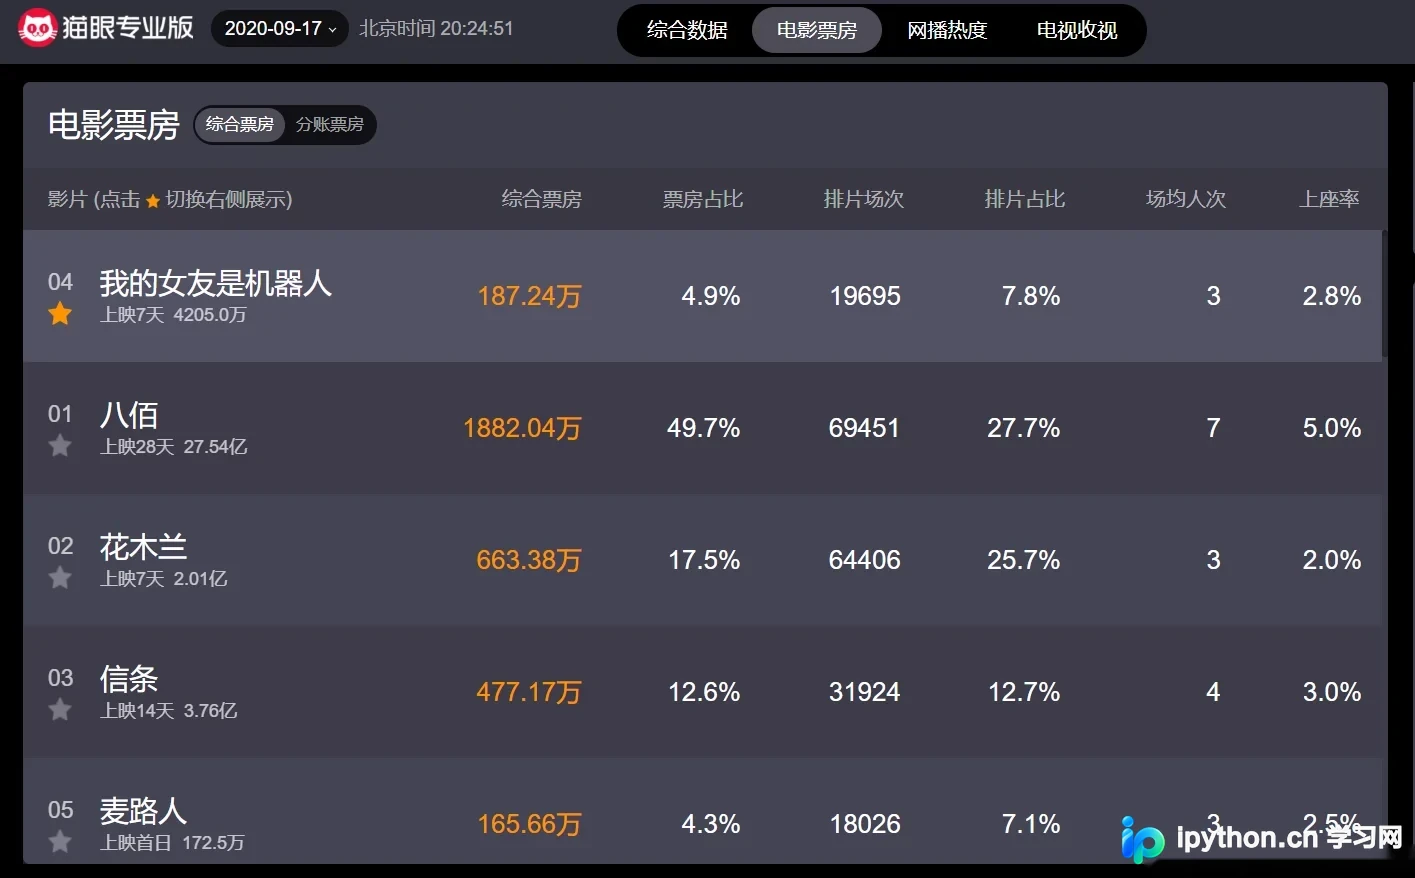
本文详细介绍如何使用Python抓取猫眼电影最近上映电影的票房信息。通过配置Python 3.6环境,利用requests模块发送HTTP请求获取JSON数据,解析电影名、票房、排片占比等关键字段,并最终将结果保存至CSV文件。适合Python初学者进行数据抓取实战练习。
本文通过Python 3.7环境,演示如何使用Requests发起HTTP请求并处理GBK编码,结合BeautifulSoup解析HTML结构以提取51job职位列表。文章详细讲解了数据获取、解析及保存至JSON文件的完整流程,并探讨了多线程、动态渲染及数据库存储等进阶优化方向。
本文详细汇总了Python下载网络图片的多种方法,涵盖从已知URL直接下载到通过正则表达式和BeautifulSoup解析HTML获取链接的批量处理技巧。针对动态网页和反爬机制,提供了User-Agent模拟、Referer设置、IP池及Cookie管理等解决方案,并介绍了Selenium动态加载与Pyautogui模拟点击等进阶策略,帮助开发者高效完成图片抓取任务。
本文详细解析使用Python Scrapy框架进行多页数据爬取的实现过程。通过定义通用URL模板,在parse方法中利用递归逻辑手动发送后续页码的请求,从而实现对多页内容的自动抓取与解析。
本文详解如何利用Python从www.weather.com.cn批量爬取指定数量的图片。通过对比单线程与多线程两种实现方式,展示请求头构造、HTML解析、正则提取图片链接及本地保存的完整流程。重点解析多线程模块threading的使用及异常处理,帮助开发者提升数据抓取效率。
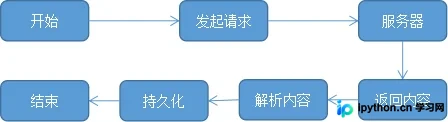
本文详细介绍Python爬虫的核心流程,涵盖使用requests获取网页数据、利用lxml进行HTML解析,以及将数据保存为CSV文件或存入MySQL数据库的具体实现。通过完整代码示例,演示如何处理动态页面、登录状态及异常捕获,帮助开发者快速掌握网络数据采集与持久化技术。
本文详细介绍如何使用Python爬取B站热门视频排行榜Top100的数据。通过伪装浏览器请求、利用BeautifulSoup和正则表达式解析网页源码,并将排名、标题、播放量等七项关键信息保存至SQLite数据库。教程涵盖核心代码逻辑与数据保存策略,适合Python初学者参考学习。
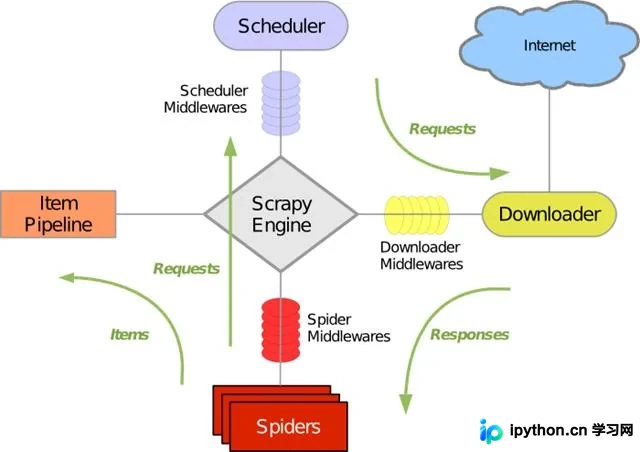
本文详细介绍如何使用Python Scrapy框架进行小说网站数据爬取。内容涵盖Scrapy架构解析、项目与Spider创建、XPath数据提取、Items字段定义、Pipeline数据处理及Settings配置。通过fiction.py等核心代码示例,演示从章节列表解析到内容保存至TXT文件的完整流程,适合初学者掌握Scrapy实战应用。
本文介绍Python爬虫在爬取商品时因反爬机制导致失败的处理方法。通过浏览器开发者工具分析Network请求,提取有效的Cookie和User-Agent信息,并将其添加到headers中。文章提供了完整的代码示例,展示如何正确构建请求头以绕过基础反爬验证,确保数据抓取成功。
本文详解如何使用Python编写爬虫程序,通过requests获取爱奇艺热门电影页面源码,并利用BeautifulSoup解析HTML结构,提取电影链接与名称等关键信息。教程涵盖环境配置、代码实现及结果验证,帮助开发者快速掌握基础网页数据抓取技巧。