

MySQL海量数据水平切分与分布式访问架构设计
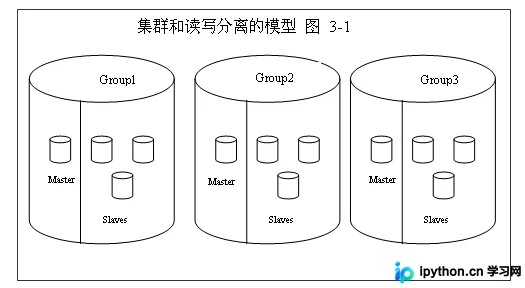
针对单一MySQL节点性能瓶颈,本文阐述基于ORM框架层的分布式数据访问解决方案。核心通过user_id等字段进行水平切分(Sharding),采用号段或Hash取模规则实现数据均匀分布。结合集群化部署实现Master写Slave读的读写分离,并引入负载均衡与节点心跳探测机制,以低硬件成本构建高可用、高扩展的海量数据存储系统。
2026-10-16
2

针对单一MySQL节点性能瓶颈,本文阐述基于ORM框架层的分布式数据访问解决方案。核心通过user_id等字段进行水平切分(Sharding),采用号段或Hash取模规则实现数据均匀分布。结合集群化部署实现Master写Slave读的读写分离,并引入负载均衡与节点心跳探测机制,以低硬件成本构建高可用、高扩展的海量数据存储系统。
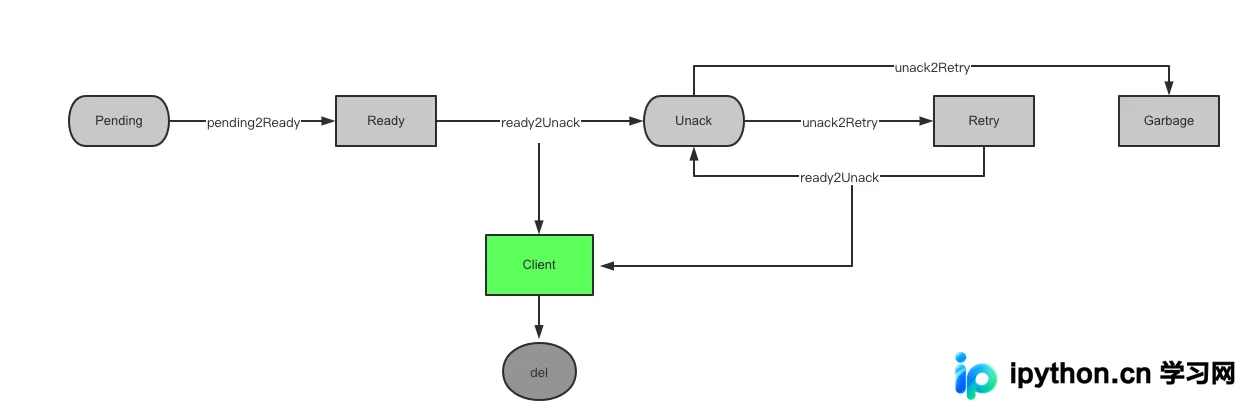
针对Go语言缺乏成熟Redis延时队列库的现状,介绍一种基于Redis ZSet、List和Hash结构构建的高可用延迟队列方案。该方案利用Lua脚本保证原子性,通过Pending、Ready、Unack等多状态流转及ACK/NACK重试机制,实现分布式环境下的消息至少投递一次,确保零丢失与高并发下的数据一致性。
本文详细介绍如何在Go中使用第三方库Sarama实现Kafka消息的生产和消费。通过配置SyncProducer发送消息到指定Topic和分区,并获取Partition ID与Offset验证写入成功;同时演示利用NewConsumer创建多个Partition Consumer协程,遍历所有分区持续拉取最新消息,提供完整的代码示例与关键参数说明。
本文介绍如何在 Python 分布式系统中利用 hmac 模块实现轻量级的客户端连接认证。通过服务器发送随机字节、双方计算 HMAC 摘要并使用 compare_digest 进行恒定时间比较,可有效防止时间分析攻击。方案适用于内部进程间通信,但需注意认证不等于加密,后续通信仍为明文。
本文详解Erlang通过open_port调用Python脚本实现字符串处理的方法。利用gen_server管理端口生命周期,Erlang发送指令至Python进程,Python解析输入并返回结果后退出。该方案解决了Erlang字符串处理能力的不足,为构建混合语言分布式系统提供了可行路径。
本文介绍基于Python构建分布式测试框架的方案,利用主控机调度与执行机RPC调用实现扩展性。通过SimpleXMLRPCServer部署服务,结合多进程(fork)与多线程技术,在多个节点上并行执行测试任务,有效弥补Python执行效率的不足,实现高并发压力测试。
本文汇总Python爬虫及后端开发常见面试题,深入解析线程与网络的同步异步机制、顺序表与链表的优劣对比。详细阐述Redis的五种数据结构及其命令,以及MySQL中InnoDB与Memory引擎的适用场景,帮助开发者应对技术面试。
本文深入解析Python构建网页爬虫的核心原理,涵盖从单线程基础实现到分布式系统扩展的关键环节。重点讨论抓取频率控制、URL去重策略(如布隆过滤器)、HTML解析挑战及性能瓶颈优化,为系统设计面试提供完整解决方案。
本文详解 Python 内置 uuid 模块的核心机制,对比各版本特性并提供格式化方法。结合数据库主键设计、分布式服务追踪等实战代码,剖析查询性能优化策略与二进制存储方案,并明确唯一性与保密性的安全边界,帮助开发者在生产环境中高效生成可靠的全局标识符。