

Python爬虫网络请求:IP代理、Cookie与异常处理详解
本文详解Python爬虫中的三大核心要素:IP代理(透明、匿名、高匿)用于规避频率限制;Cookie机制解决HTTP无状态问题,通过MozillaCookieJar实现持久化存储;以及urllib.error模块对URLError和HTTPError的捕获与属性解析,帮助开发者构建稳定的网络请求程序。
2026-10-15
7

本文详解Python爬虫中的三大核心要素:IP代理(透明、匿名、高匿)用于规避频率限制;Cookie机制解决HTTP无状态问题,通过MozillaCookieJar实现持久化存储;以及urllib.error模块对URLError和HTTPError的捕获与属性解析,帮助开发者构建稳定的网络请求程序。
本文详细介绍 Python Selenium 中两种核心元素等待机制:显式等待与隐式等待。通过 WebDriverWait 类结合 expected_conditions 实现精准的元素状态检测,以及利用 implicitly_wait 设置全局超时轮询。文章包含完整代码示例与参数解析,帮助开发者解决页面加载不同步导致的定位失败问题,提升爬虫稳定性。
本文解析Python爬虫选用MongoDB的核心原因。MongoDB采用文档存储方式,直接支持JSON和List结构,无需预定义表结构即可随时创建集合。其模式自由特性允许每条记录字段长度不一致,完美适配爬虫获取的杂乱非结构化数据。此外,MongoDB具备高性能、易部署、支持动态查询及多语言接口等优势,是处理海量爬虫数据的理想选择。
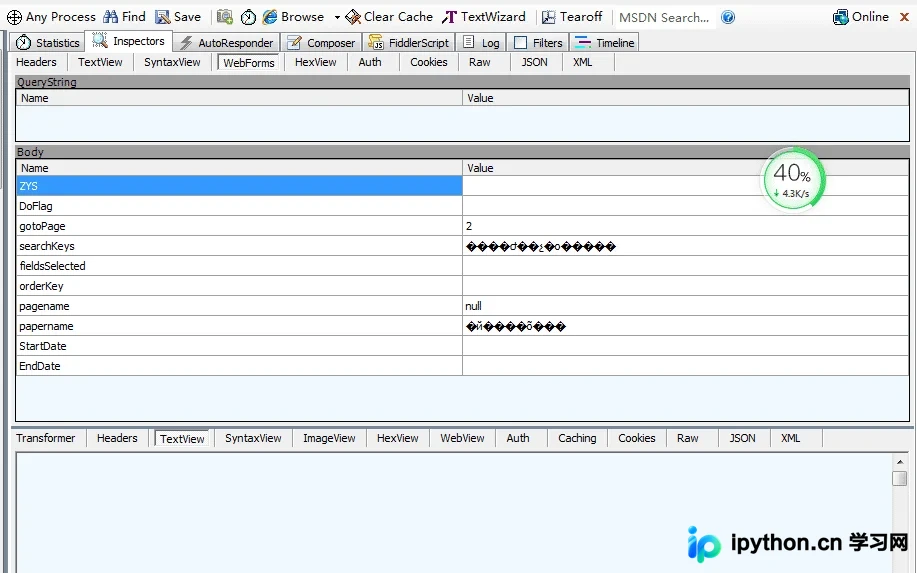
本文解析Python爬虫抓取网站时遇到的URL参数乱码问题。通过示例展示如何将中文字符串按GBK2312编码后进行百分号编码,利用urllib.quote函数生成符合要求的URL参数格式,帮助开发者解决中文请求参数乱码困扰。
本文解答Python爬虫是否容易学习的问题,解析网络爬虫的基本概念与工作原理。详细介绍企业数据、购买渠道及公开数据等来源,阐述基于URL、HTML和HTTP协议的抓取流程,并提供使用urllib库获取视频链接的Python代码示例,帮助初学者掌握基础爬虫技能。
本文介绍如何使用Python的gevent库实现高效的并发下载器。通过monkey.patch_all()替换标准库,利用gevent.spawn生成协程,实现多张图片的同时下载。代码包含核心逻辑与完整示例,适用于需要提升网络IO效率的Python开发场景。
本文详解如何利用Python的browsercookie模块自动从Chrome、Firefox等主流浏览器中提取已保存的Cookie,解决爬虫登录验证难题。通过安装配置、代码示例及requests库结合使用,实现无需手动输入账号密码即可访问需登录状态的网页内容,提升数据采集效率。
本文详细解析使用Python爬取微博特定用户评论的技术流程。针对微博主页及详情页的Ajax动态加载特性,通过逆向分析接口规律获取数据。重点介绍如何处理源码中的转义字符与HTML实体编码,利用正则表达式提取关键ID,并拼接评论接口URL。文中包含完整的代码实现及Cookie配置注意事项,旨在帮助开发者掌握动态网页数据抓取的核心技巧。
本文介绍利用Python编写爬虫程序,自动从指定网站批量抓取动态GIF图片的方法。通过解析HTML页面获取图片链接,并实现多页循环下载与本地存储,解决手动保存繁琐及部分网站禁止右键的问题。
本文详细介绍利用Python爬虫下载网页中图片、文档等资源的三种方法。通过解析网页源码获取资源URL,分别演示了使用urllib.urlretrieve直接下载、requests库同步全量下载以及开启stream参数进行分块写入的实现代码。重点解析了分块下载在处理大文件时节省内存的优势,并提供了批量下载多个资源的通用逻辑思路。
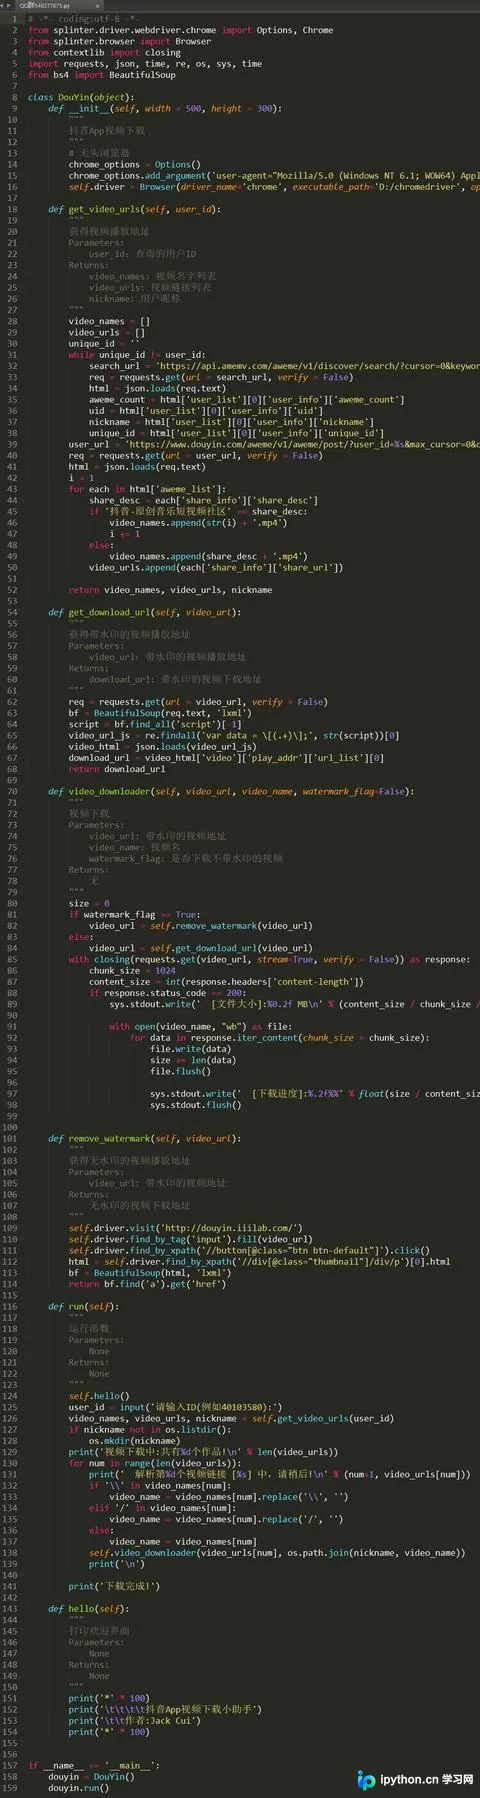
本文介绍两种Python实现抖音无水印视频下载的方法。第一种利用去水印平台接口,通过Splinter无头浏览器模拟操作以绕过付费解析限制;第二种基于URL字符串替换技巧,直接修改播放地址中的特定参数获取无水印源。文章提供了相关代码逻辑与注意事项,旨在帮助开发者快速实现视频抓取功能。
本文详解Python爬虫中设置代理IP的方法,解决高频访问导致的封禁问题。通过requests和bs4库从西刺代理获取免费IP列表,构建随机代理字典,并演示如何在get请求中应用。针对反爬机制提供定时抓取建议,帮助开发者有效规避IP封锁风险。