Python破解起点中文网月票榜字体反爬策略实战
本文详细解析起点中文网月票榜的字体反爬机制,通过Python结合requests、lxml和fonttools库,实现从HTML中提取加密字体文件,解析Unicode编码映射关系,最终还原书名与月票数。教程涵盖XPath定位、正则提取及字体文件动态加载,提供完整代码示例与常见错误排查。
2026-10-15
6

本文详细解析起点中文网月票榜的字体反爬机制,通过Python结合requests、lxml和fonttools库,实现从HTML中提取加密字体文件,解析Unicode编码映射关系,最终还原书名与月票数。教程涵盖XPath定位、正则提取及字体文件动态加载,提供完整代码示例与常见错误排查。
本文介绍基于Python3和Windows环境的爬虫开发基础,涵盖Anaconda与Jupyter工具使用。详细解析Robots协议规范、动态页面处理及反爬策略。同时展望Python在数据分析、人工智能、运维自动化及Web开发领域的核心应用与实战价值。
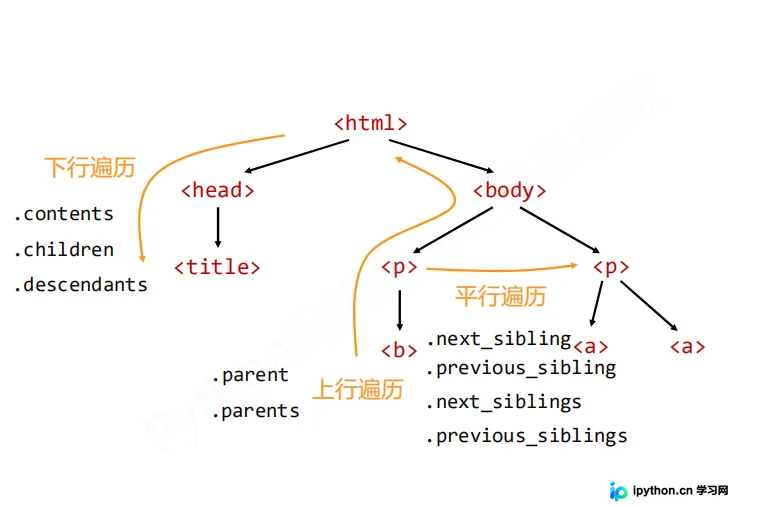
本文详细介绍Python中BeautifulSoup库的安装方法及核心功能。内容涵盖从bs4库的引用、BeautifulSoup类的基本概念,到Tag标签的name、attrs及字符串类型解析。重点讲解标签树的上下行与平行遍历操作,以及prettify()格式化输出和编码处理,帮助开发者快速掌握HTML/XML文档解析技巧。
本文详细介绍使用Python进行验证码识别的完整流程。从批量下载验证码图片开始,通过二值化与灰度转换初步处理,重点讲解利用PIL库实现8邻域降噪算法去除干扰线。针对彩色验证码,提出基于颜色过滤的智能去噪策略,并结合Tesseract或tesserocr库实现最终的文字识别,提供完整代码示例与效果对比。
本文详细演示如何利用Python逆向分析APP数据。通过Fiddler抓包发现SSL Pinning,使用Xposed和JustTrustme绕过;利用ApkScan查壳、frida-DEXDump脱壳及jadx反编译定位加密逻辑。最终通过Frida Hook获取AES密钥,在Python中复现加解密过程,成功抓取APP接口数据。
本文深入解析Python requests库中timeout参数的两种设置方式:单一值与元组形式。重点指出连接超时默认21秒而读取超时无默认值易导致程序永久挂起的风险,并提供针对高并发场景的超时配置建议及常见卡死问题的解决方案。
本文详细介绍如何使用Python爬虫应对网站反爬机制。针对蚂蚁短租的访问拦截,通过浏览器开发者工具获取Cookie和User-Agent,并在Python代码中通过urllib2设置Headers提交请求。结合BeautifulSoup解析HTML节点,成功获取贵阳地区短租房的名称、价格、评分及链接等详细信息,并存储为CSV文件。
本文介绍如何使用Python实现B站直播自动发送弹幕功能。通过抓取直播间发送弹幕的Post请求接口,利用requests库模拟提交数据,结合Tkinter构建简易图形界面,实现指定房间号的弹幕自动发送。代码包含随机弹幕选取、请求参数构造及循环发送逻辑,供技术参考。
新版Selenium已不再支持PhantomJS,本文详细介绍如何在Python爬虫项目中安装并配置ChromeDriver以支持动态网页抓取。内容涵盖安装必要性、官方资源链接,以及针对Mac系统的Homebrew安装方法(含备用方案)和Windows环境下的版本验证步骤,帮助开发者顺利实现Headless Chrome自动化测试与数据采集。
本文详解如何在Python Scrapy框架中集成browsercookie库,通过读取本地Firefox浏览器的Cookie实现免登录爬取。重点讲解如何替换默认的CookiesMiddleware,处理Chrome 80版本后的加密差异,并演示如何构造POST请求完成自动化点赞操作,为需要登录态的爬虫提供实用方案。
本文详细总结Python爬虫突破反爬虫机制的核心技术。内容涵盖构建合理的HTTP请求头、Cookie管理、访问延迟控制及代理IP使用。深入解析验证码(简单识别与人工打码)、IP封禁、滑动验证、防盗链关联上下文、JS运算及WebFont等常见反爬策略的应对方案,帮助开发者提升数据采集成功率。
本文详解如何利用Python从www.weather.com.cn批量爬取指定数量的图片。通过对比单线程与多线程两种实现方式,展示请求头构造、HTML解析、正则提取图片链接及本地保存的完整流程。重点解析多线程模块threading的使用及异常处理,帮助开发者提升数据抓取效率。