

JS逆向:破解 webpack 打包站点及 JS 代码扣取实战
本文详解如何识别并破解前端 webpack 打包的加密 JS 代码。通过分析典型模块执行逻辑,实战演示如何通过浏览器开发者工具定位关键函数(如 encode),构建局部运行环境,剥离核心加解密代码到本地 JavaScript 文件中独立执行,从而实现数据抓取中的算法复现。
2026-10-15
6

本文详解如何识别并破解前端 webpack 打包的加密 JS 代码。通过分析典型模块执行逻辑,实战演示如何通过浏览器开发者工具定位关键函数(如 encode),构建局部运行环境,剥离核心加解密代码到本地 JavaScript 文件中独立执行,从而实现数据抓取中的算法复现。
本文介绍在Python爬虫中获取非唯一指定内容的方法。当XPath无法直接定位目标时,可通过遍历节点并结合条件判断进行筛选。文章提供基于urllib和lxml的完整代码示例,展示如何构建请求、解析HTML并过滤关键词,同时指出原代码存在冗余问题,旨在为开发者提供清晰的筛选逻辑参考。
本文详细介绍Python中Beautiful Soup库的使用方法。涵盖安装、四大核心对象(Tag、NavigableString、BeautifulSoup、Comment)的解析,文档树遍历与搜索技巧(find_all、find、select),以及综合实例与lxml对比。
本文详解Python爬虫中urllib模块的异常处理机制。重点解析URLError(主机错误)与HTTPError(路径或参数错误)的区别与捕获顺序,通过具体代码实例演示如何构建健壮的爬虫程序,确保在网络请求失败时能正确识别错误类型并执行相应处理逻辑。
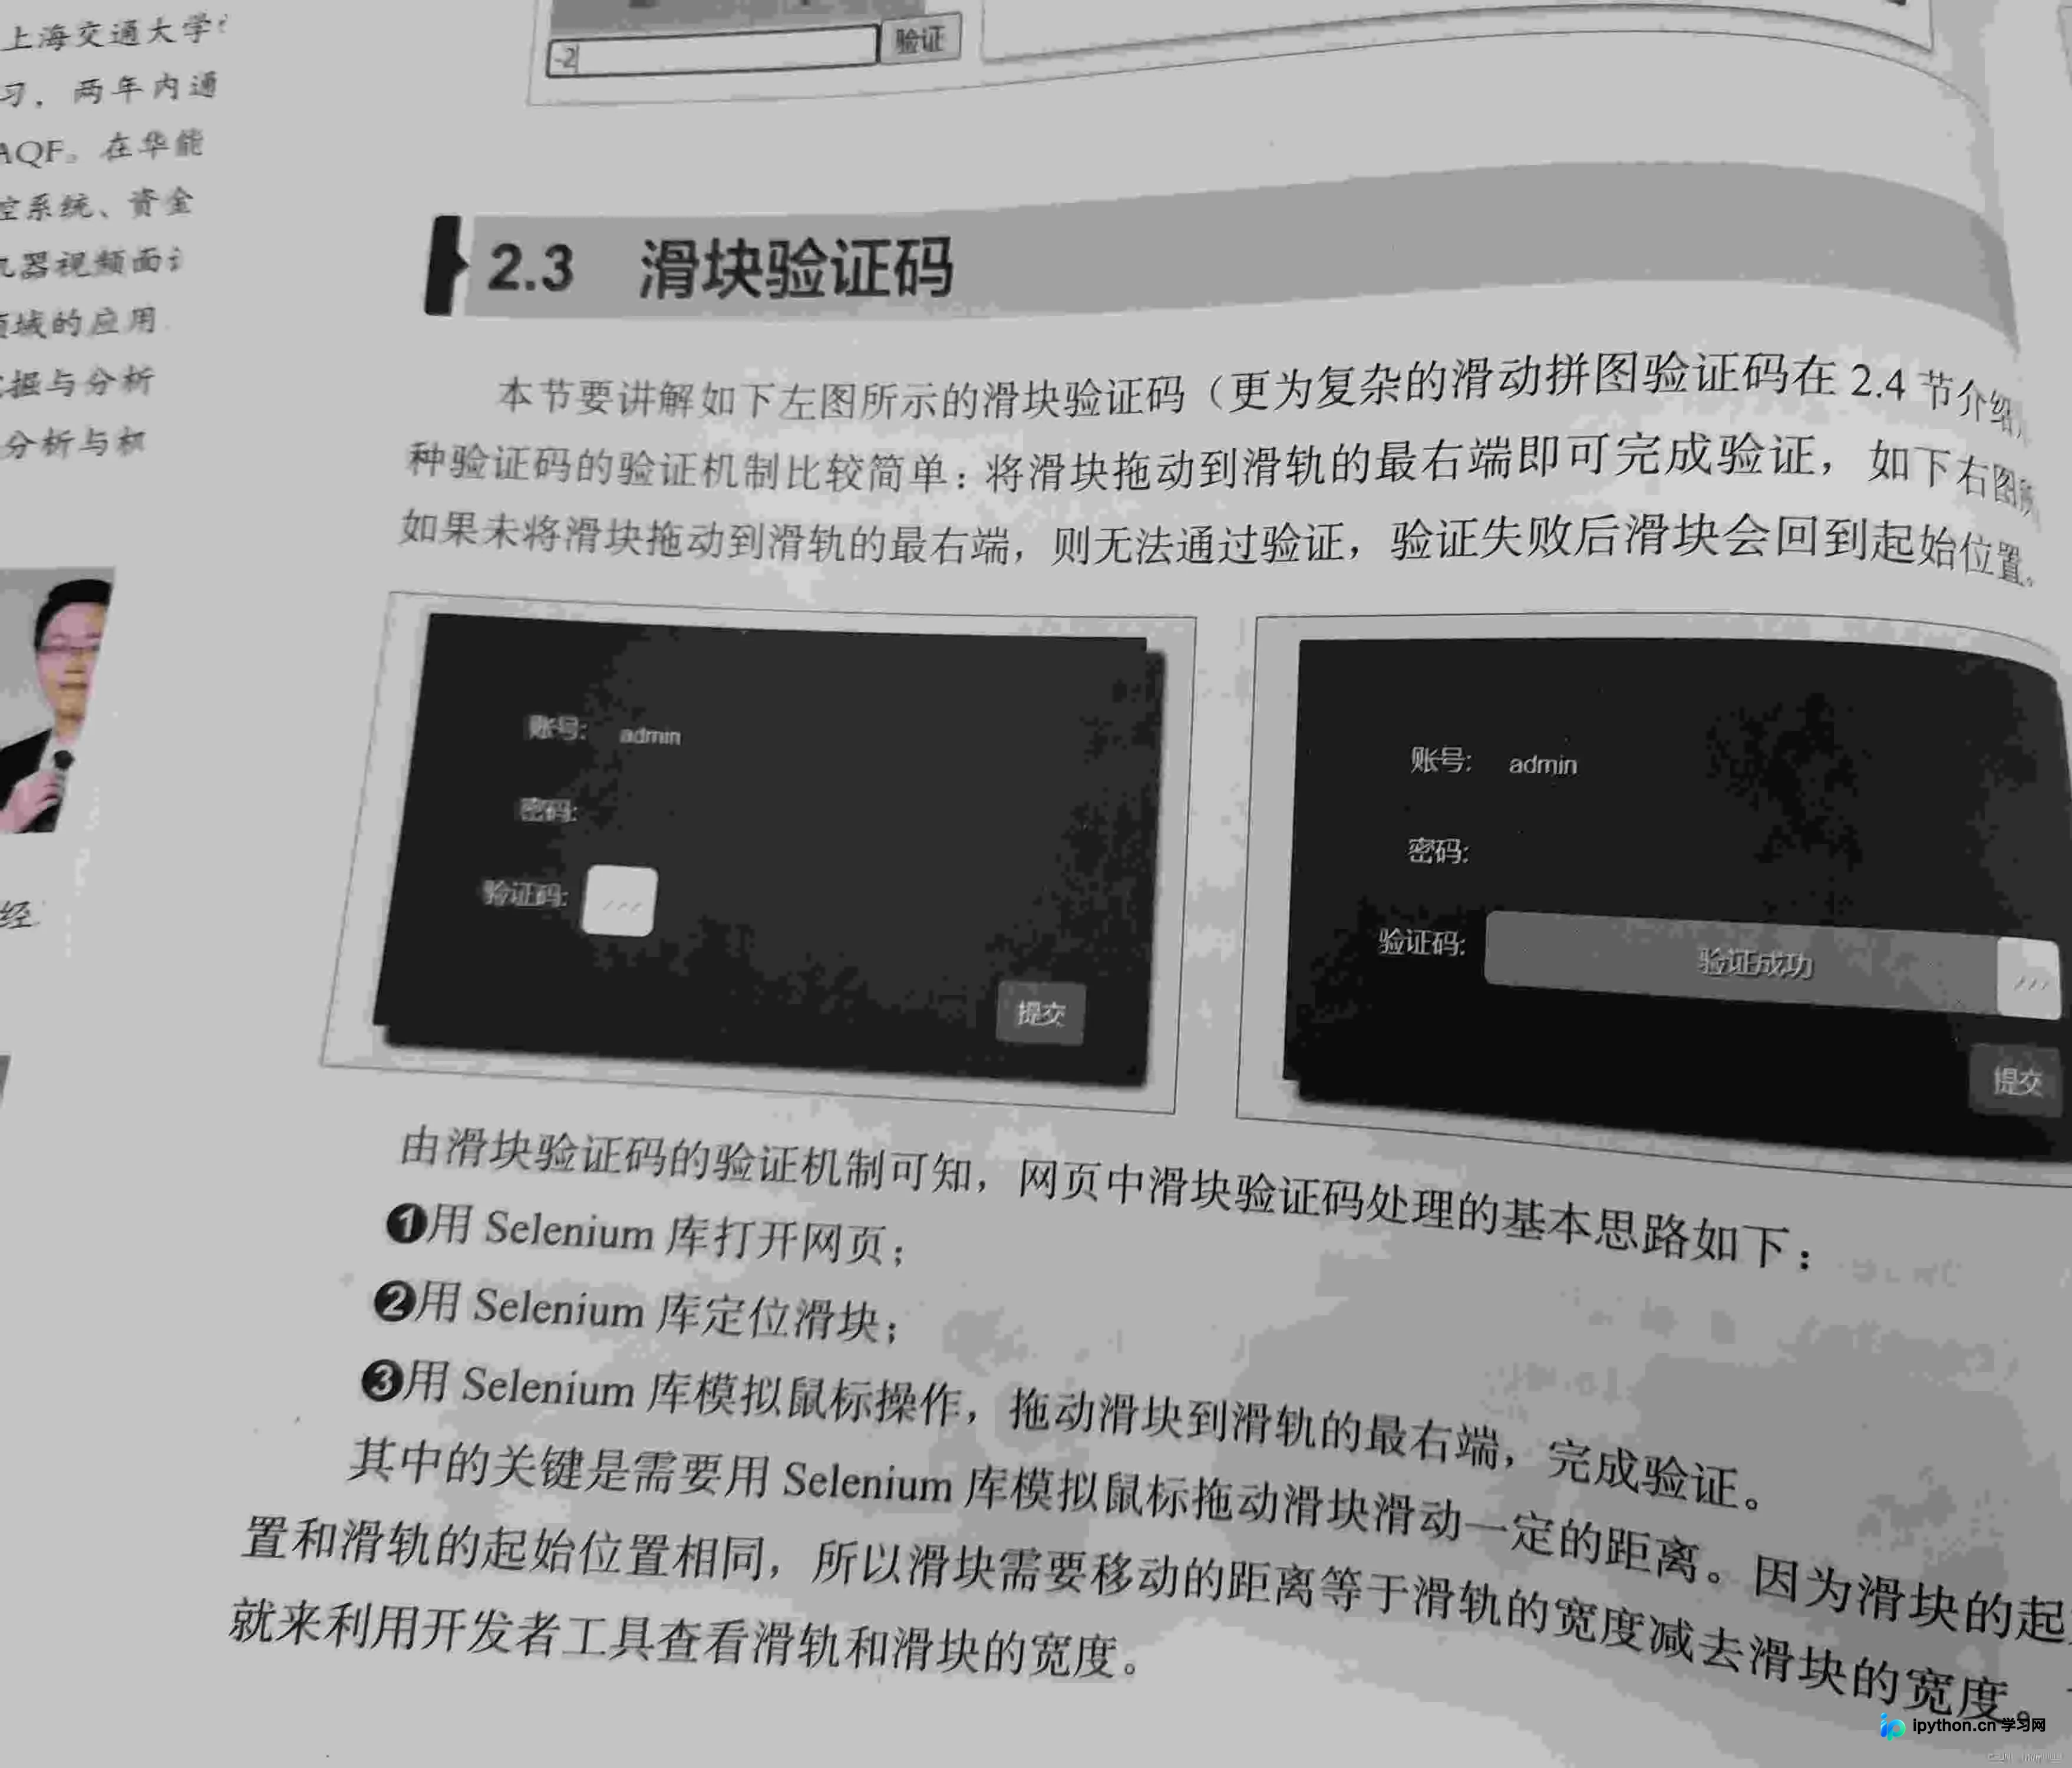
本文详解如何使用Python Selenium库模拟滑块验证码。通过开发者工具获取滑轨与滑块尺寸,计算需移动的距离(如260像素),并利用ActionChains模块的click_and_hold、move_by_offset及release方法模拟鼠标拖拽动作。此外,还介绍了针对webdriver检测的反爬应对策略,包括手动登录配合Selenium继续爬取的方案。
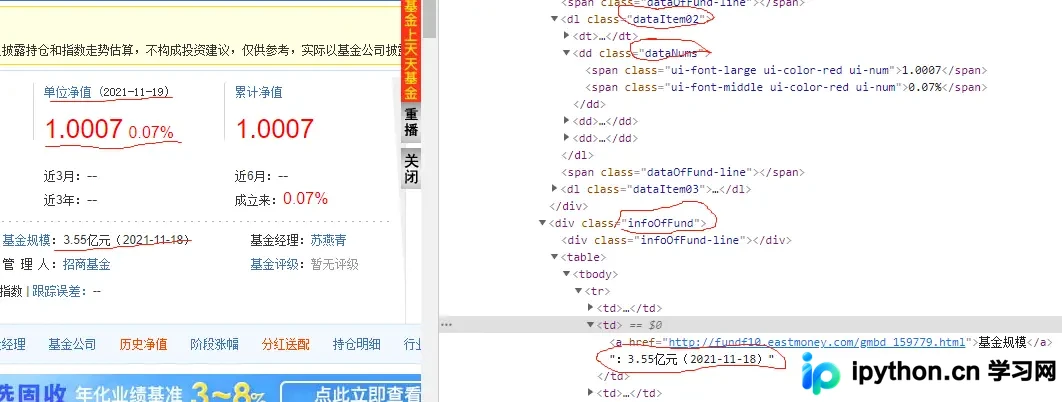
本文详解如何使用Python爬虫获取基金最新交易日的单位净值、涨跌幅及基金规模数据。通过解析HTML标签定位关键信息,并结合pymysql库进行数据库连接配置与SQL操作,实现数据的结构化存储,为后续基金分析与投资决策提供数据支持。
本文详解Python爬虫中的三大核心要素:IP代理(透明、匿名、高匿)用于规避频率限制;Cookie机制解决HTTP无状态问题,通过MozillaCookieJar实现持久化存储;以及urllib.error模块对URLError和HTTPError的捕获与属性解析,帮助开发者构建稳定的网络请求程序。
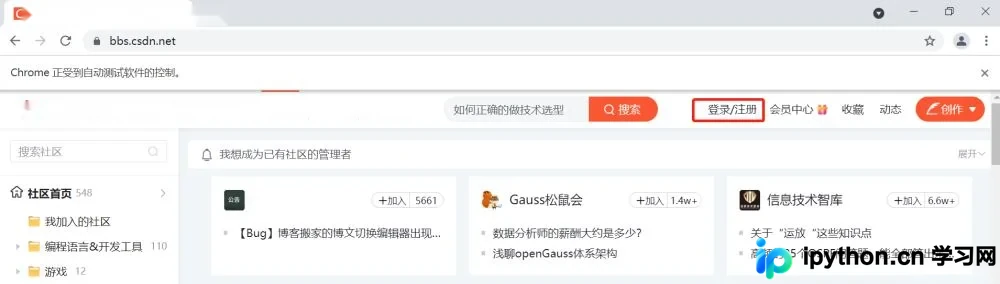
本文详解如何利用 Selenium 控制已打开的 Chrome 浏览器,通过指定 user-data-dir 和 remote-debugging-port 参数,实现复用本地浏览器的缓存与登录信息。适用于需要保持登录状态进行网页爬取或自动化操作的场景,避免重复模拟登录。
本文详细介绍如何使用Python编写一个简单的爬虫程序,批量下载电脑壁纸。通过结合Requests进行HTTP请求、XPath解析HTML结构以及Pinyin库处理中文路径,实现从指定类型和页码中自动抓取高清壁纸。文章涵盖工具准备、核心代码逻辑解析及完整可运行代码,旨在提供技术交流参考,非商业用途。
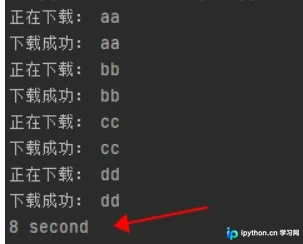
本文对比了Python单线程与多线程爬虫的性能差异,详细讲解了如何使用multiprocessing.dummy模块中的Pool类构建线程池。通过具体代码案例,展示了如何利用线程池处理阻塞型网络请求,从而显著缩短视频数据下载时间,适用于需要批量处理耗时操作的场景。
本文详细介绍如何利用 Python 结合 Selenium 自动化框架,实现对网页中 Table 表格数据的完整抓取与分页处理。通过解析 DOM 结构获取总页数,循环遍历每一页数据并提取关键信息,包括隐藏的 href 超链接。最终将所有采集到的数据整合并保存为本地 CSV 文件,适用于需要批量获取结构化网页内容的场景。
本文介绍如何使用Python脚本自动抓取免费代理IP并验证其可用性。针对网站IP频率限制(如每小时1000条),通过切换代理IP突破限制,将40天的采集时间大幅缩短。脚本包含获取代理列表和测试代理有效性的核心功能,帮助开发者高效解决爬虫被封禁问题。