

Python实现Unicode转中文及解决默认编码问题的方法
本文介绍Python中将Unicode编码转换为中文的方法,并深入分析Python2中修改默认编码为UTF-8的潜在风险。通过示例展示了改变sys.setdefaultencoding可能导致编码错误和字典行为异常,最后给出显式编码转换的最佳实践建议。
2026-10-13
2

本文介绍Python中将Unicode编码转换为中文的方法,并深入分析Python2中修改默认编码为UTF-8的潜在风险。通过示例展示了改变sys.setdefaultencoding可能导致编码错误和字典行为异常,最后给出显式编码转换的最佳实践建议。
本文详解Python中遍历含汉字字符串时因编码不同导致的字符长度差异。分析UTF-8(3字节)与GBK(2字节)环境下直接遍历的问题,提供通过切片按字节读取的方法,并推荐将字符串转换为Unicode格式以实现统一字符遍历的最佳实践。
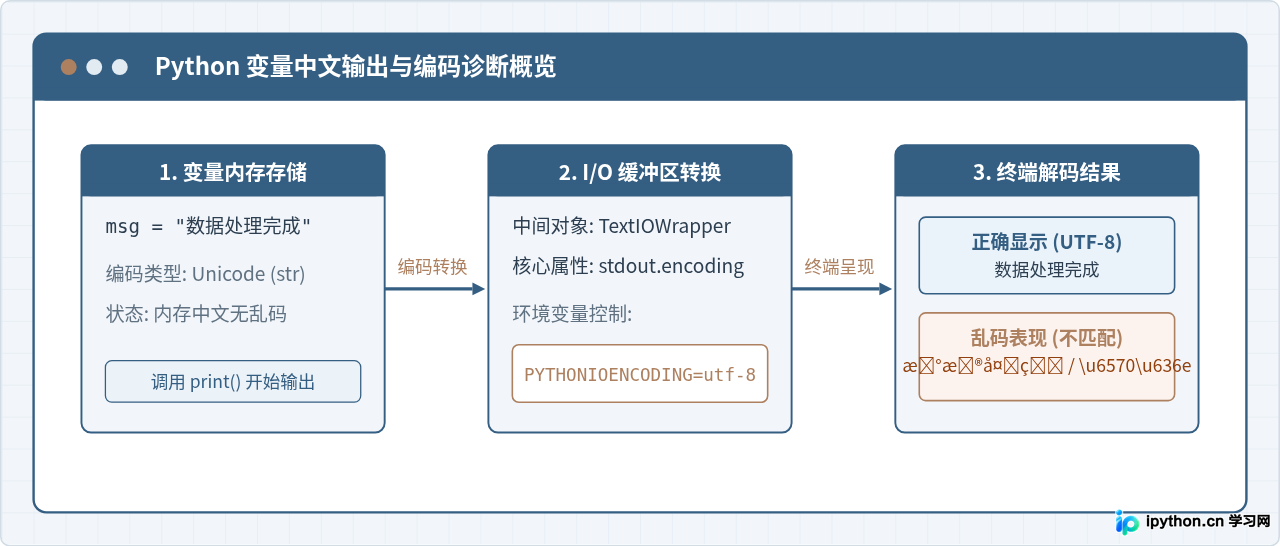
针对Python输出变量出现中文乱码的常见问题,提供从原因分析、排查步骤到具体解决方案的完整实用指南,覆盖终端控制台配置、标准输出流重定向、容器变量格式化及文件读写编码规范。
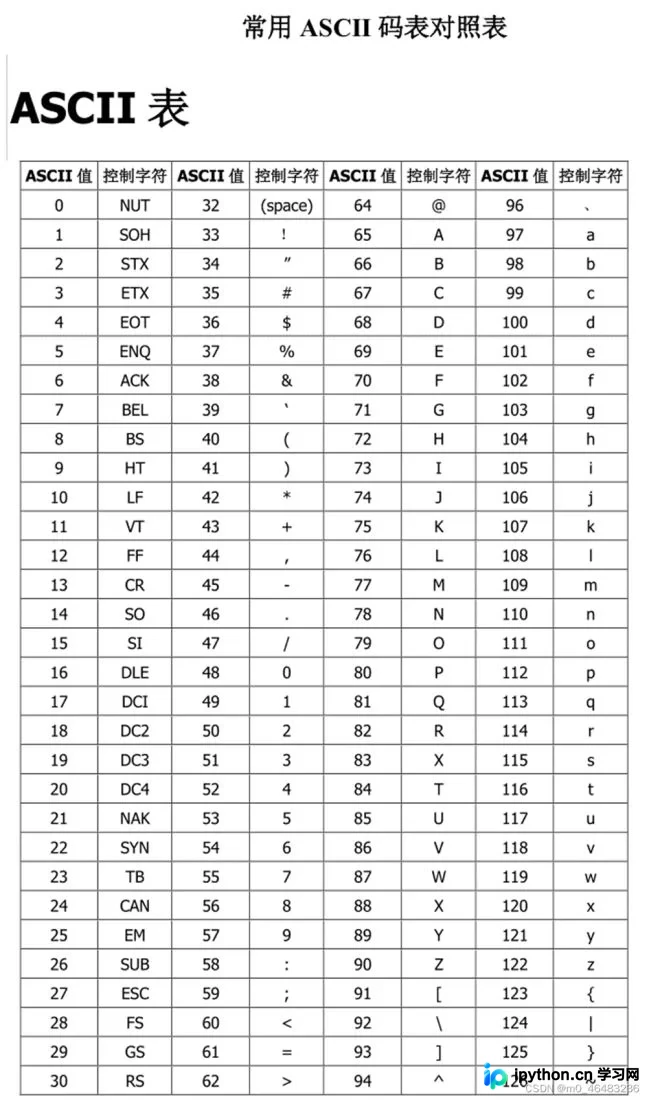
详细解析Python内置函数ord()的核心用法,涵盖字符转ASCII及Unicode数值的转换原理。通过基础对照与实战案例,演示如何结合ord()实现滑动窗口算法,高效解决字母异位词统计问题,助力掌握字符串编码处理与高频次数组构建的实战技巧。
本文详解Python中str与bytes的区别、Unicode编码原理及UTF-8/BOM处理。涵盖字符串创建、编码转换、文件读写中的编码指定及常见字符串方法,帮助开发者正确处理文本数据。
在SQL Server数据库设计中,合理选择字符数据类型对性能和存储至关重要。本文深入解析char、nchar、varchar和nvarchar的核心区别,包括定长与变长特性、Unicode与非Unicode编码差异以及存储空间计算方式,提供基于场景的选型策略与优化建议。
本文深入解析Python中原始字符串(r/R)与Unicode字符串(u/U)操作符的具体用法。通过代码实例演示了原始字符串在避免转义字符干扰及处理文件路径时的优势,以及Unicode操作符对标准字符串和原始Unicode字符串的转换机制。文章提供了相关在线编码转换工具链接,并附带完整可运行代码,帮助开发者掌握字符串处理技巧。
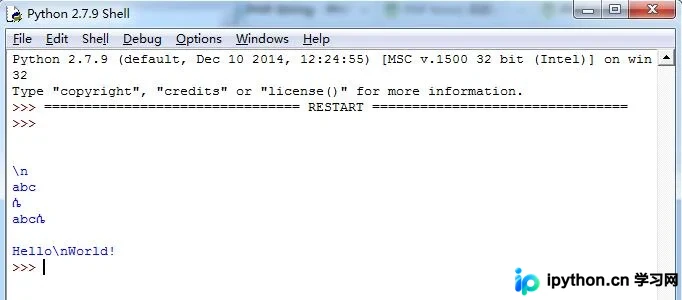
在Python中,print语句前加u表示定义Unicode字符串。该前缀不仅适用于中文,也适用于任何字符串,用于指定Unicode编码。英文字符通常无需此标识,而中文字符若未明确编码易出现乱码。建议统一采用UTF-8编码以确保兼容性。
本文详解使用pandas读取包含中文Unicode编码的CSV文件,重点解析delimiter、header及encoding参数的应用。通过names参数覆盖自动生成的列索引,实现自定义列标题,并提供具体代码示例与输出结果分析。
在Python中,若字符串带有u前缀且包含转义字符(如u'\xe4\xbd\xa0'),直接调用encode('utf8')会导致乱码。本文介绍利用raw_unicode_escape编码将字符串还原为字节序列,再解码为正确Unicode字符的方法,解决此类转码错误。
本文详解Python中chr、unichr和ord三个字符转换函数的用法。chr接收0-255整数返回对应字符,unichr返回Unicode字符,ord则反向获取字符的ASCII或Unicode数值。文章包含具体代码示例及异常处理说明,帮助开发者掌握字符与编码的转换技巧。