

Python内置函数ord()详解:ASCII转换与滑动窗口应用实例

详细解析Python内置函数ord()的核心用法,涵盖字符转ASCII及Unicode数值的转换原理。通过基础对照与实战案例,演示如何结合ord()实现滑动窗口算法,高效解决字母异位词统计问题,助力掌握字符串编码处理与高频次数组构建的实战技巧。
ord() 函数核心原理与基础用法
ord() 是 Python 的内置函数之一,作为 chr() 函数的配对存在。它接收一个长度为 1 的 Unicode 字符串(单字符)作为参数,并返回该字符对应的整数数值(即 ASCII 码值或 Unicode 码点)。理解这一对应关系是处理文本编码与字符计算的基础。
在处理常见字符集时,掌握以下基础范围的数值区间非常实用:
- 数字 0-9 对应数值范围:48-57
- 大写英文字母 A-Z 对应数值范围:65-90
- 小写英文字母 a-z 对应数值范围:97-122
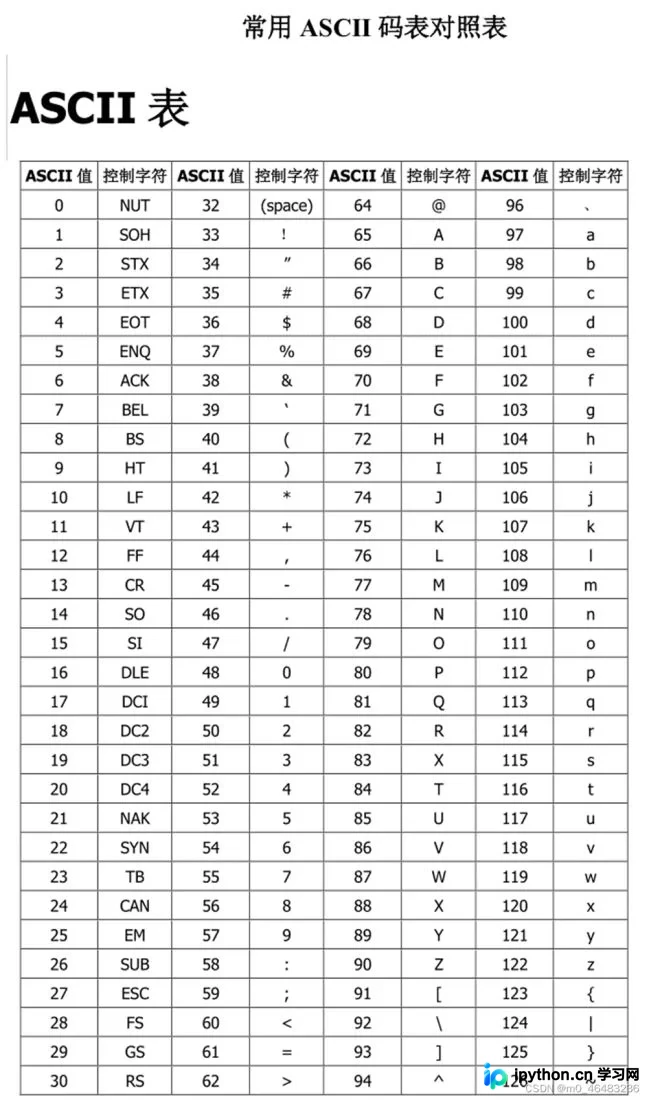
在交互式环境或脚本中直接调用即可快速验证:
>>> ord('0')
48

>>> ord('A')
65

>>> ord('a')
97
实战应用:基于 ord() 的字母异位词查找
在实际算法开发中,ord() 经常被用于将字符转化为连续的数值索引,从而高效构建哈希表或计数数组。下面以经典的“字母异位词(Anagrams)”查找问题为例,展示如何利用 ord() 配合滑动窗口技巧,在长字符串中精准定位符合条件的位置。
其核心思路在于:
- 利用 ord() 获取字符的 ASCII 数值。
- 减去基准字符(如 'a')的 ASCII 值,将 26 个小写英文字母精准映射到下标 0 到 25 的数组中。
- 数组记录每个字母的出现频次,通过比对滑动窗口的频次数组实现高效判断。
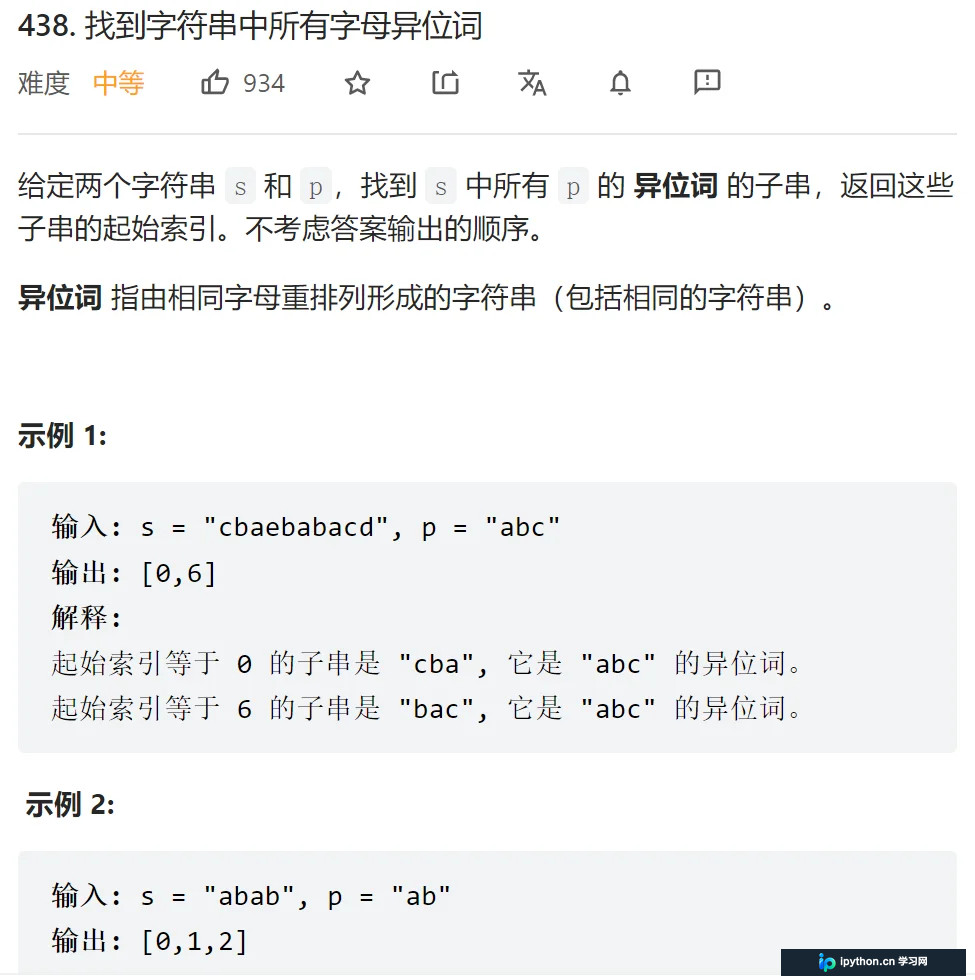
以下是完整的 Python 实现方案,通过动态维护两个长度各为 26 的计数字典(或数组),能够线性时间复杂度完成目标索引的收集:
class Solution(object):
    def findAnagrams(self, s, p):
        """
        :type s: str
        :type p: str
        :rtype: List[int]
        """
        result = []
        record_s = [0]*26
        record_p = [0]*26

        # 预处理:若目标串长于主串,直接返回空
        if len(s) < len(p):
            return result

        # 初始化前缀区域的字符频次统计
        for i in range(len(p)):
            record_s[ord(s[i])-ord('a')] += 1
            record_p[ord(p[i])-ord('a')] += 1

        # 首次检查是否匹配
        if record_s == record_p:
            result.append(0)

        # 启动滑动窗口,每次移动一个位置
        for i in range(len(s)-len(p)):
            # 移除滑出窗口的旧字符计数
            record_s[ord(s[i])-ord('a')] -= 1
            # 加入新进入窗口的字符计数
            record_s[ord(s[i+len(p)])-ord('a')] += 1

            # 比较当前窗口与目标串的字符频次分布
            if record_s == record_p:
                result.append(i+1)

        return result
总结
本文深入剖析了 Python 内置函数 ord() 的底层转换机制及其在字符串处理中的高阶应用。从基础的 ASCII 数值查询到复杂的滑动窗口算法实践,ord() 都能通过精准的数值映射大幅简化字符统计的逻辑复杂度。掌握这一特性,有助于开发者在面对各类文本匹配与哈希计数场景时编写出更高效的代码。
以上就是Python内置函数ord()返回字符串的ASCII数值实例详解的详细内容,更多关于Python内置函数与算法实战的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









