

Python输出变量出现中文乱码怎么解决

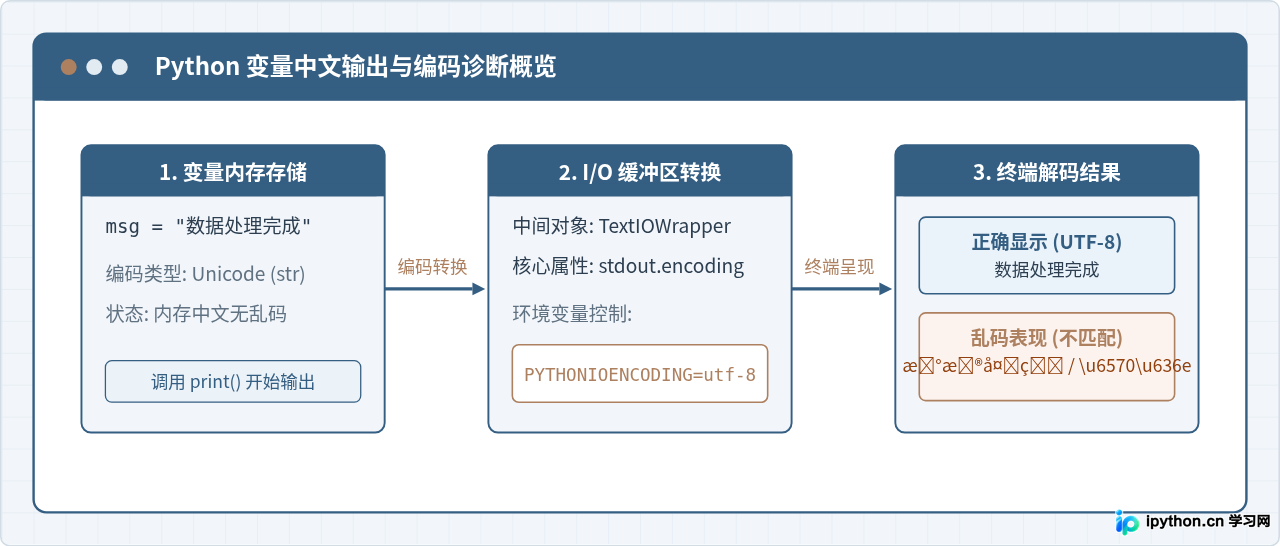
在 Python 中输出变量时遇到中文乱码,核心原因往往是文本字符从内存中的 Unicode 转换为终端或文件可接受的字节流时,所使用的编码格式与接收端的解码格式不一致,或者是在打印列表、字典等容器时误将转义编码(如 \u4e2d\u6587)当成了乱码。解决该问题的核心路径非常明确:首先区分是“字符编码冲突”还是“容器对象的转义显示”,再根据运行环境精确配置 PYTHONIOENCODING 环境变量、重置标准输出流编码,或使用格式化解析函数输出中文内容。
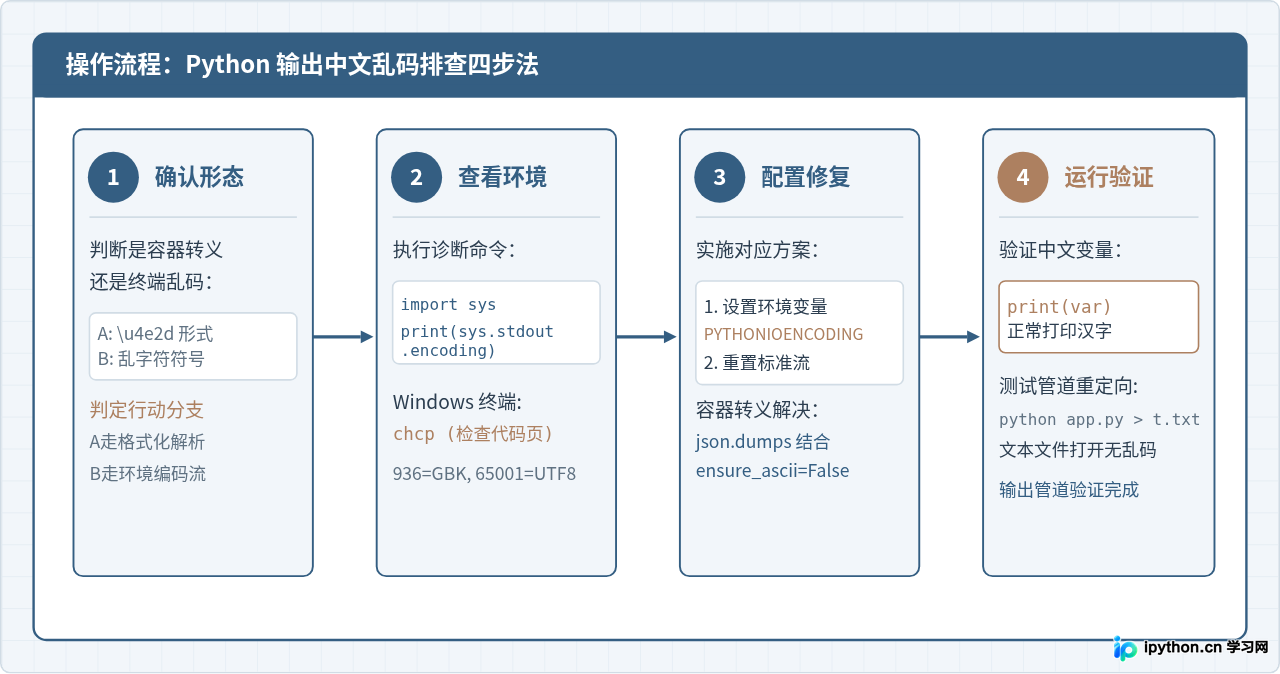
一、乱码现象分类与快速排查四步法
遇到中文乱码时,首先必须区分眼前的字符表现形式。不同表现形式代表完全不同的底层问题,若盲目修改代码往往无法对症下药。通常分为两类表现:
- 表现一:控制台输出类似
['\u4e2d\u6587', '\u6d4b\u8bd5']的 Unicode 转义符号。这并不是真正的编码故障,而是直接打印了包含字符串的容器对象(如列表、字典、元组),Python 默认调用了元素内置的表示方式(repr)。 - 表现二:控制台输出问号
???、黑方块、问号乱码或乱七八糟的拼音与符号(如æ°æ®)。这是典型的标准输入输出流与终端环境(如 Windows 命令提示符 cmd、PowerShell 或嵌入式 IDE 终端)编码不匹配引起的乱码。
二、底层机制:字符编码转换与流传输链路
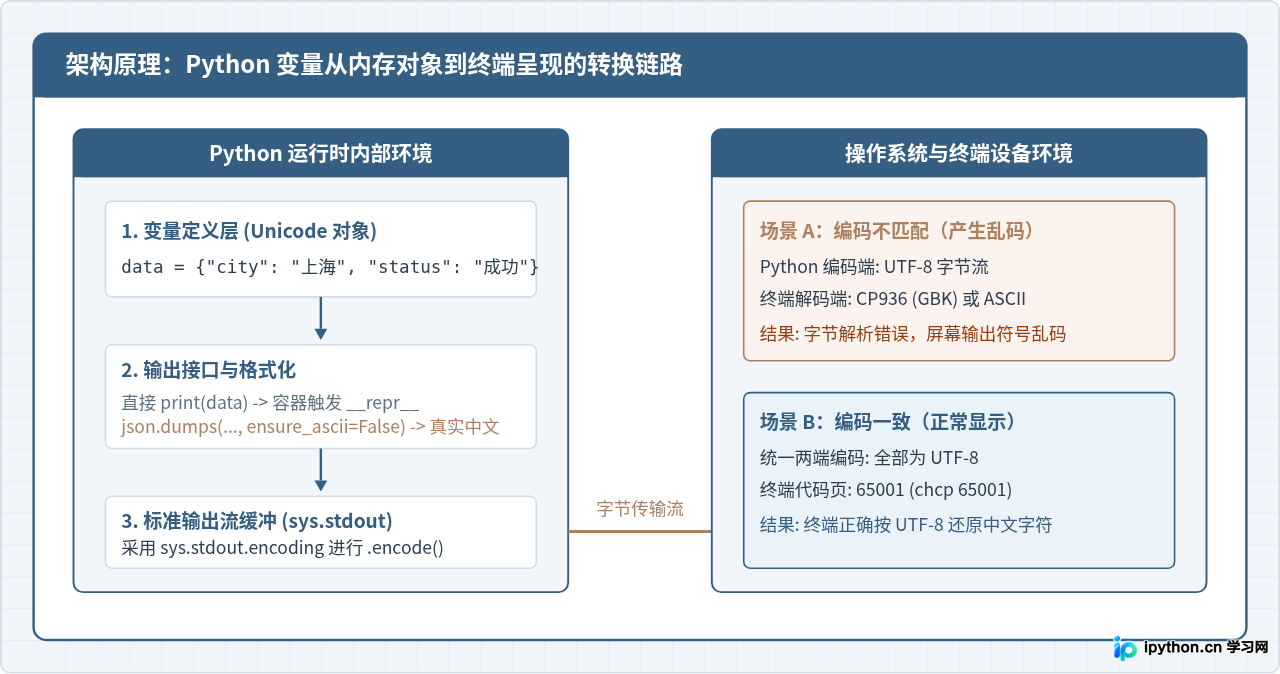
要彻底避免乱码,需要清楚 Python 处理字符串输出时的生命周期。在 Python 3 中,所有字符串变量(str)在解释器内部均以 Unicode 编码存储。当调用 print() 函数时,Python 并不是直接将 Unicode 字符投递给屏幕,而是经过标准输出流 sys.stdout。在这个过程中,标准输出流会通过其关联的 TextIOWrapper 将 Unicode 编码转换为具体的字节序列(Bytes),最后由操作系统的终端软件接收这串字节并渲染显示。
三、核心解决方案与代码实践
1. 解决列表/字典容器打印出现 Unicode 转义符
当变量是一个包含中文的 list、dict 或 set 时,直接使用 print(my_list) 输出的是各个元素的内部表现(repr)。此时中文会被转义为 \u4e2d\u6587 形式。可以使用标准库 json.dumps() 配合 ensure_ascii=False,或者通过循环与格式化输出直接解包打印。
import json

# 示例:包含中文的字典与列表
user_info = {
    "name": "张伟",
    "department": "技术研发部",
    "skills": ["数据分析", "自动化运维"]
}

# 错误用法(输出内部 repr 转义符):
# print(user_info)
# 输出: {'name': '\u5f20\u4f1f', 'department': '\u6280\u672f\u7814\u53d1\u90e8', ...}

# 正确解法一:利用 json 模块直接格式化输出
formatted_output = json.dumps(user_info, ensure_ascii=False, indent=2)
print("格式化输出结果:")
print(formatted_output)

# 正确解法二:循环解包输出字符串
print("skills 列表项:")
for item in user_info["skills"]:
    print(f"- {item}")
2. 设置环境变量 PYTHONIOENCODING
如果是在控制台运行脚本时整个终端都出现符号乱码,最根本的做法是在启动 Python 前告诉解释器:所有标准输入输出均强制使用 UTF-8 编码。这种方式无需修改任何业务代码,跨项目适配性强。
- Windows 命令提示符 (CMD):运行
set PYTHONIOENCODING=utf-8,然后再运行脚本。 - Windows PowerShell:运行
$env:PYTHONIOENCODING="utf-8",然后再执行脚本。 - Linux / macOS 终端:运行
export PYTHONIOENCODING=utf-8。
3. 在代码中显式重构标准输出流编码
在 Python 3.7 及以上版本中,sys.stdout 提供了官方推荐的 reconfigure() 方法。可以在脚本最开头部份直接调用该方法,将输出流编码锁定为 UTF-8:
import sys

# 仅在 Python 3.7+ 中可用,显式指定标准输出与标准错误编码
if hasattr(sys.stdout, 'reconfigure'):
    sys.stdout.reconfigure(encoding='utf-8')
if hasattr(sys.stderr, 'reconfigure'):
    sys.stderr.reconfigure(encoding='utf-8')

chinese_text = "中文变量输出测试:数据传输正常"
print(chinese_text)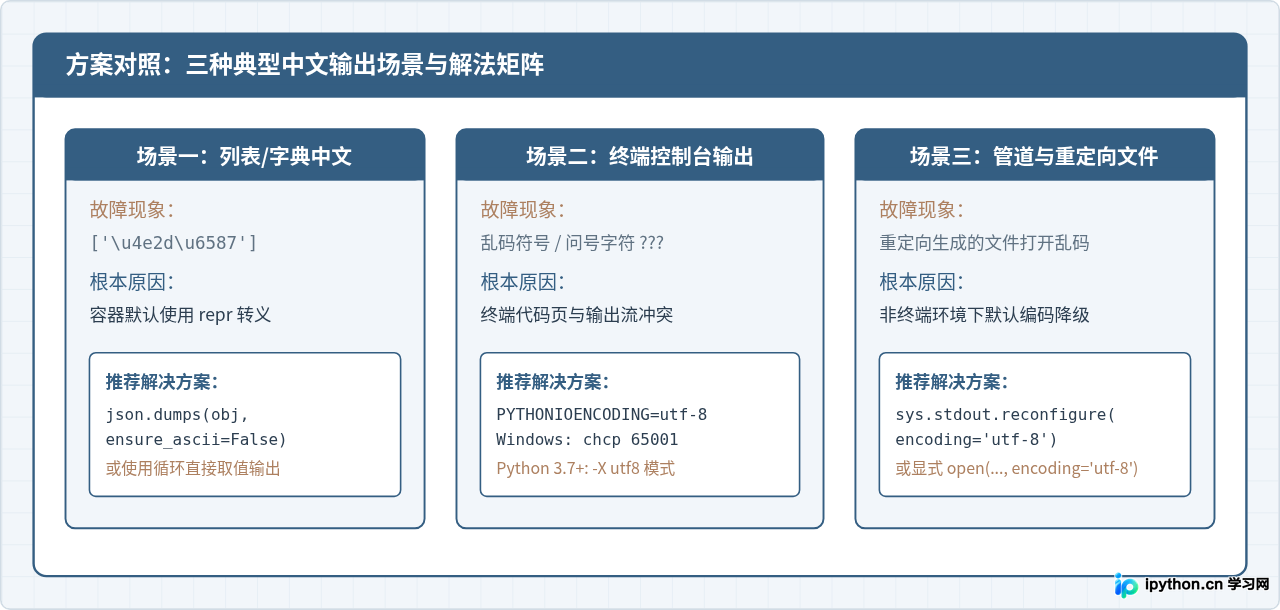
4. Windows 控制台代码页切换
在 Windows 的 CMD 或 PowerShell 中,默认的代码页通常是 936(对应简体中文 GBK/GB2312)。当终端以此代码页解码 Python 发出的 UTF-8 字符序列时,就会产生乱码。解决办法是在运行 Python 前将代码页切换为 UTF-8:
# 查看当前控制台代码页(显示 936 表示为 GBK)
chcp

# 将控制台切换为 UTF-8 代码页
chcp 65001

# 随后执行 Python 脚本
python test_script.py注意:执行 chcp 65001 后,控制台窗口的显示字体也必须支持中文(例如“新宋体”、“Consolas”或“微软雅黑”)。如果终端字体被设置为仅支持 ASCII 的点阵字体,即使编码正确,屏幕上依然会因为缺少字形渲染而出现空白或方块。
四、验证方法与注意事项总结
完成上述配置后,需要通过简短脚本验证运行环境是否已经彻底就绪。可以通过以下验证脚本快速测试:
import sys

print(f"[环境检查] Python 版本: {sys.version.split()[0]}")
print(f"[环境检查] 标准输出编码 sys.stdout.encoding: {sys.stdout.encoding}")
print(f"[环境检查] 默认系统编码 sys.getdefaultencoding(): {sys.getdefaultencoding()}")

# 测试各类中文变量输出
raw_str = "中文测试字符串:你好,世界!"
data_dict = {"提示信息": "操作成功", "错误代码": 0}

print("\n--- 字符串输出测试 ---")
print(raw_str)

print("\n--- 容器格式化输出测试 ---")
import json
print(json.dumps(data_dict, ensure_ascii=False))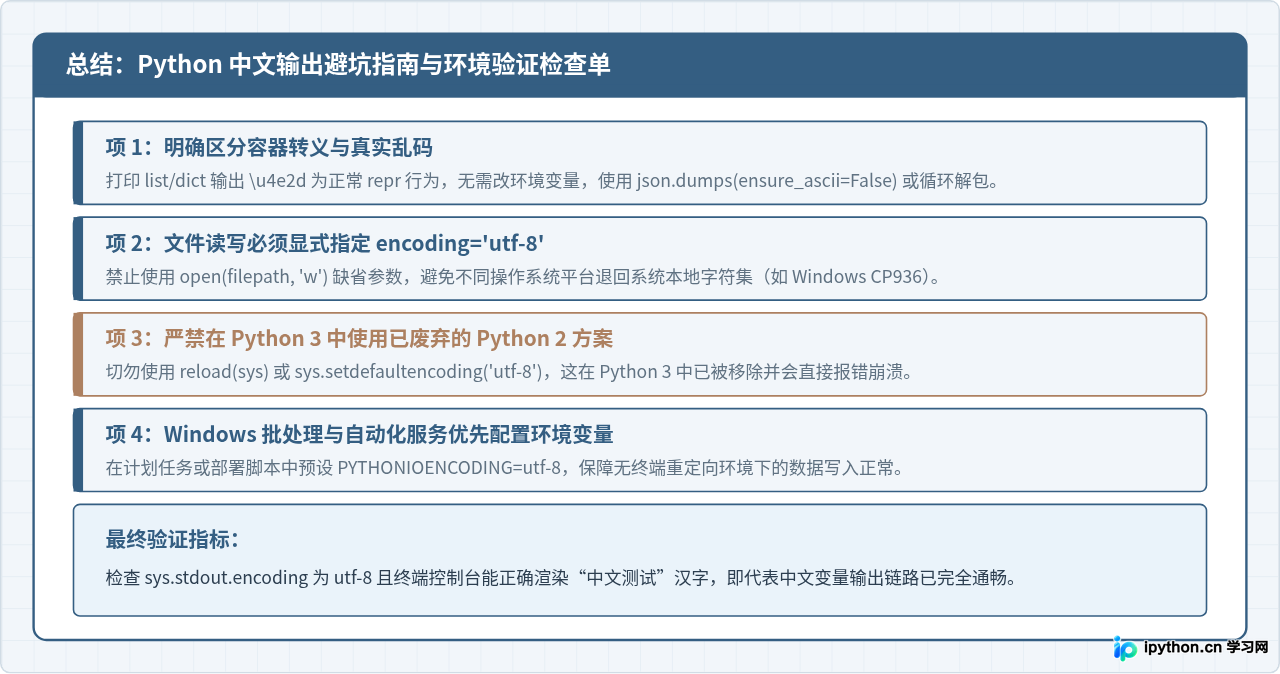
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









