

TensorFlow处理不定长序列与双向LSTM实战避坑指南

本文详细记录TensorFlow中处理不定长文本序列的读取与解析方法,包括CSV数据拼接策略。深入探讨RNN、双向LSTM在序列预测与标签预测中的输入输出格式差异,解析多任务输出划分、Zero Padding处理及get_shape与tf.shape的区别。重点解决双向LSTM的信息瓶颈问题,提供拼接、平均和池化三种输出处理方案,帮助开发者规避常见踩坑点。
1、tensorflow(不定长)文本序列读取与解析
在使用tensorflow读取csv文件时,必须明确指定每一列的数据类型。
然而,对于RNN这类接受序列输入的模型而言,单条序列的长度往往是不固定的。若使用csv存储此类序列数据,应首先将特征序列拼接至同一列中。
例如,假设有两条数据序列,其中第一项为标签,后续项为特征序列。
将 [0, 1.1, 1.2, 2.3] 转换为 [0, '1.1_1.2_2.3']。
将 [1, 1.0, 2.5, 1.6, 3.2, 4.5] 转换为 [1, '1.0_2.5_1.6_3.2_4.5']。
经过上述处理,每条数据仅包含固定数量的两列。
读取时指定第二列为字符串类型,随后按'_'分割字符串并转换为数值。
关键代码示例如下:
def readMyFileFormat(fileNameQueue):
    reader = tf.TextLineReader()
    key, value = reader.read(fileNameQueue)

    record_defaults = [["Null"], [-1], ["Null"], ["Null"], [-1]]
    phone1, seqlen, ts_diff_strseq, t_cod_strseq, userlabel = tf.decode_csv(value, record_defaults=record_defaults)
    ts_diff_str = tf.string_split([ts_diff_strseq], delimiter='_')
    t_cod_str = tf.string_split([t_cod_strseq], delimiter='_')
    # 每个字符串转数字
    Str2Float = lambda string: tf.string_to_number(string, tf.float32)
    Str2Int = lambda string: tf.string_to_number(string, tf.int32)
    ts_diff_seq = tf.map_fn(Str2Float, ts_diff_str.values, dtype = tf.float32) # 一定要加上dtype,且必须与fn的输出类型一致
    t_cod_seq = tf.map_fn(Str2Int, t_cod_str.values, dtype = tf.int32)
2、时序建模的序列预测、序列拟合、标签预测,及输入数据格式
在序列预测与拟合任务中,“标签”即为序列本身,区别在于关注未来时刻或当前时刻。当前时刻的拟合任务类似于自编码器(autoencoder)的重构过程。
标签预测常见于语言学建模,包括单词级标签的分词与整句标签的情感分析。前者需对每个单词输入输出其分词标识,后者则取最后若干输出级联前馈神经网络进行分类。
在keras中构建输入-输出对时,需将序列拆分为多个片段。
序列形式:
按时间列表处理:static_bidirectional_rnn。
使用多维数组:bidirectional_dynamic_rnn与stack_bidirectional_dynamic_rnn,这是变长双向RNN的正确使用方式。
3、多任务设置及相应的输出向量划分
对于标签预测任务,可根据需求提取相应输出。
对于序列预测与拟合:
双向LSTM通常用于拟合。但若需捕捉动态信息,即便需要完整序列输入,仍可结合正向预测与反向预测。
单向LSTM适用于拟合与预测场景。
4、zero padding
处理后通常需通过tf.boolean_mask()隔离零填充的影响,该函数输入包括数据矩阵和指示补零位置的矩阵。
5、get_shape()方法
需注意与tf.shape()的类型区别,前者返回list,后者返回tensor。
6、双向LSTM的信息瓶颈的解决
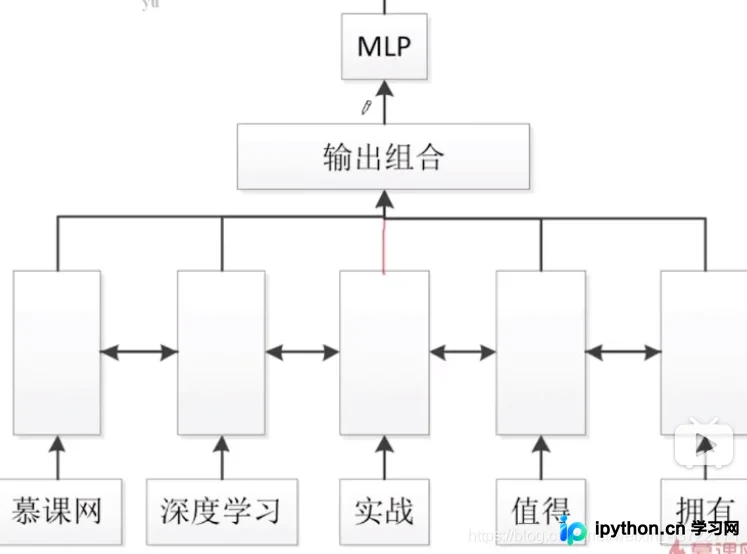
若在时间步的最后输出,可能导致早期字符被遗忘门遗忘。
因此,需对每个时间步的输出进行处理。
主要处理方式包括:
1、拼接:将所有输出拼接在一起。
2、Average(平均)。
3、Pooling(池化)。
以上为个人经验总结,希望能提供参考,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









