Python中利用string.Template类安全替换字符串子串
本文介绍如何在Python中使用string.Template类进行字符串子串替换。通过示例演示了使用美元符号($)定义占位符,以及如何通过字典或关键字参数向substitute方法传递值。文章还涵盖了转义美元符号、变量命名规则以及locals()函数的配合使用,帮助开发者实现安全且灵活的字符串格式化。
2026-10-11
7

本文介绍如何在Python中使用string.Template类进行字符串子串替换。通过示例演示了使用美元符号($)定义占位符,以及如何通过字典或关键字参数向substitute方法传递值。文章还涵盖了转义美元符号、变量命名规则以及locals()函数的配合使用,帮助开发者实现安全且灵活的字符串格式化。
在Python中,若字符串带有u前缀且包含转义字符(如u'\xe4\xbd\xa0'),直接调用encode('utf8')会导致乱码。本文介绍利用raw_unicode_escape编码将字符串还原为字节序列,再解码为正确Unicode字符的方法,解决此类转码错误。
本文介绍如何使用Python正则表达式从Apache日志文件中提取特定字段,并通过重定向sys.stdout将结果写入指定文件。通过示例代码展示了如何解析IP、时间、URL及状态码,并处理文件读写与输出恢复的逻辑。
本文深入解析 Python 中 join() 方法的核心机制,涵盖字符串、列表及字典的拼接规则,并重点演示如何利用 os.path.join 安全构建文件绝对路径。通过具体代码示例,展示如何获取目录下最新文件的完整路径,帮助开发者掌握高效的字符串与路径处理技巧。
计算机在存储和传输文本时依赖特定规则进行字节映射。本文详解Python中字符编码、Base64、URL及Hex等数据转换方法,结合encode与decode函数演示实际用法,并提供文件读写配置与异常处理策略,帮助开发者高效解决乱码问题并保障跨平台数据兼容性。
本文介绍在 Python 中将字符串转换为整型和浮点型的两种主要方式。针对 Python 2.6 之前的版本,推荐使用 string 模块中的 atoi 和 atof 函数;而在 Python 2.6 及更高版本中,则直接使用内置的 int() 和 float() 函数。文章提供了具体的代码示例,展示了如何处理包含小数点的字符串转换及结果差异。
本文系统梳理 Python 中字符串拼接的七种主要方式,包括加号连接、逗号分隔、隐式连接、% 格式化、format 方法、join 函数以及 f-string。重点解析各方法的适用场景、语法差异及性能表现,推荐在 Python 3.6+ 环境中优先使用 f-string 以获得最佳可读性与执行效率。
本文介绍在Python中过滤纯数字字符串的多种方法。通过对比正则表达式、try-except异常捕获以及字符串内置方法(如strip和isdigit),分析各自的适用场景与优缺点,帮助开发者选择最简洁高效的实现方案。
本文总结了Python中实现字符串连接的8种方法,包括加号连接、逗号生成元组、格式化字符串(%和format)、隐式拼接、反斜杠续行、乘法重复、join方法以及列表推导式。文章通过具体代码示例展示了各方法的语法、适用场景及潜在错误,帮助开发者根据实际需求选择最优方案。
本文介绍了在Python中不使用内置int()函数将字符串转换为数字的三种方法。通过遍历字符串,利用str函数匹配字符、ord()函数计算ASCII码差值,以及构造表达式调用eval()函数,分别实现了字符串到整数的转换。
本文介绍一种利用Python提取字符串中最高频重复子串的方法。核心思路是通过滑动窗口机制,从不同长度(2至字符串长度-1)对字符串进行切片,统计各子串出现次数。最终通过排序获取重复模式数量最高的前10个结果,适用于文本模式分析与数据清洗场景。
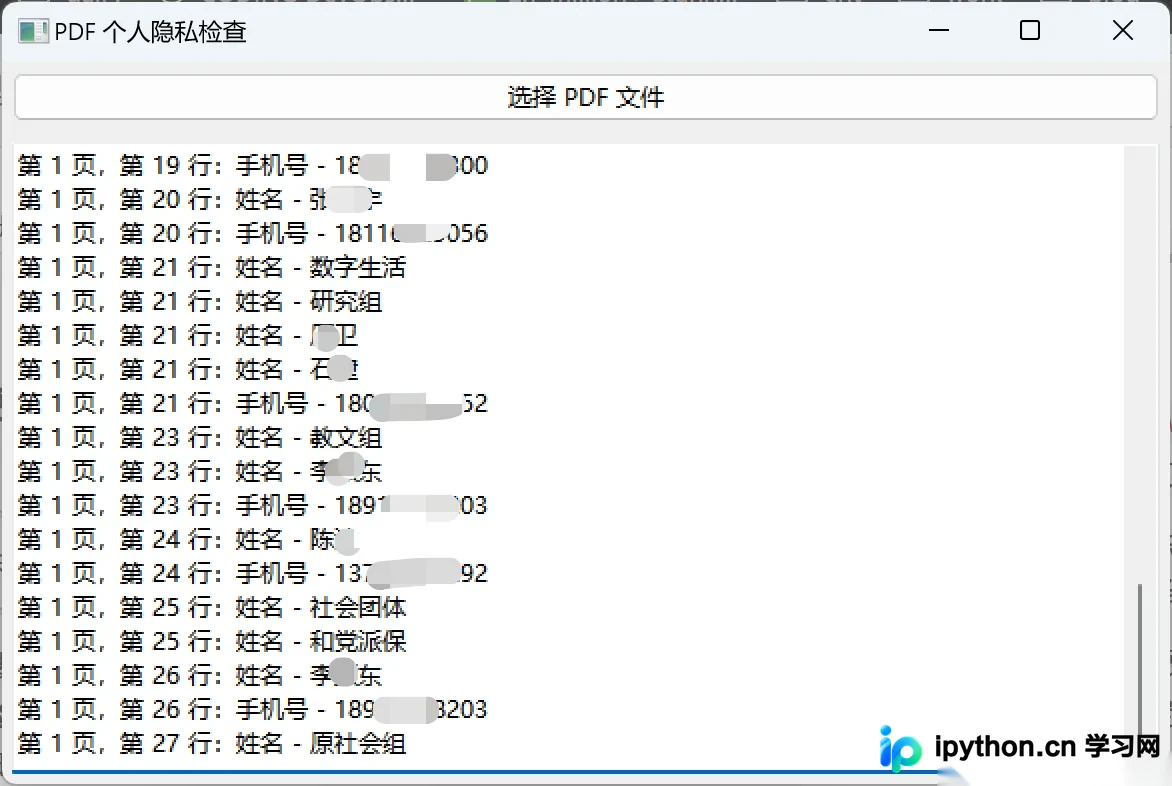
本文介绍使用Python结合pdfplumber库提取PDF文本,并配合正则表达式快速定位姓名、身份证号、手机号等敏感数据的方法。通过wxPython搭建桌面界面,输入文件后自动输出结果页码与行号,支持按需扩展检测规则,适用于日常文档脱敏审查。