

Python字符串操作:strip()与split()方法详解与结合使用
在 Python 文本数据处理中,清理首尾无效符号与按规则切分段落是最基础的操作。本文详细解析 strip() 移除两端字符的机制,以及 split() 结合 maxsplit 控制切割频率的方法,并提供两者配合清洗多行数据的标准化流程,助力高效完成字符串格式化任务。
2026-10-11
6

在 Python 文本数据处理中,清理首尾无效符号与按规则切分段落是最基础的操作。本文详细解析 strip() 移除两端字符的机制,以及 split() 结合 maxsplit 控制切割频率的方法,并提供两者配合清洗多行数据的标准化流程,助力高效完成字符串格式化任务。
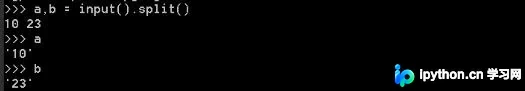
在 Python 中,使用 input() 函数接收用户输入时,默认返回的是字符串类型。若需在一行内输入多个值并转换为整数,可结合 split() 和 map() 函数实现。例如,a,b = map(int, input().split()) 可将输入的多个字符串值转换为整数并赋值给变量。
处理文本数据时,统一或调整字母大小写是高频需求。Python提供islower/upper等判断方法及lower/casefold/title等转换函数。本文详解各方法的适用场景、参数差异与边界条件,助您精准控制字符串格式。
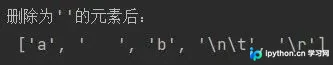
针对 Python 列表中存在空字符、纯空格、换行或制表符等无效元素的情况,本文介绍两种清理方法。通过 remove() 循环遍历可精确匹配特定字符,而推荐使用的列表推导式结合 strip() 函数能一次性过滤所有空白字符,兼顾执行效率与代码简洁性。
本文详细对比了Python中七种主流字符串拼接方案。通过分析+运算符、join()、f-string、%格式化、format()、StringIO及append()组合在内存分配、执行速度与代码可读性上的差异,帮助开发者根据实际数据规模选择最优的文本处理策略。
本文详细介绍如何利用Python内置re模块编写正则表达式,实现对IPv4和IPv6地址的精确匹配、字符串验证及日志提取。涵盖数字段拆分逻辑、边界符使用及常见陷阱,并提供实际项目中的优化方案。
本文介绍如何使用Python的random模块生成随机姓名。通过定义姓氏、名字和中间名的列表,利用random.choice()函数从列表中随机选取字符进行组合,实现简单的姓名生成逻辑。
本文深入解析Python核心数据类型,涵盖数字、字符串、元组、列表和字典的特性与操作。重点讲解不可变与可变类型的区别,演示变量赋值与交换技巧,并提供字符串切片、列表操作及字典查询的实用代码示例。同时详细介绍int()、str()、list()等常见类型转换方法,帮助读者掌握Python基础编程技能。
本文详解 Python 3 处理 Unicode 字符串的核心机制与实操方法。内容涵盖原生字符串创建、索引切片与内置函数调用,深入讲解 str 与 bytes 类型的 UTF-8 编解码规范,并提供安全转换 \uXXXX 转义序列的标准代码。结合常见乱码排错步骤,助您高效完成多语言文本清洗与自然语言处理数据预处理任务。
本文详细说明在 Python 中检测字符串是否包含特殊字符的两种常用实现方式,并演示如何将这些字符自动替换为空值。通过对比正则表达式匹配与字符集合遍历,提供可直接运行的清洗代码,适用于 URL 净化、文件名校验及数据预处理场景。
Python 字符串提供丰富的处理功能,涵盖创建切片、拆分定位、替换脱敏及清洗格式化等核心操作。本文详解 7 种字符串拼接方法(含 + 号、join、format、f-string 等),对比性能差异与适用场景,附带完整数据清洗流程示例,帮助开发者根据实际业务需求选择最优方案并提升代码执行效率。
本文介绍在Python中将文件内容转换为列表时,如何有效处理并忽略文件中的空行。通过示例代码展示读取文件、遍历行、判断是否为空行以及将非空行数据转换为列表并追加到结果列表中的具体操作步骤。