Python 使用 Selenium 和 Requests 爬取西瓜视频完整教程
本文详细介绍如何利用 Python 的 Selenium 和 Requests 库爬取西瓜视频。通过构建 embedUrl 获取 group_id,使用无头浏览器模拟访问提取视频真实地址,最后拼接 http 协议并下载二进制数据保存为 mp4 文件。
2026-10-15
6

本文详细介绍如何利用 Python 的 Selenium 和 Requests 库爬取西瓜视频。通过构建 embedUrl 获取 group_id,使用无头浏览器模拟访问提取视频真实地址,最后拼接 http 协议并下载二进制数据保存为 mp4 文件。
本文详细介绍如何利用Python的Selenium库实现定时打卡功能。内容涵盖项目目录结构搭建、ChromeDriver版本匹配与获取方法,以及ask_for_leave.py核心代码的配置说明。通过解析关键代码片段,指导用户完成从环境配置到脚本运行的完整流程,实现网页自动登录与打卡操作。
本文详细介绍如何使用Python的Selenium库模拟淘宝网站的登录、搜索及选购流程。通过XPath定位元素,演示了从登录账号、搜索关键词、筛选商品属性到加入购物车并结算的完整操作步骤,包含关键代码片段与截图说明。
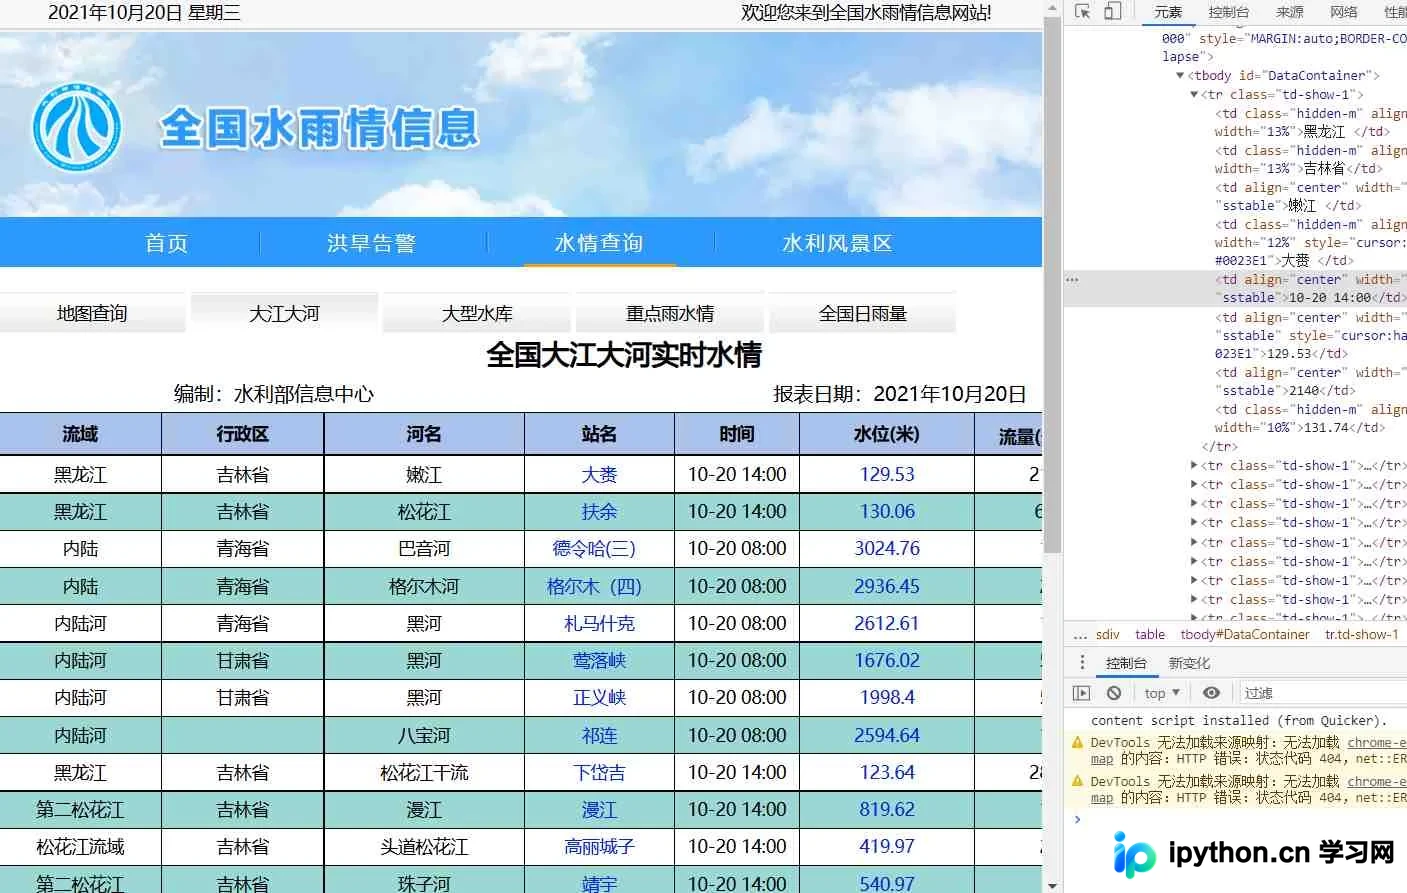
本文详细解析如何使用Python结合Selenium库爬取全国水雨情信息。针对无直接接口的情况,通过模拟浏览器行为获取页面数据,并利用pandas进行清洗与存储。文章涵盖代码实现、结果展示及常见问题分析,包括时间处理、代码优化建议,为相关数据采集提供完整参考。
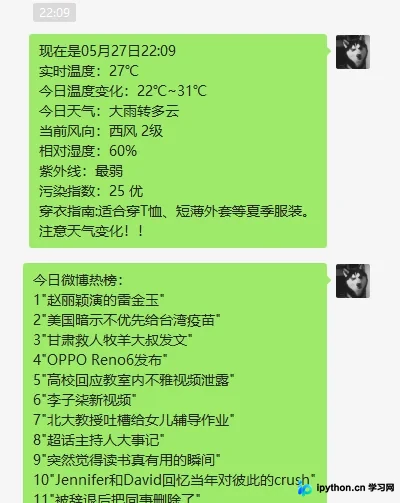
本文介绍如何使用Python结合Selenium和Requests库,动态渲染并爬取中国天气网实时数据及微博热搜榜。通过win32gui模拟键鼠操作,实现指定时间自动向微信好友发送天气详情与热榜信息,并支持打包为exe文件运行。
本文介绍四个Python自动化实用案例:利用PyAutoGUI模拟鼠标移动保持在线状态,使用Selenium实现网站自动登录,通过zipfile模块自动打包备份文件,以及结合PRAW库将YouTube视频自动发布至Reddit。涵盖环境配置、核心代码逻辑及关键参数说明,帮助开发者简化重复性工作流程。
新版Selenium已不再支持PhantomJS,本文详细介绍如何在Python爬虫项目中安装并配置ChromeDriver以支持动态网页抓取。内容涵盖安装必要性、官方资源链接,以及针对Mac系统的Homebrew安装方法(含备用方案)和Windows环境下的版本验证步骤,帮助开发者顺利实现Headless Chrome自动化测试与数据采集。
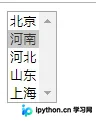
本文详细介绍Python Selenium中处理网页下拉框的方法。通过Select类提供的select_by_value、select_by_index等函数,结合鼠标悬停、点击及警告框处理,实现自动化操作。文章包含完整代码示例与HTML结构解析,帮助开发者灵活定位并操作下拉选项。
针对办公环境网络隔离导致VBA开发不便的问题,本文介绍如何利用Python结合Selenium与Requests库,从微软官方文档网站抓取VBA API数据。通过遍历导航树获取链接,下载主体页面内容,并基于jstree构建本地离线查询工具,实现无网环境下的VBA参考查阅。
本文介绍如何使用 Python 的 Selenium 库结合 Chrome 驱动,实现 CSDN 网站的自动登录流程。内容涵盖定位账号密码输入框、点击登录按钮触发验证,以及通过 ActionChains 模拟鼠标拖拽动作处理滑动验证码。文中提供了完整的代码示例及针对初学者的滑动验证策略建议,帮助读者掌握自动化测试中的常见验证绕过技巧。
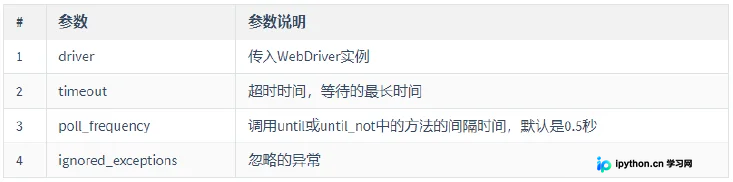
本文详解Selenium自动化测试中的三种核心等待方式:固定时间sleep、隐式等待implicitly_wait及显式等待WebDriverWait。通过对比分析各方法的优缺点、适用场景及代码示例,帮助开发者解决元素定位失败问题,提升脚本稳定性与执行效率。
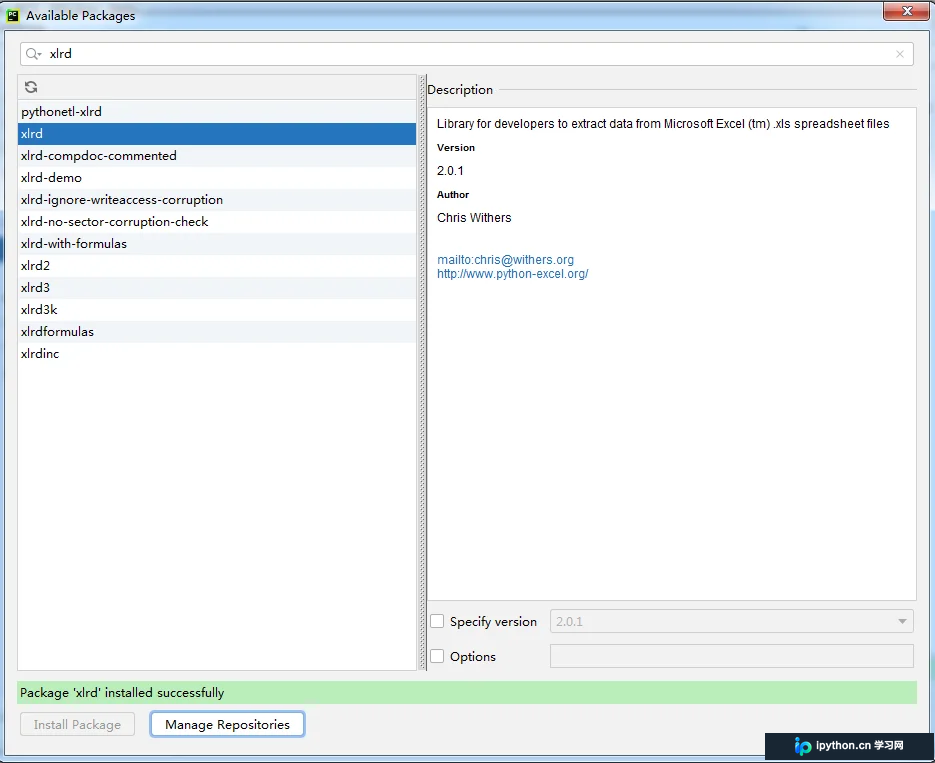
本文介绍在Selenium数据驱动测试中使用xlrd库读取Excel文件的常见报错及解决方案。针对xlrd 2.0.1版本仅支持.xls格式的问题,提供了使用旧版库或转换文件格式两种解决方法,并附带完整的Python测试脚本示例。