

Python模拟网站登录的多种实现方式详解
本文详细介绍Python实现网站模拟登录的几种主流方法。包括通过浏览器手动获取Cookie进行模拟请求、分析Form Data与Request Payload两种数据提交格式的差异,以及利用requests.Session保持会话状态。此外,还讲解了使用Selenium库调用真实浏览器(Chrome/Firefox)进行自动化登录的操作步骤与注意事项。
2026-10-14
6

本文详细介绍Python实现网站模拟登录的几种主流方法。包括通过浏览器手动获取Cookie进行模拟请求、分析Form Data与Request Payload两种数据提交格式的差异,以及利用requests.Session保持会话状态。此外,还讲解了使用Selenium库调用真实浏览器(Chrome/Firefox)进行自动化登录的操作步骤与注意事项。
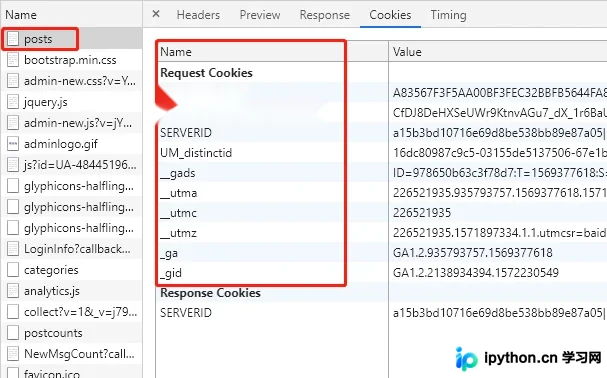
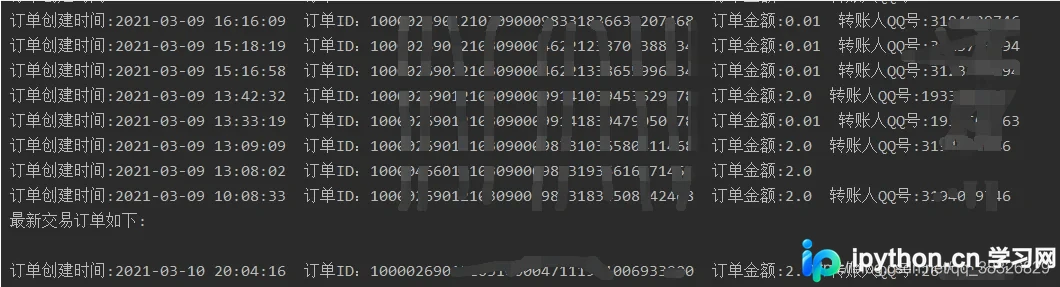
本文介绍如何使用Python结合Selenium库实现QQ钱包的实时到账免签支付功能。通过自动化登录腾讯交易页面,抓取JSON格式的订单数据,自动判断支付状态并生成对应金额的卡密。文章提供了完整的代码逻辑、环境配置要求及注意事项,适用于开发者搭建简单的支付验证系统。
本文分享一款基于Python Selenium框架与PyQt5图形界面的自动化抢购工具完整源码。该工具支持自定义抢购时间、网址及多种抢购方案,通过GUI界面简化操作,适用于京东、天猫等电商平台。文章强调该代码仅用于学习Selenium框架及GUI开发,非外挂软件,并提供了源码获取方式及免责声明。
本文详细介绍如何使用Python Selenium库对Cookie进行获取、添加和删除操作。通过具体代码示例展示API用法,并深入解析Cookie的Domain、Path、Expire/Max-age、Secure及HttpOnly等关键属性,帮助开发者掌握浏览器状态管理的核心技巧。
本文详解Python Selenium中的异常处理机制,涵盖超时和节点未找到等常见错误的捕获方法。通过try-except-finally结构确保浏览器资源释放,并深入解析sys.exit()在脚本退出时的行为逻辑,帮助开发者构建更健壮的自动化测试脚本。
本文介绍如何利用Python3的Selenium库定位网页元素,结合Tesserocr或Pytesseract进行图像识别,实现图片验证码的自动获取、预处理及识别,从而完成网页自动登录功能。文中提供了两种获取验证码截图的方法,并详细讲解了通过灰度化和二值化处理去除干扰线的技巧,以提升识别准确率。
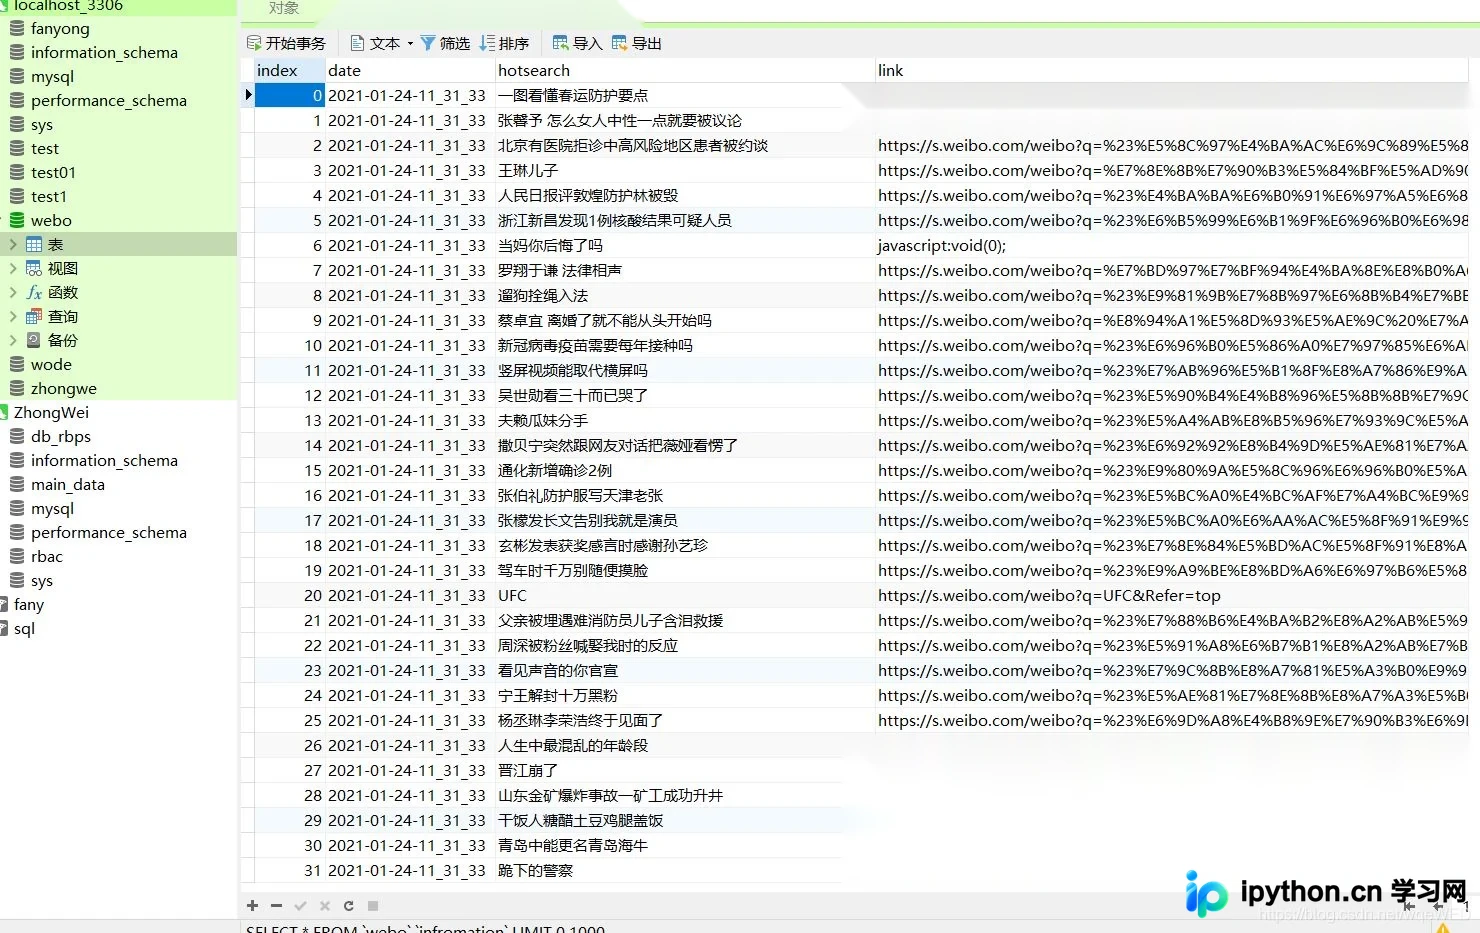
本文详细介绍如何利用Python结合Selenium库自动化抓取微博热搜数据,并通过Pandas处理数据后存入MySQL数据库。文章涵盖环境配置、网页元素定位、数据清洗合并及数据库连接写入等关键步骤,提供完整代码示例,帮助开发者快速实现热搜数据的自动化采集与持久化存储。
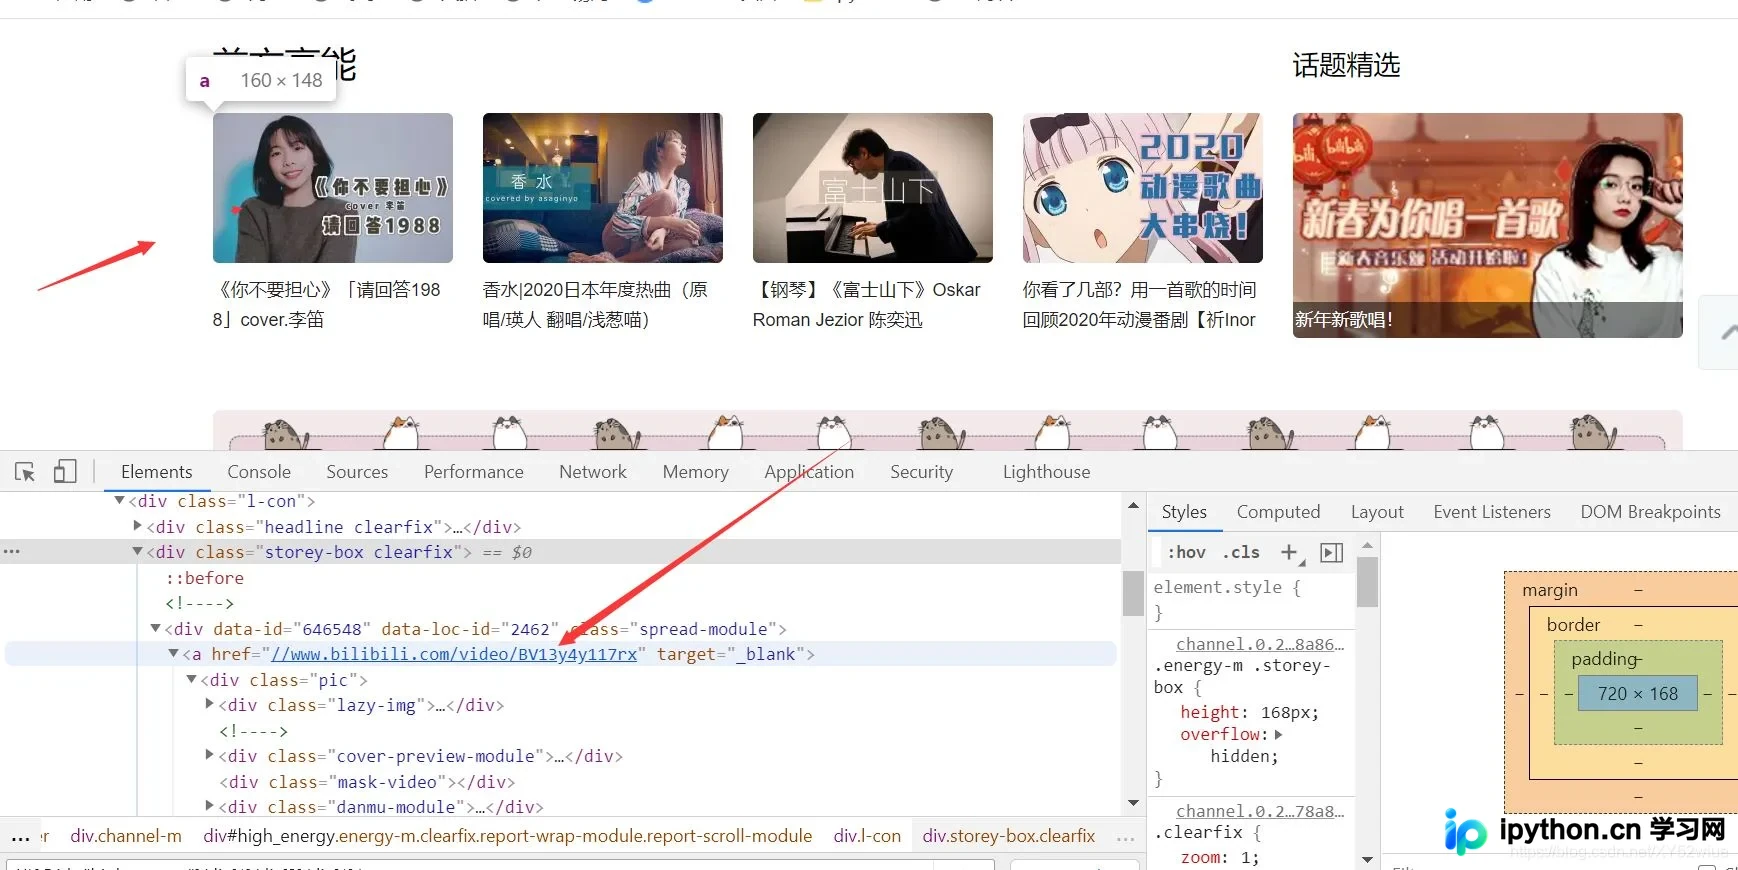
本文通过B站爬虫案例,指出Selenium中使用XPath直接获取属性(如./a/@href)会报错,正确做法是先定位元素节点再调用get_attribute()方法。文章提供了完整的Python代码示例,展示了如何在无头浏览器环境下解析网页数据并提取链接与标题。
本文详解如何利用Selenium获取CSDN网站的Cookies并保存至本地文件,随后在后续脚本中读取该Cookies实现免密自动登录。通过Python代码演示了从手动登录获取Cookie到程序化复用Cookie刷新页面的完整流程,适用于博客评论、点赞等自动化操作场景。
本文介绍如何使用Python和Selenium实现携带Cookies模拟登录微博。首先通过手机扫码获取斗鱼Cookies并保存,随后加载该Cookies文件登录微博,实现高效模拟登录。
本文解决Selenium自动化测试中定位span元素失败的问题。当直接通过绝对路径或ID无法定位时,通常是因为目标元素位于嵌套模块或内联函数中。正确做法是先定位父级容器,再在其内部查找目标span,避免报错。

本文针对Windows环境下使用Selenium配合Headless Chrome进行自动化操作时,因ChromeDriver路径指定不当导致的报错问题提供解决方案。新版Chrome(59+)已内置Headless模式,无需再依赖已停止维护的PhantomJS。文章详细说明了在Windows系统中正确指定chromedriver可执行文件路径的方法,并强调了导入Options模块的重要性,确保自动化脚本在Windows平台下顺畅运行。
