

Python爬虫实战:利用OpenCV破解滑动验证码
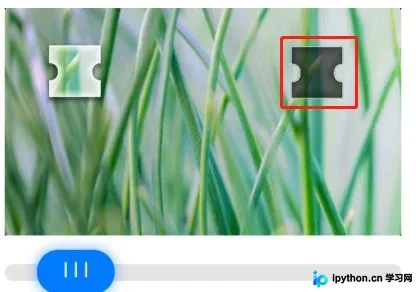
本文详解如何使用Python结合OpenCV与Selenium破解常见的滑动图片验证码。通过高斯模糊去噪、Canny边缘检测及轮廓筛选,精准定位缺口坐标,最终实现自动化拖动验证,有效应对初级反爬机制。
2026-10-14
6

本文详解如何使用Python结合OpenCV与Selenium破解常见的滑动图片验证码。通过高斯模糊去噪、Canny边缘检测及轮廓筛选,精准定位缺口坐标,最终实现自动化拖动验证,有效应对初级反爬机制。
本文介绍Python自动化测试中处理验证码的三种常见方式,重点详解调用百度云API进行图像识别的方法。内容涵盖AK/SK密钥获取、Selenium截图截取验证码区域、调用百度接口获取Token及识别结果,并提供完整代码示例。
本文详细整理了Selenium中ChromeDriver的add_argument常用启动参数。涵盖性能优化(如禁用GPU、图片、插件)、安全与隐私设置(如禁用沙箱、远程字体)、功能控制(如隐身模式、代理服务器)及进程管理选项。通过合理配置这些参数,可提升自动化脚本稳定性并满足特定测试需求。
本文介绍如何使用Python结合Selenium库实现QQ钱包的实时到账免签支付功能。通过自动化登录腾讯交易页面,抓取JSON格式的订单数据,自动判断支付状态并生成对应金额的卡密。文章提供了完整的代码逻辑、环境配置要求及注意事项,适用于开发者搭建简单的支付验证系统。
本文详细介绍如何使用Python Selenium库对Cookie进行获取、添加和删除操作。通过具体代码示例展示API用法,并深入解析Cookie的Domain、Path、Expire/Max-age、Secure及HttpOnly等关键属性,帮助开发者掌握浏览器状态管理的核心技巧。
本文介绍如何利用Python3的Selenium库定位网页元素,结合Tesserocr或Pytesseract进行图像识别,实现图片验证码的自动获取、预处理及识别,从而完成网页自动登录功能。文中提供了两种获取验证码截图的方法,并详细讲解了通过灰度化和二值化处理去除干扰线的技巧,以提升识别准确率。
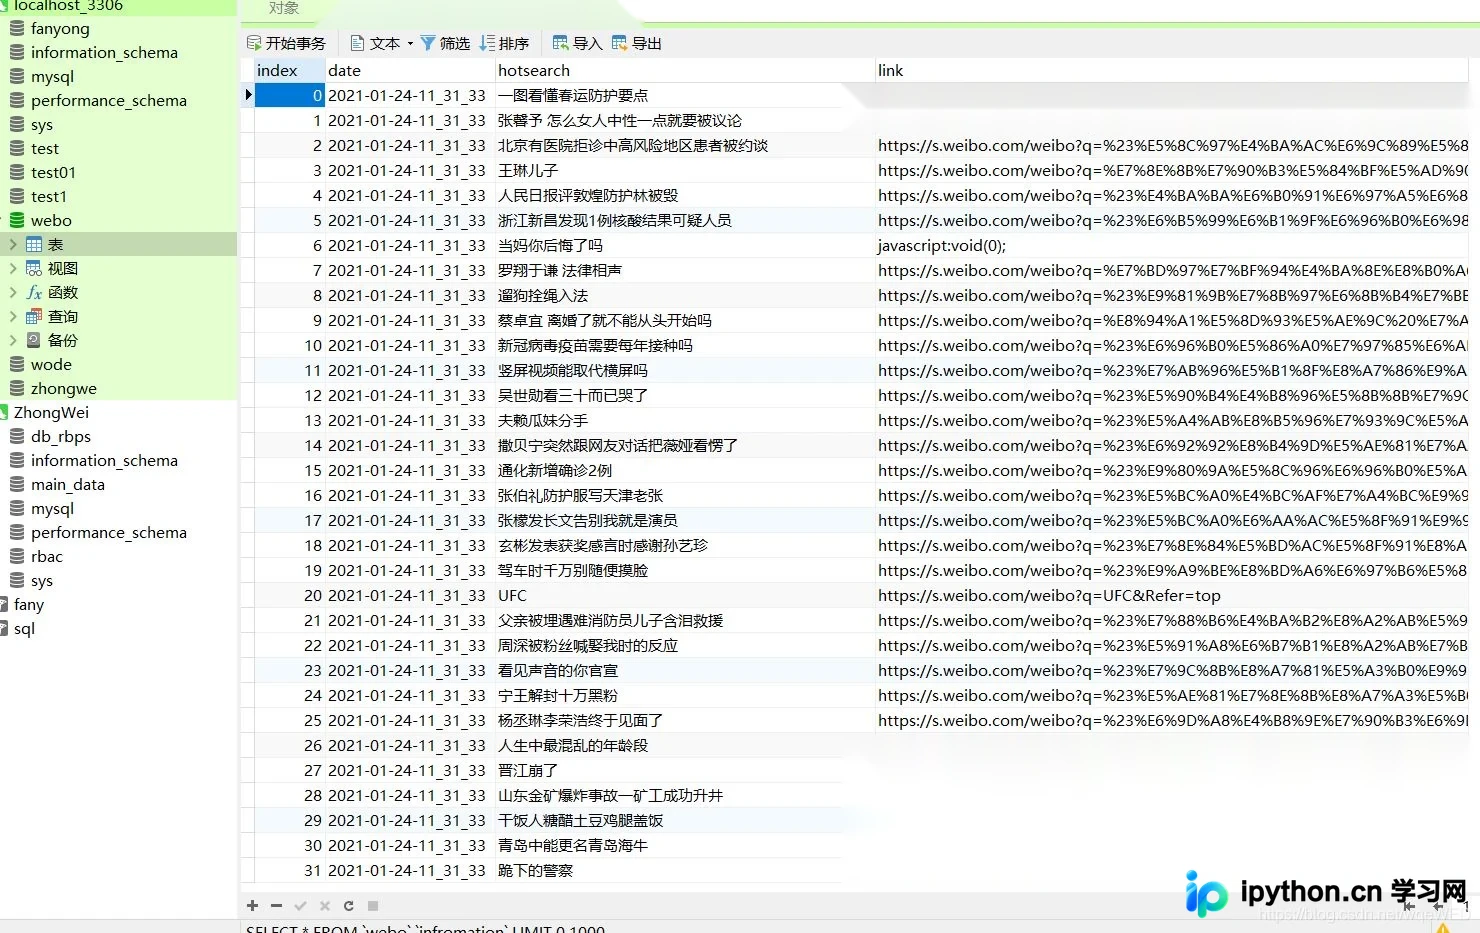
本文详细介绍如何利用Python结合Selenium库自动化抓取微博热搜数据,并通过Pandas处理数据后存入MySQL数据库。文章涵盖环境配置、网页元素定位、数据清洗合并及数据库连接写入等关键步骤,提供完整代码示例,帮助开发者快速实现热搜数据的自动化采集与持久化存储。
本文介绍如何使用Python和Selenium库模拟登录B站。代码涵盖了初始化浏览器选项、处理滑块验证码的逻辑,并提供了完整的示例代码。注意需将Chrome浏览器路径加入环境变量,并确保电脑缩放比例为100%以避免验证码图片获取异常。
本文详解Selenium中driver.close()与driver.quit()的区别,指出close仅关闭当前标签页而quit关闭所有窗口并退出驱动。针对Windows下ChromeDriver进程残留问题,介绍了Java中通过ChromeDriverService管理进程以及Python中使用Service库或os模块强制结束进程的方法,确保测试环境整洁。

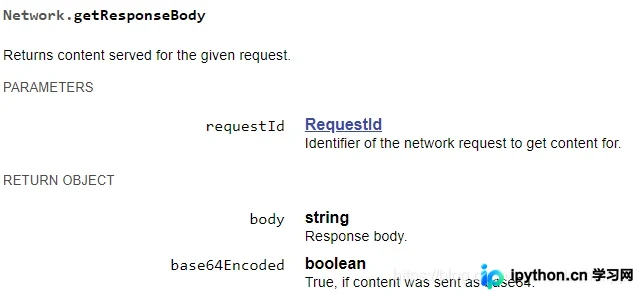
本文介绍如何在 Python Selenium 中通过 Chrome DevTools Protocol (CDP) 获取接口数据。Selenium 本身不提供直接查询接口响应的方法,但可通过配置性能日志(performance logging)捕获 requestid,进而调用 Network.getResponseBody 命令提取特定 URL 的完整响应内容。
本文详解在Python Selenium中如何利用XPath根据元素文本内容精准定位元素。针对无固定ID或Class的场景,深入解析text()精确匹配与contains()模糊匹配两种核心方法,并附带完整代码示例,帮助开发者解决动态页面元素查找难题。
本文详细介绍 Python Selenium 中两种核心元素等待机制:显式等待与隐式等待。通过 WebDriverWait 类结合 expected_conditions 实现精准的元素状态检测,以及利用 implicitly_wait 设置全局超时轮询。文章包含完整代码示例与参数解析,帮助开发者解决页面加载不同步导致的定位失败问题,提升爬虫稳定性。