

Python+Selenium爬取微博热搜并存储至MySQL的完整实现

发布时间:2026-10-14| 4人浏览过
本文详细介绍如何利用Python结合Selenium库自动化抓取微博热搜数据,并通过Pandas处理数据后存入MySQL数据库。文章涵盖环境配置、网页元素定位、数据清洗合并及数据库连接写入等关键步骤,提供完整代码示例,帮助开发者快速实现热搜数据的自动化采集与持久化存储。
最终运行效果展示
此处省略无关叙述,直接查看运行结果截图
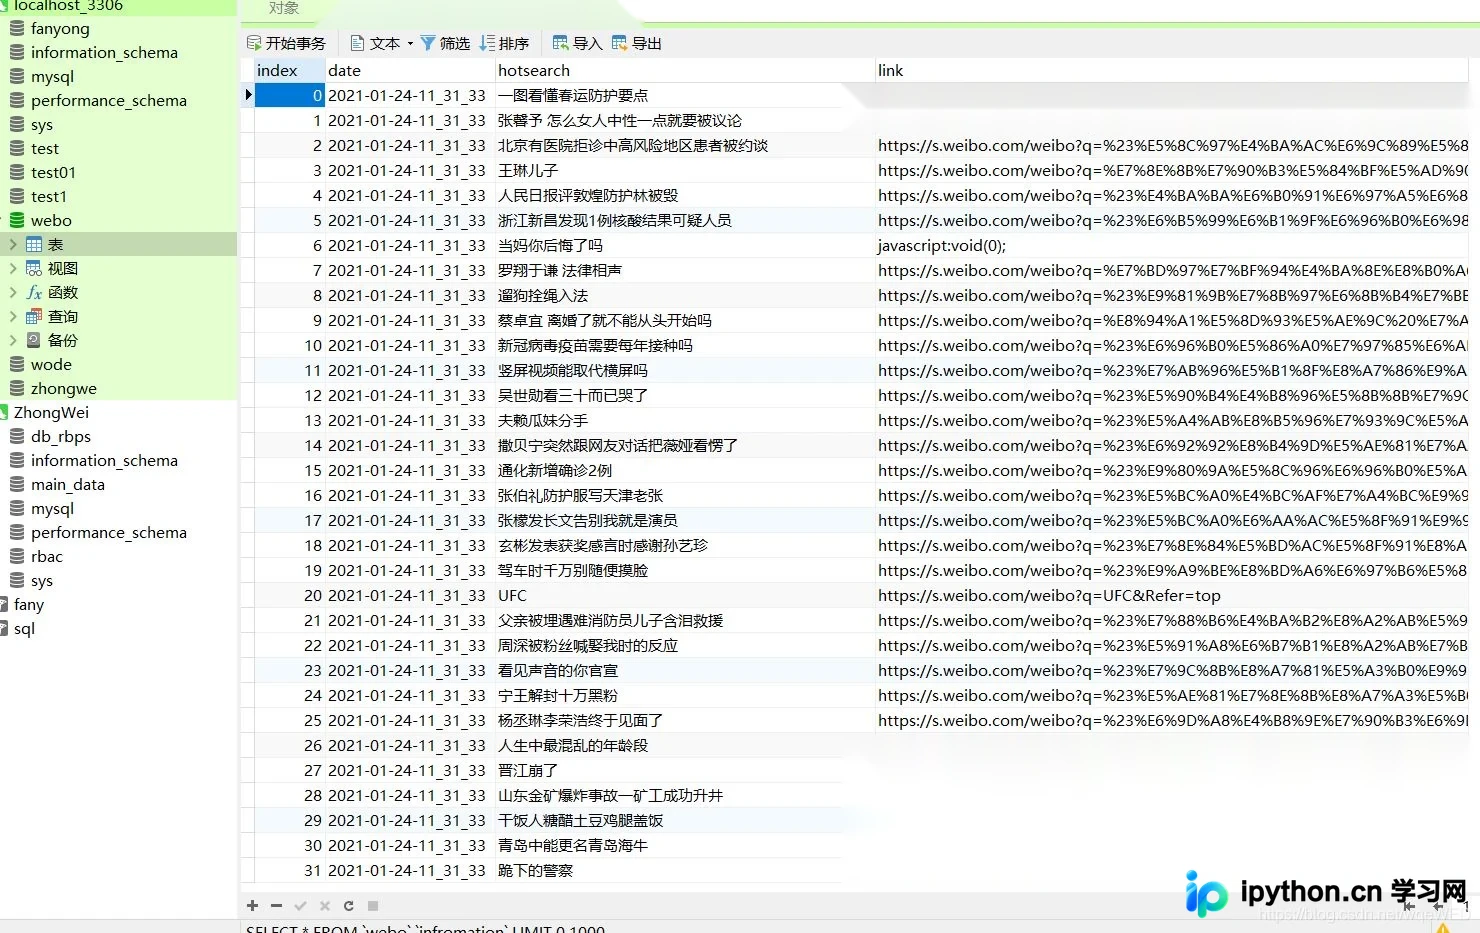
从截图中可以清晰看到,数据库表中已包含日期、热搜内容标题以及对应的跳转链接。接下来我们将逐步分析实现这一过程的具体方法。
所需依赖库
import requests
from selenium.webdriver import Chrome, ChromeOptions
import time
from sqlalchemy import create_engine
import pandas as pd
目标网页分析
微博热搜页面的访问链接如下:点击此处访问目标网页
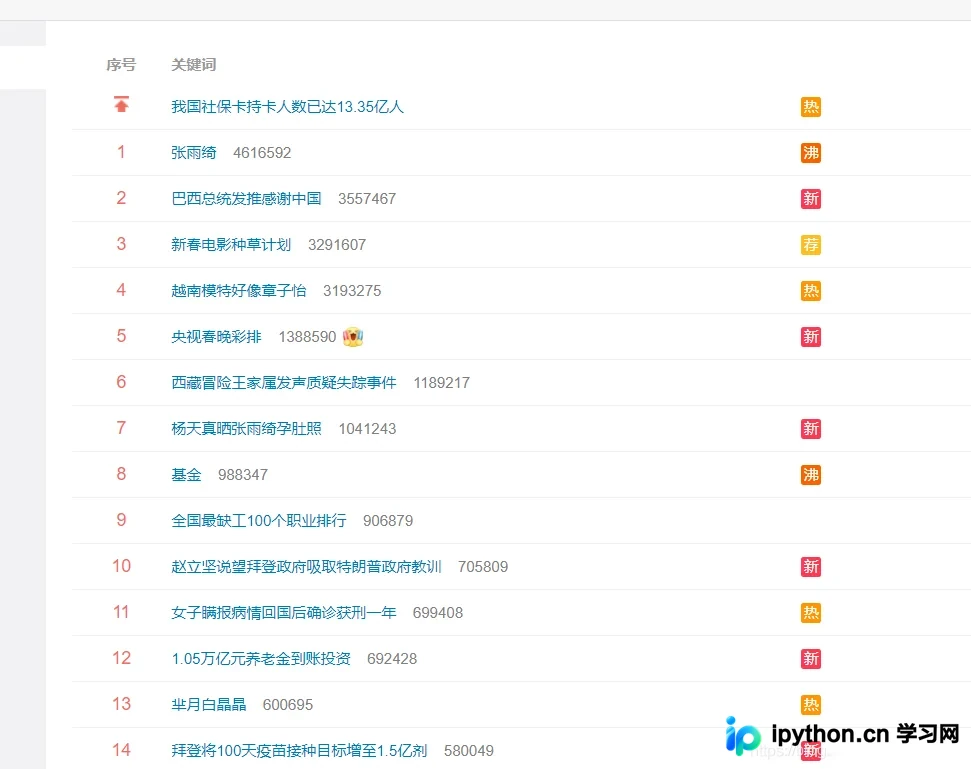
首先,利用Selenium库对目标网页发起请求。接着,通过XPath定位网页中的具体元素,遍历并提取所有相关数据。最后,使用Pandas库生成DataFrame对象,直接将其写入数据库。
第一步:数据获取
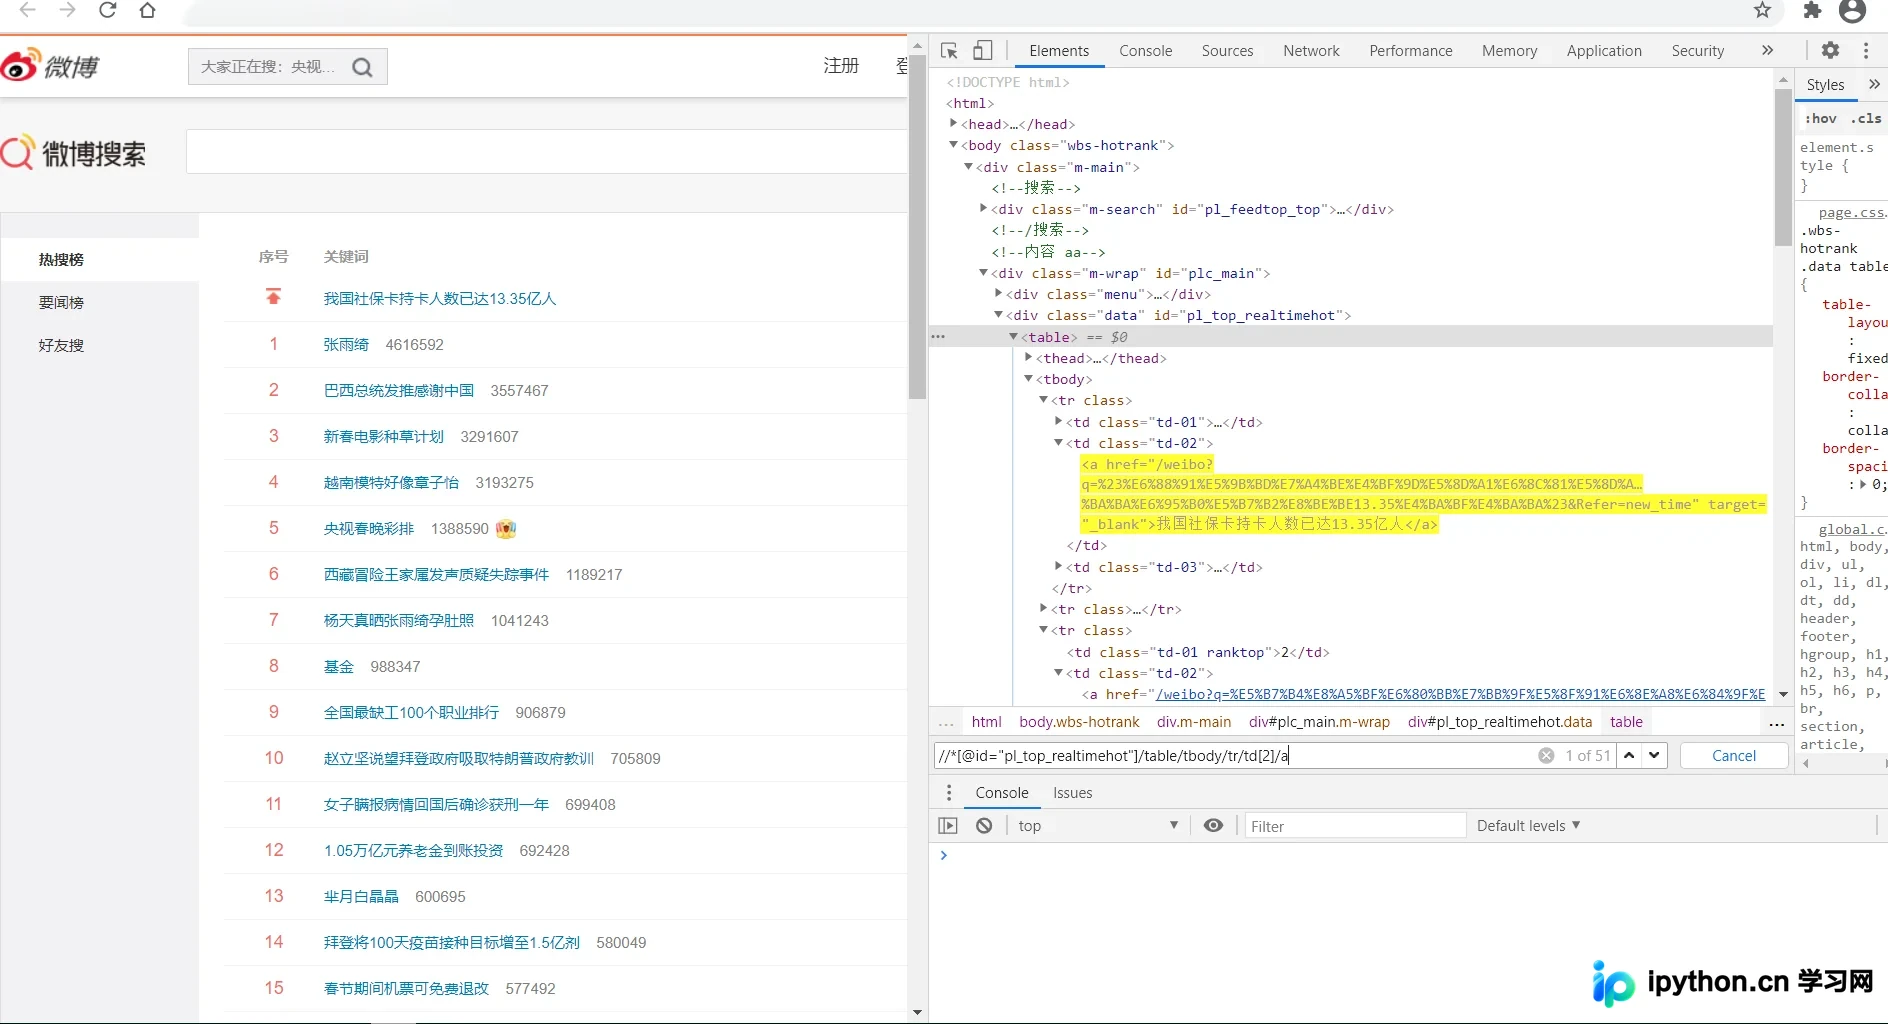
通过XPath定位,我们可以获取到51条热搜数据。从中可以提取出每条热搜的标题内容和对应的链接地址。
all = browser.find_elements_by_xpath('//*[@id="pl_top_realtimehot"]/table/tbody/tr/td[2]/a') #得到所有数据
	context = [i.text for i in c] # 得到标题内容
  links = [i.get_attribute('href') for i in c] # 得到link
随后,利用zip函数将date(日期)、context(内容)和links(链接)三个列表进行合并。zip函数的作用是将多个列表按索引位置组合成元组,这种结构可以直接用于生成Pandas对象。
dc = zip(dates, context, links)
  pdf = pd.DataFrame(dc, columns=['date', 'hotsearch', 'link'])
其中,date字段可以通过Python内置的time模块获取当前时间。
第二步:连接数据库
数据库连接配置相对简单。
enging = create_engine("mysql+pymysql://root:123456@localhost:3306/webo?charset=utf8")
pdf.to_sql(name='infromation', con=enging, if_exists="append")
完整代码示例
from selenium.webdriver import Chrome, ChromeOptions
import time
from sqlalchemy import create_engine
import pandas as pd

def get_data():
  url = r"https://s.weibo.com/top/summary" # 微博的地址
  option = ChromeOptions()
  option.add_argument('--headless')
  option.add_argument("--no-sandbox")
  browser = Chrome(options=option)
  browser.get(url)
  all = browser.find_elements_by_xpath('//*[@id="pl_top_realtimehot"]/table/tbody/tr/td[2]/a')
  context = [i.text for i in all]
  links = [i.get_attribute('href') for i in all]
  date = time.strftime("%Y-%m-%d-%H_%M_%S", time.localtime())
  dates = []
  for i in range(len(context)):
    dates.append(date)
  # print(len(dates),len(context),dates,context)
  dc = zip(dates, context, links)
  pdf = pd.DataFrame(dc, columns=['date', 'hotsearch', 'link'])
  # pdf.to_sql(name=in, con=enging, if_exists="append")
  return pdf

def w_mysql(pdf):
  try:
    enging = create_engine("mysql+pymysql://root:123456@localhost:3306/webo?charset=utf8")
    pdf.to_sql(name='infromation', con=enging, if_exists="append")
  except:
    print('出错了')

if __name__ == '__main__':
  xx = get_data()
  w_mysql(xx)
至此,关于使用Python+Selenium爬取微博热搜并存入MySQL的实现方法介绍完毕。如需了解更多相关Python Selenium爬虫知识,请搜索本站往期文章或继续浏览后续内容,希望大家多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









