

Python3爬虫实战:利用超级鹰API识别点触验证码
本文详解如何使用Python3结合Selenium与超级鹰API识别点触验证码。针对OCR技术处理变形文字和复杂背景效果不佳的问题,介绍通过在线打码平台获取坐标的方案。内容涵盖账号注册、API封装、图片截取、坐标解析及模拟点击全流程,适用于12306等常见点触场景。
2026-10-14
6

本文详解如何使用Python3结合Selenium与超级鹰API识别点触验证码。针对OCR技术处理变形文字和复杂背景效果不佳的问题,介绍通过在线打码平台获取坐标的方案。内容涵盖账号注册、API封装、图片截取、坐标解析及模拟点击全流程,适用于12306等常见点触场景。
本文详细讲解利用Python和Selenium破解极验3.0滑动验证码的完整流程。通过图像对比算法精准定位缺口位置,并基于物理运动学公式模拟人类加速减速的拖动轨迹,有效绕过后台风控检测,实现自动化登录验证。
本文详细讲解Python爬虫中请求头(Headers)的设置方法,涵盖Requests、Selenium(Chrome/PhantomJS)、Scrapy框架及Aiohttp异步库。通过模拟浏览器头部信息,有效绕过网站反爬限制。内容包含具体代码示例及获取Headers的实操步骤,帮助开发者解决访问被拒问题。
本文介绍Python中muggle_ocr模块的安装与使用方法,涵盖光学印刷文本与4-6位验证码两种识别模式。结合Selenium与PhantomJS实现网页自动登录,演示如何截取验证码图片并调用第三方接口或本地SDK进行识别,最终完成全自动登录流程。
本文介绍如何使用 Python 的 Selenium 库结合 Chrome 驱动,实现 CSDN 网站的自动登录流程。内容涵盖定位账号密码输入框、点击登录按钮触发验证,以及通过 ActionChains 模拟鼠标拖拽动作处理滑动验证码。文中提供了完整的代码示例及针对初学者的滑动验证策略建议,帮助读者掌握自动化测试中的常见验证绕过技巧。
本文分析使用Python Selenium结合多线程执行定时任务时,因频繁启动浏览器实例导致CPU占用率飙升至90%以上的问题。通过展示基于threading.Timer的简易定时代码,指出其潜在性能瓶颈,并探讨如何优化资源占用以避免系统卡顿,适用于需要长期运行的自动化爬虫场景。
本文介绍使用Python3.7结合Selenium库实现淘宝网站密码登录的完整流程。重点解析如何应对登录时的滑动验证码挑战,通过定位元素、计算滑动距离及模拟轨迹,成功绕过验证机制。文章提供从环境配置到代码实现的详细步骤,帮助开发者掌握自动化登录技巧。
本文介绍如何使用Python Selenium库进行网页截图。通过演示get_screenshot_as_file和save_screenshot两个方法,展示如何将百度首页保存为指定格式的PNG图片,并生成带时间戳的文件名。
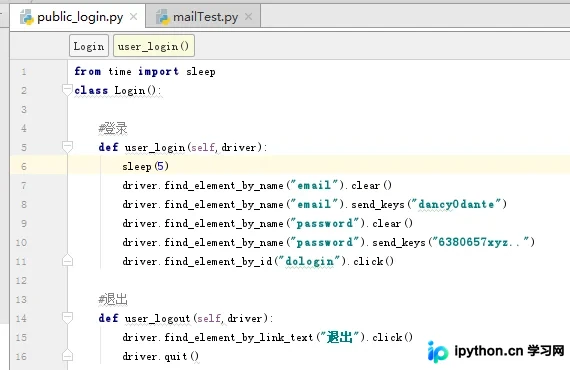
本文深入解析Python Selenium自动化测试的三种核心模型:线性测试、模块化驱动测试及数据驱动测试。详细对比各模型在开发成本、维护复杂度及脚本复用性方面的优劣,并通过具体代码逻辑说明如何实现参数化、文件读取(TXT/CSV/XML)及函数封装,旨在帮助测试人员提升脚本可维护性与执行效率。
本文详细介绍在Linux系统中安装Chrome浏览器及Chromedriver的方法,推荐使用淘宝镜像源加速下载。重点解析Python Selenium脚本配置,包括无头模式、沙箱参数及字体安装以解决中文乱码。同时针对截图时常见的TimeoutException异常,提供通过添加headless及禁用GPU等参数的具体解决方案。
本文详细介绍Python Selenium中ChromeOptions类的核心配置方法。涵盖禁止图片加载、添加代理IP、修改User-Agent、设置编码及禁用JavaScript等常用技巧,并提供关闭密码提示框、添加扩展插件等高级配置代码示例,帮助开发者提升爬虫稳定性与执行效率。
本文介绍Selenium处理网页内容需滚动加载的两种方法:调整浏览器窗口高度延时加载,以及模拟下拉滚动操作。针对懒加载特性,强调page_source仅包含已加载内容,需通过模拟滚动触发加载。提示网速慢时需增加等待时间,确保获取完整HTML后再执行翻页或元素定位操作。