Python+Selenium批量获取元素属性值的方法
本文介绍使用Python结合Selenium库批量获取网页元素属性值的具体实现方法。通过find_elements_by_class_name定位元素列表,利用get_attribute方法提取指定属性(如href)的值,并演示了完整的遍历与打印流程,供开发者参考。
2026-10-13
6

本文介绍使用Python结合Selenium库批量获取网页元素属性值的具体实现方法。通过find_elements_by_class_name定位元素列表,利用get_attribute方法提取指定属性(如href)的值,并演示了完整的遍历与打印流程,供开发者参考。
本文介绍了使用Python Selenium库获取当前浏览器页面标题和URL的方法。通过dr.title属性可获取页面标题,dr.current_url属性可获取当前网址。结合完整代码示例,展示了如何初始化Firefox驱动、访问指定页面并打印相关信息,最后关闭浏览器。
针对淘宝、京东等动态加载网站,直接请求无法获取完整数据。本文介绍如何在Scrapy框架中通过中间件集成Selenium,利用无头浏览器模拟滚动和交互,获取渲染后的完整HTML源码,并构造HtmlResponse对象直接返回,从而绕过传统下载器,实现高效的数据抓取。
本文详解利用Python和Selenium破解滑动验证码的完整流程。通过截取完整图与缺口图,对比像素差异计算滑动距离,并结合ActionChains模拟人类拖拽轨迹。文章提供国家企业公示网站的实战代码,涵盖驱动配置、重试机制及PhantomJS替代方案,帮助开发者掌握自动化突破图形验证的技术。
本文提供基于Python和Selenium库的自动化脚本,用于实现QQ邮箱漂流瓶的自动投递功能。代码包含浏览器驱动初始化、QQ邮箱登录流程、iframe切换及漂流瓶页面的交互逻辑,并通过循环尝试投递瓶子,直至机会耗尽或达到错误上限。
本文介绍如何通过修改 Selenium 源码中的 Service 类 start 函数,利用 subprocess.STARTUPINFO 参数在 Windows 平台下隐藏浏览器驱动启动时弹出的黑色 CMD 窗口,并强调需在程序结束时手动杀死驱动进程以避免残留。
本文介绍一个基于Python和Selenium的12306余票自动查询脚本。该脚本可监控指定车次、日期及席别的余票变化,当票数出现变动时,自动通过SMTP协议向指定QQ邮箱发送提醒邮件,帮助用户高效捡漏。

本文详细解析 Python3 Selenium 中切换浏览器窗口的两种常用方法。第一种通过获取 window_handles 列表并直接切换至最新句柄,代码简洁且性能较高;第二种通过遍历所有窗口句柄并排除当前窗口来定位新窗口,逻辑直观且易于理解。文章包含具体代码示例及对比分析,帮助开发者根据实际需求选择合适方案。
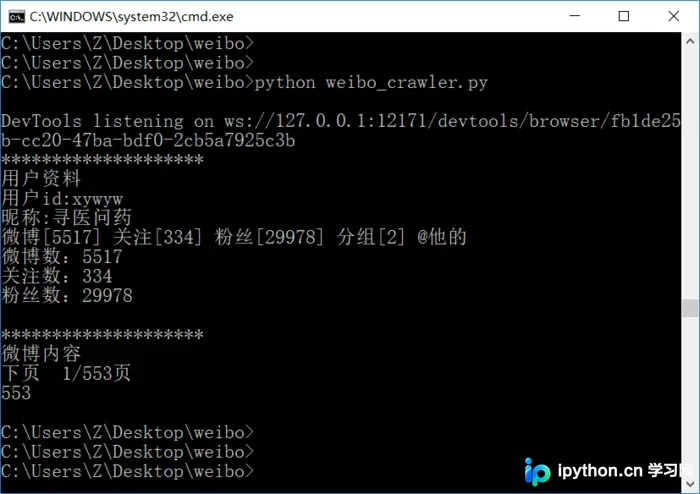
本文介绍如何利用Python的Selenium库实现微博内容的自动化抓取。通过模拟浏览器登录操作,获取指定用户的昵称、微博数及粉丝数等公开信息,并将结果保存至文本文件。文章提供了完整的安装步骤、代码示例及运行结果分析,同时指出了高频爬取可能导致IP被封的风险,适合初学者学习Web自动化与数据提取技术。
本文介绍如何利用Python结合Selenium库与PhantomJS无头浏览器进行网页截图。通过实例代码展示获取页面标题、保存截图文件及打印当前工作目录的具体步骤,为需要自动化抓取网页视觉内容的开发者提供参考方案。
本文详细讲解Python爬虫中如何有效设置代理IP及伪装浏览器身份。内容涵盖使用urllib模块配置请求头、添加代理服务器、处理POST请求参数,以及利用PhantomJS和Selenium WebDriver模拟真实浏览器行为。通过具体代码示例,帮助开发者规避反爬限制,提升数据采集成功率。
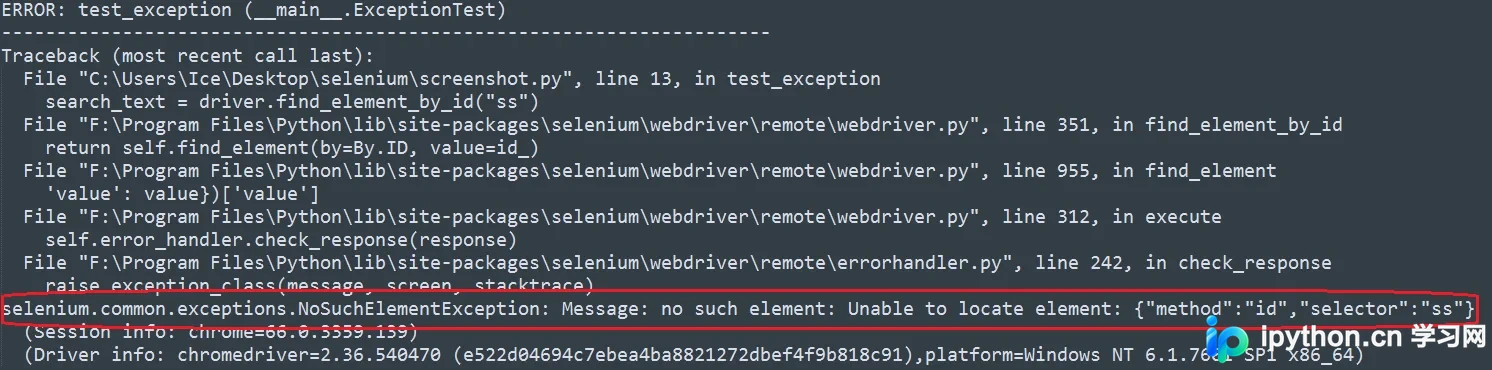
本文详解Python Selenium自动化测试中的异常处理机制。通过try...except...raise结构捕获NoSuchElementException和ElementNotVisibleException,并结合save_screenshot或get_screenshot_as_file方法保存当前浏览器窗口截图,辅助定位Bug。文章提供完整代码示例,解析常见Selenium异常类型及处理策略。