

Python使用Selenium自动化抓取微博用户数据教程

发布时间:2026-10-13| 6人浏览过
本文介绍如何利用Python的Selenium库实现微博内容的自动化抓取。通过模拟浏览器登录操作,获取指定用户的昵称、微博数及粉丝数等公开信息,并将结果保存至文本文件。文章提供了完整的安装步骤、代码示例及运行结果分析,同时指出了高频爬取可能导致IP被封的风险,适合初学者学习Web自动化与数据提取技术。
Selenium简介与安装
Selenium是什么?
Selenium是一款专注于Web应用程序测试的工具,其测试过程直接在浏览器中执行,模拟真实用户的交互行为。它支持包括IE、Mozilla Firefox、Mozilla Suite在内的多种主流浏览器。
安装
用户可直接通过pip命令完成安装,操作简便快捷。
pip install selenium
在Python中抓取微博数据主要有两种途径:一是利用Selenium模拟登录后直接从页面提取内容,二是通过官方API接口获取。
本文示例采用Selenium方式实现。
程序代码实现如下:
from selenium import webdriver
import time
import re
#全局变量
driver = webdriver.Chrome("C:\Program Files (x86)\Google\Chrome\Application\chromedriver.exe")

def loginWeibo(username, password):
  driver.get('https://passport.weibo.cn/signin/login')
  time.sleep(1)

  driver.find_element_by_id("loginName").send_keys("haishu_zheng@163.com")
  driver.find_element_by_id("loginPassword").send_keys("Weibo01061122")

  time.sleep(1)
  driver.find_element_by_id("loginAction").click()

  #driver.close()

def visitUserPage(userId):
  driver.get('http://weibo.cn/' + userId)

  print('********************')
  print('用户资料')

  # 1.用户id
  print('用户id:' + userId)

  # 2.用户昵称
  strName = driver.find_element_by_xpath("//div[@class='ut']")
  strlist = strName.text.split(' ')
  nickname = strlist[0]
  print('昵称:' + nickname)

  # 3.微博数、粉丝数、关注数
  strCnt = driver.find_element_by_xpath("//div[@class='tip2']")
  pattern = r"\d+\.?\d*" # 匹配数字,包含整数和小数
  cntArr = re.findall(pattern, strCnt.text)
  print(strCnt.text)
  print("微博数:" + str(cntArr[0]))
  print("关注数:" + str(cntArr[1]))
  print("粉丝数:" + str(cntArr[2]))

  print('\n********************')
  # 4.将用户信息写到文件里
  with open("weibo.txt", "w", encoding = "gb18030") as file:
    file.write("用户ID:" + userId + '\r\n')
    file.write("昵称:" + nickname + '\r\n')
    file.write("微博数:" + str(cntArr[0]) + '\r\n')
    file.write("关注数:" + str(cntArr[1]) + '\r\n')
    file.write("粉丝数:" + str(cntArr[2]) + '\r\n')

  # 5.获取微博内容
  # http://weibo.cn/ + userId + ? filter=0&page=1
  # filter为0表示全部,为1表示原创
  print("微博内容")

  pageList = driver.find_element_by_xpath("//div[@class='pa']")
  print(pageList.text)
  pattern = r"\d+\d*"     # 匹配数字,只包含整数
  pageArr = re.findall(pattern, pageList.text)
  totalPages = pageArr[1]   # 总共有多少页微博
  print(totalPages)

  pageNum = 1     # 第几页
  numInCurPage = 1      # 当前页的第几条微博内容
  contentPath = "//div[@class='c'][{0}]"
  while(pageNum <= 3):
  #while(pageNum <= int(totalPages)):
    contentUrl = "http://weibo.cn/" + userId + "?filter=0&page=" + str(pageNum)
    driver.get(contentUrl)
    content = driver.find_element_by_xpath(contentPath.format(numInCurPage)).text
    # print("\n" + content) # 微博内容,包含原创和转发
    if "设置:皮肤.图片.条数.隐私" not in content:
      numInCurPage += 1
      with open("weibo.txt", "a", encoding = "gb18030") as file:
        file.write("\r\n" + "\r\n" + content)  # 将微博内容逐条写到weibo.txt中
    else:
      pageNum += 1            # 抓取新一页的内容
      numInCurPage = 1          # 每一页都是从第1条开始抓

if __name__ == '__main__':
  username = 'haishu_zheng@163.com'  # 输入微博账号
  password = 'Weibo01061122'     # 输入密码
  loginWeibo(username, password)   # 要先登录,否则抓取不了微博内容
  time.sleep(3)
  uid = 'xywyw'            # 寻医问药
  visitUserPage(uid)
程序运行后的输出结果如下:
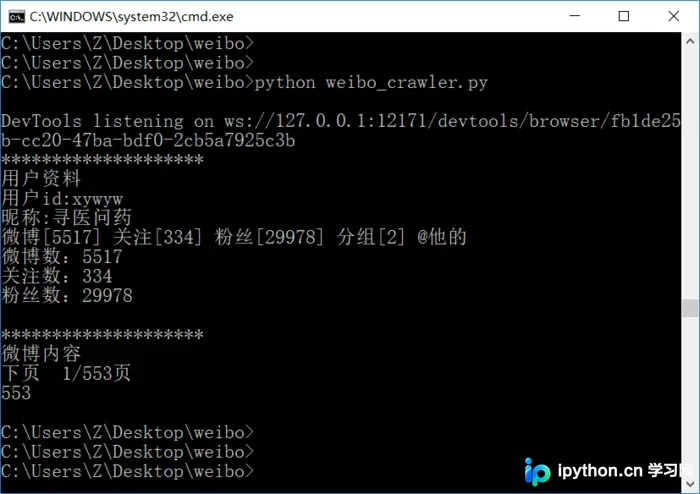
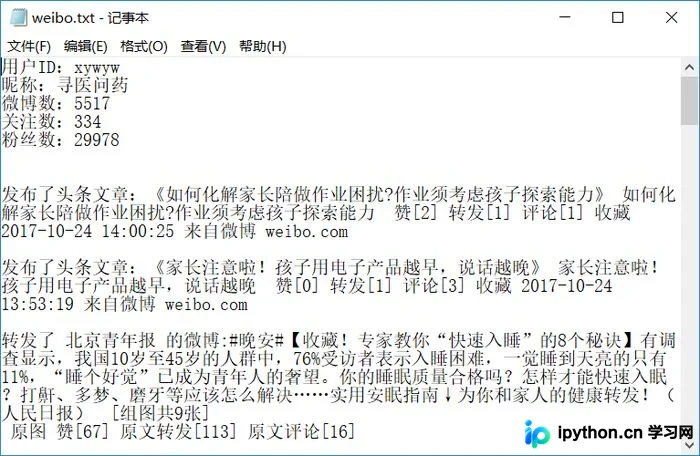
执行过程中会生成一个名为weibo.txt的文件,其内部包含的具体内容如下所示:
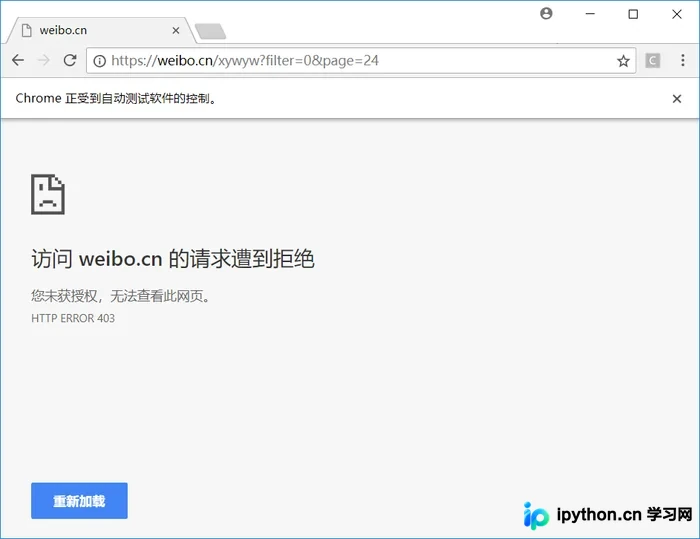
该方法存在一个明显的局限性,即当抓取数据量较大时,容易触发微博的安全机制导致IP被封禁:
以上即为本文分享的全部内容,希望能为读者的学习带来帮助,同时也欢迎大家继续支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









