

Python+Selenium实现自动化百度搜索关键词
本文介绍如何利用Python配合Selenium库实现自动化打开Chrome浏览器进行百度关键词搜索。内容涵盖Python及Selenium的安装、chromedriver的配置、爬虫代理接口的获取,以及包含IP池管理的完整自动化搜索代码示例与运行效果。
2026-10-13
6

本文介绍如何利用Python配合Selenium库实现自动化打开Chrome浏览器进行百度关键词搜索。内容涵盖Python及Selenium的安装、chromedriver的配置、爬虫代理接口的获取,以及包含IP池管理的完整自动化搜索代码示例与运行效果。
本文详细讲解如何在Windows系统中搭建Selenium + Python自动化测试环境。内容涵盖Python安装与环境变量配置、Selenium库及Firefox驱动(Geckodriver)的安装步骤,以及PyCharm开发环境的集成与依赖管理。通过命令行操作与图形界面设置相结合,帮助开发者快速解决导入失败问题,顺利开启Web自动化测试开发。
本文详细解析如何利用OpenCV破解腾讯滑块验证码。通过Python实现两种核心算法:基于模板匹配的缺口识别(准确率约50%-90%)和基于轮廓检测的高精度方案(准确率95%以上)。文章涵盖环境配置、图像预处理、API调用及Selenium模拟拖动,并探讨背景透明化与轨迹算法优化等遗留问题。
本文介绍如何使用Python结合Selenium库实现京东秒杀功能。主要步骤包括环境配置、登录自动化、购物车定位及定时提交订单。代码基于Python 3.5编写,通过模拟浏览器操作自动完成登录、进入购物车并在规定时间内提交订单,适用于熟悉Python基础的用户参考。
本文详解如何使用Selenium模拟登录腾讯新闻网页版。针对部分账号触发的滑块验证,文章深入分析了TX滑块与极验的区别,重点讲解了Frame切换、蓝色滑块定位、移动轨迹构造及验证成功判断逻辑,并提供完整的Python重试代码实现。

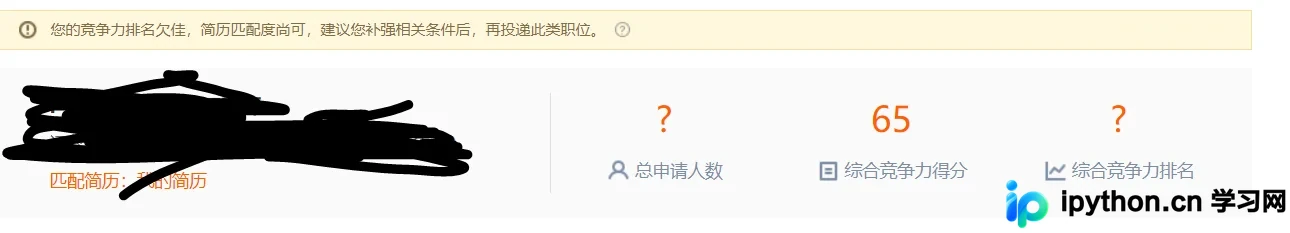
本文介绍如何使用Python结合Selenium和Requests库,自动化获取前程无忧职位的竞争力得分与匹配度评价。通过解析页面结构提取职位ID,利用MongoDB去重存储数据,并筛选高匹配度职位进行批量自动投递,旨在提高求职效率。
在使用Java和Selenium进行Web自动化测试时,常因目标元素位于iframe内而无法直接定位。本文通过HTML示例页面,详细演示了如何使用switchTo().frame()进入指定iframe,以及如何通过switchTo().defaultContent()返回主窗口,解决跨框架元素操作报错问题。
本文介绍了在 Java 环境下使用 Selenium WebDriver 处理浏览器弹出窗口和标签页切换的方法。核心逻辑是通过 driver.getWindowHandles() 获取所有窗口句柄集合,遍历并比对标题定位目标窗口,再利用 driver.switchTo().window(handle) 完成上下文切换,最后可切回父窗口继续操作。
本文详解如何使用 Python 和 Selenium 库自动化抓取网易云音乐公开歌单列表。重点讲解如何定位 iframe 框架、处理页面延迟加载以及通过判断按钮状态实现自动翻页,最终完整获取多页歌单名称数据。
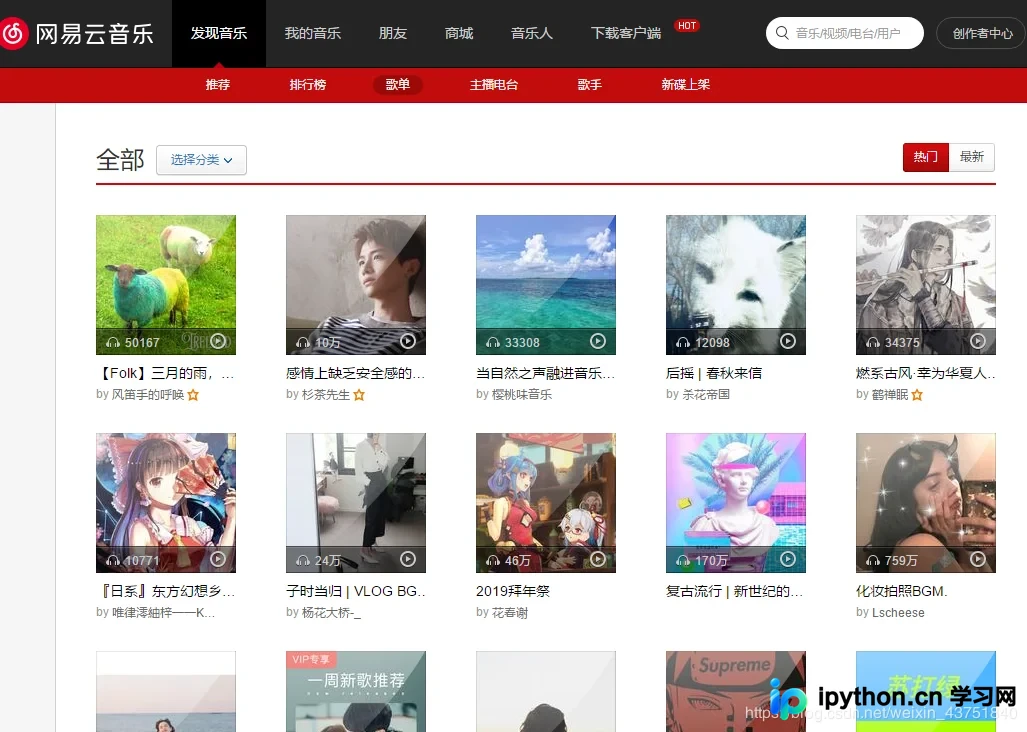
本文介绍如何使用Python的Selenium模块配合Chrome浏览器,通过15行核心代码抓取网易云音乐播放量超过1000万的热门歌单。教程涵盖环境配置、ChromeDriver下载与路径设置,以及利用开发者工具分析DOM结构实现自动翻页和数据保存的完整流程。
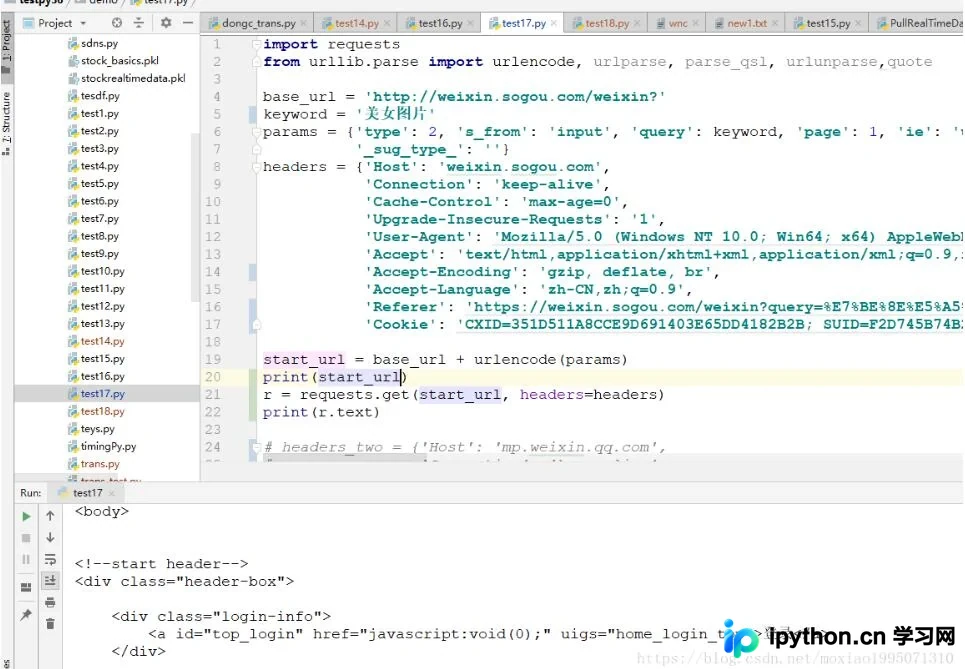
本文基于《Python3网络爬虫开发实践》案例,针对腾讯网站更新后导致的Cookie登录失效问题提供解决方案。通过整合Selenium浏览器自动化与代理池技术,详细演示了如何配置Chrome驱动、设置请求头及处理重试机制,帮助开发者应对反爬策略变更,实现稳定的微信文章数据抓取。
本文介绍如何利用Python的Selenium库模拟浏览器行为,实现百度搜索引擎的自动输入、内容修改及搜索提交。通过实例演示了文本输入、Backspace删除、空格添加、全选剪切粘贴及回车搜索等具体操作步骤,适用于Web自动化测试场景。