Python实现基于TinyPNG的图片批量压缩脚本
本文介绍使用Python结合Selenium和TinyPNG接口实现图片批量无损压缩的方法。通过优化上传时机、采用多线程下载及遍历本地文件夹策略,显著提升处理效率。代码包含基础版与改进版,重点解决网络加载等待与并发下载问题,适用于Android项目等资源文件的自动化压缩场景。
2026-10-12
6

本文介绍使用Python结合Selenium和TinyPNG接口实现图片批量无损压缩的方法。通过优化上传时机、采用多线程下载及遍历本地文件夹策略,显著提升处理效率。代码包含基础版与改进版,重点解决网络加载等待与并发下载问题,适用于Android项目等资源文件的自动化压缩场景。
本文详解Python爬取动态网页的两种主流方案:Dryscrape与Selenium。重点讲解Selenium在Ubuntu下的安装步骤,包括geckodriver的下载与路径配置,以及解决Firefox版本兼容性问题。通过代码示例演示如何调用浏览器引擎获取JS执行后的页面源码,并解决常见报错,如模块调用错误及元素定位方法。
本文介绍利用 Python Selenium 打开浏览器并启用 --save-page-as-mhtml 参数,配合 pyautogui 和 pyperclip 模拟键盘鼠标操作,实现微信公众号历史文章等页面的 MHTML 格式离线打包下载。通过自动化处理保存对话框,解决单纯获取 page_source 导致图片缺失的问题,并提供完整的代码实现与 VBA 超链接生成方法。
本文介绍使用Python结合Selenium WebDriver与多线程技术,实现对多个平台短信验证接口的自动化调用。内容涵盖环境配置、ChromeDriver路径设置、线程安全操作及具体平台(如知乎、瓜子二手车等)的请求逻辑,旨在提供自动化测试场景下的代码参考。
本文详解如何利用Selenium模拟浏览器登录以获取完整Cookie,随后通过Requests库的Session对象复用这些凭证进行后续请求。文章提供了从配置Chrome选项、提取Cookie到构建Headers及随机User-Agent的完整代码示例,旨在解决需要登录态才能访问资源的爬虫场景,并指出了fake-useragent库在使用中可能存在的版本兼容问题。
本文介绍如何利用Python和Selenium进行GUI自动化,通过获取登录后的Cookie实现绕过验证码登录。文章详细展示了获取Cookie的代码逻辑,以及如何将Cookie注入浏览器以跳过登录验证步骤,为自动化测试和批量操作提供参考。
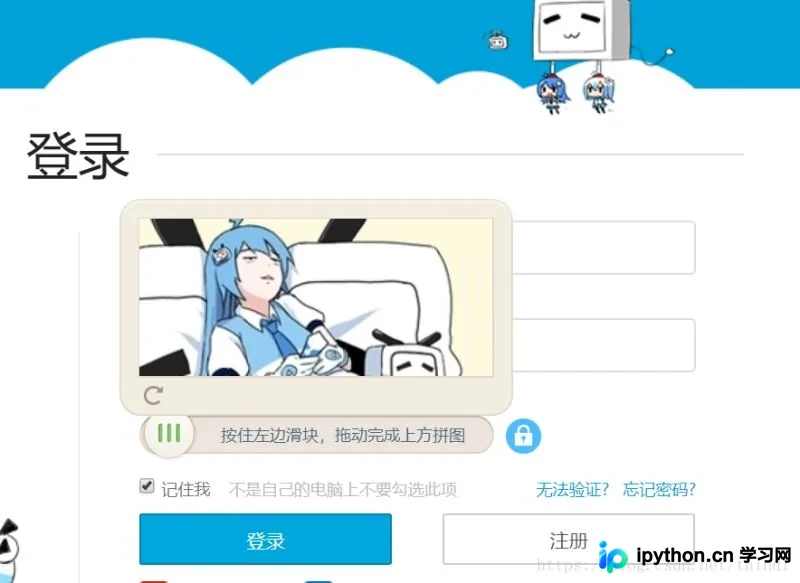
本文详细介绍使用Python结合Selenium和PIL库破解Bilibili滑动验证码的实现过程。通过获取完整与缺口验证码图片,利用图像分割与像素比对计算滑块位移,并模拟人类运动轨迹完成拖动。文中提供了从环境配置到代码实现的全流程解析,帮助开发者掌握自动化登录技术。
本文介绍如何使用Python Selenium库实现网页的定时刷新与批量操作。通过配置Firefox或Chrome浏览器驱动,结合time和random模块控制刷新频率,实现自动化刷新指定URL。文章包含完整代码示例,涵盖页面刷新方法、异常处理及浏览器生命周期管理,适用于熟悉Selenium基础函数的开发者,为后续自动化任务如短信轰炸等场景提供技术铺垫。
本文介绍使用Selenium结合Python实现网页自动登录的方法,以微博为例演示完整流程。重点解析Python 2.7与Selenium 3.0.2及Firefox特定版本的兼容性问题,提供geckodriver与浏览器版本的匹配建议。通过XPath定位元素、输入账号密码并提交,并获取Cookie。文中包含完整代码示例及常见报错排查指南,适合初学者参考。
本文详细解析了利用Python Selenium WebDriver自动化操作浏览器登录微信公众号后台,并抓取文章内容的完整流程。通过模拟输入账号密码、获取Cookie并持久化存储,结合Requests库调用后台接口实现文章数据的批量下载与本地保存,为公众号数据抓取提供了可参考的代码实现。
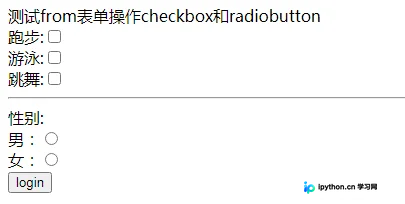
本文详细介绍在Python Selenium自动化测试中如何操作HTML表单中的复选框(Checkbox)和单选按钮(Radio Button)。通过具体示例代码,演示了如何利用click()方法实现选项的选择与反选,以及如何根据名称定位元素组并依据值进行单选操作。内容涵盖HTML结构分析与Python脚本实现,适用于Web自动化测试初学者参考。
本文介绍如何利用Python的Selenium库模拟浏览器操作,实现企业或内部系统的自动签到功能。内容涵盖环境配置、ChromeDriver版本匹配、核心代码逻辑解析及定时任务设置,帮助开发者解决忘记打卡的问题。