

Python使用NLTK进行自然语言处理入门指南
本文详解Python中NLTK库的基础应用,涵盖环境配置、分句与分词操作。重点解析WordPunctTokenizer与regexp_tokenize的使用,并针对NLTK 3.1+版本中compile_regexp_to_noncapturing废弃导致的兼容性问题,提供修正后的正则分词代码方案,帮助开发者高效进行文本预处理。
2026-10-13
6

本文详解Python中NLTK库的基础应用,涵盖环境配置、分句与分词操作。重点解析WordPunctTokenizer与regexp_tokenize的使用,并针对NLTK 3.1+版本中compile_regexp_to_noncapturing废弃导致的兼容性问题,提供修正后的正则分词代码方案,帮助开发者高效进行文本预处理。
本文详解Python中正则表达式search()函数如何指定起始位置进行匹配。通过示例展示利用pos参数从指定字符索引开始搜索,跳过前置内容,实现精准定位匹配字符串的方法,适用于需要限定搜索范围的复杂文本处理场景。
本文详解Python中正则表达式的前向与后向搜索断言语法。通过实例演示如何使用(?=pattern)实现一致性匹配,如成对出现的尖括号。同时深入讲解前向否定模式(?!pattern)的应用,以过滤特定邮箱地址为例,展示如何在不消耗字符的前提下进行条件判断与排除。
本文介绍如何利用Python语言编写一个简单的网络爬虫,从段子网(ishuo.cn)批量抓取搞笑段子。通过解析URL规律并结合urllib与re模块,实现对段子内容的自动提取与本地存储,为聊天机器人或内容发布提供数据支持。
本文详解Python中正则表达式如何启用ASCII模式。针对Python3默认Unicode编码与Python2 ASCII编码的差异,介绍通过re.ASCII标志实现兼容旧代码的方法。结合代码示例对比ASCII与Unicode模式下\w+匹配非ASCII字符(如法语、波兰语、德语)的结果,帮助开发者理解字符集处理机制。
本文深入解析Python正则表达式模块中的compile函数,详解其语法结构及flags匹配标志的多种用法,包括忽略大小写、多行模式等。通过具体代码示例展示如何将正则字符串转换为高效的Pattern对象,帮助开发者掌握正则表达式的优化匹配技巧。
本文详细解析Python中正则表达式(Regex)在爬虫开发中的应用。通过介绍re模块的核心函数如findall、compile、match及search,结合抓取网页标题、超链接、表格内容及图片URL的具体代码示例,演示如何高效提取HTML数据。最后通过完整实例展示如何爬取个人博客的标题、图片及文章摘要,帮助初学者掌握基础网络数据抓取技巧。
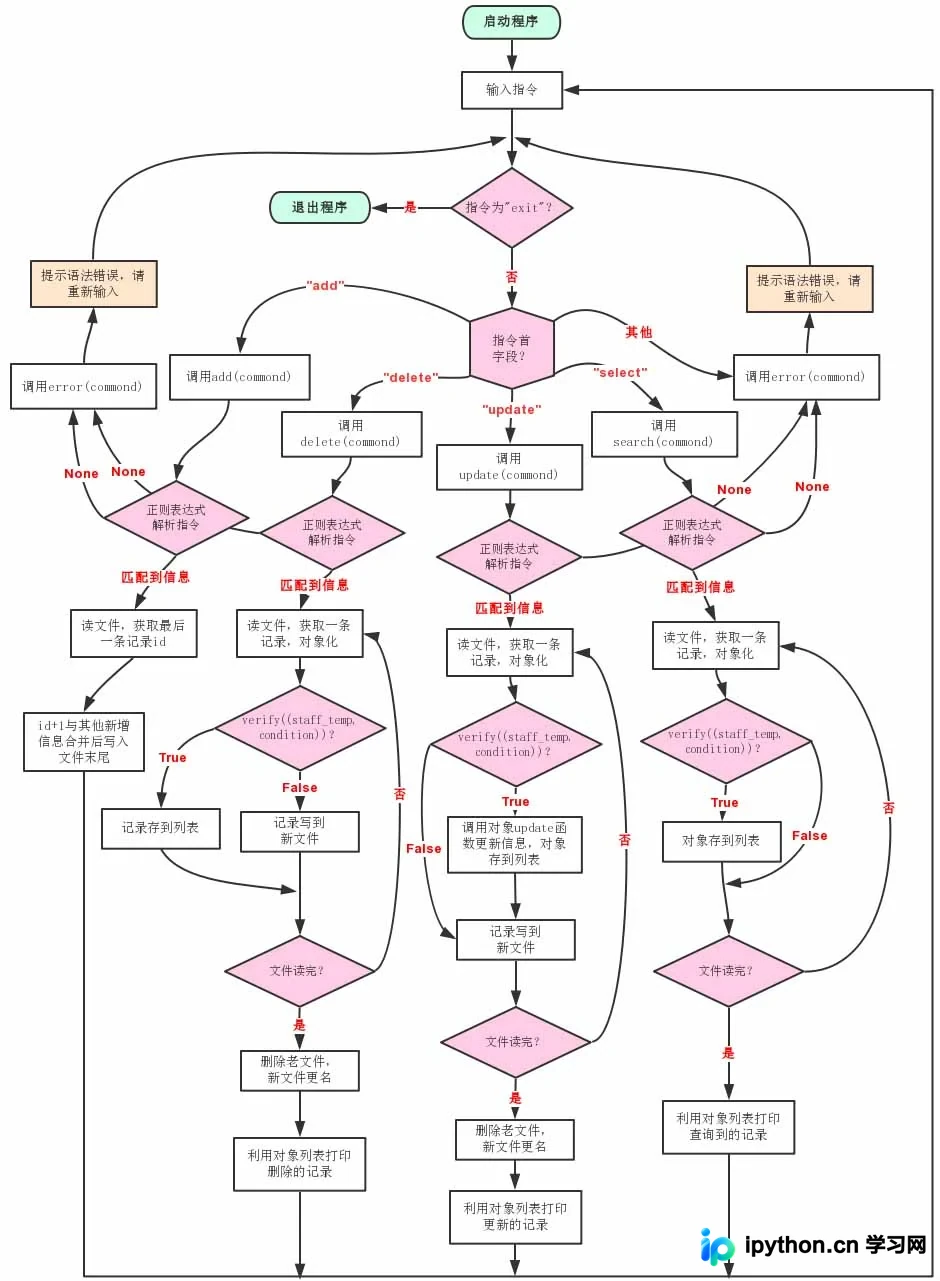
本文介绍一个基于Python编写的简易员工信息数据库模拟程序。通过正则表达式解析指令,利用面向对象方法封装员工数据,实现了增、删、改、查四大核心功能。程序支持逻辑运算符组合查询,演示了如何从文件读取数据并执行类似SQL的交互操作,适合初学者理解数据库底层逻辑与Python编程实践。
本文深入解析Python中正则表达式的组嵌套机制,通过具体代码实例展示如何构建复杂的正则模式。详细说明了利用嵌套组匹配多重字符序列的方法,并附带完整的测试代码及输出结果分析,帮助开发者掌握高级正则技巧。
本文介绍如何在Python中使用正则表达式提取包含“因为……所以”的文本,重点解决嵌套结构的查找问题。通过组嵌套技术构建复杂表达式,并展示具体的代码实现与输出格式,帮助开发者掌握正则表达式中分组嵌套的高级应用技巧。
本文详解Python中正则表达式模块re的findall()函数。通过对比search(),展示如何利用findall()查找并返回所有匹配字符串。结合具体代码示例,解析参数设置与输出结果,帮助开发者掌握批量提取文本信息的技巧。
本文详细介绍Python中正则表达式的fullmatch()函数,该函数用于实现字符串与模式的全匹配。通过对比search()和match()函数,展示fullmatch()的具体用法及示例,帮助读者理解全匹配的概念与应用场景。