

Python调用有道词典API实现命令行翻译工具
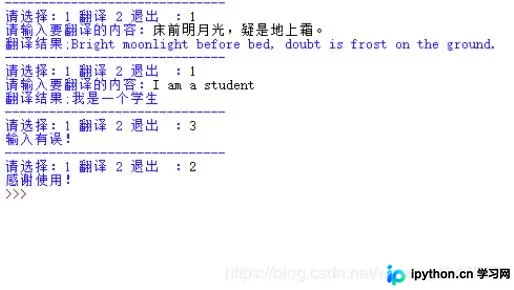
本文介绍如何使用Python编写一个简单的命令行在线翻译工具。通过调用有道翻译API接口,利用urllib库发送POST请求并解析JSON返回数据,实现中英文互译功能。代码包含完整的参数构造、签名生成及结果提取逻辑,适合Python初学者学习网络请求与数据处理。
2026-10-14
5

本文介绍如何使用Python编写一个简单的命令行在线翻译工具。通过调用有道翻译API接口,利用urllib库发送POST请求并解析JSON返回数据,实现中英文互译功能。代码包含完整的参数构造、签名生成及结果提取逻辑,适合Python初学者学习网络请求与数据处理。
本文详解如何使用Python的urllib库爬取网页,并结合BeautifulSoup解析HTML以提取所有URL链接。通过实例代码展示如何遍历a标签、处理相对路径及验证链接有效性,帮助开发者快速掌握网页数据抓取的核心技巧。
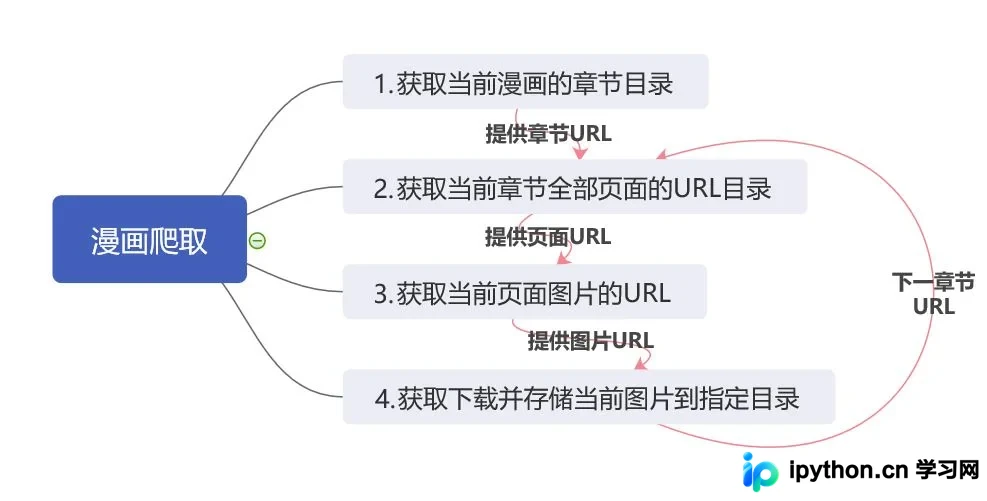
本文详细介绍使用Python 3开发ComicReaper漫画自动爬取脚本的全过程。通过解析HTML结构,利用re与urllib库提取章节标题与URL,并设置User-Agent和Referer请求头以模拟浏览器行为,实现从指定主页URL自动获取整本漫画章节目录的功能。
本文详解Python 2与Python 3中urllib库urlencode方法的模块路径差异,指出Py2使用urllib.urlencode而Py3需通过urllib.parse.urlencode调用。同时提供在Windows环境下使用Python 3运行PyCrypto时解决ImportError: No module named 'winrandom'错误的代码修改方案,确保数据提交与库依赖正常运作。
本文介绍了在Python 3.6环境中,利用标准库urllib实现HTTP GET和POST请求的具体方法。通过构建Request对象、设置Headers及处理数据编码,演示了如何向指定URL发送请求并获取响应内容,适用于需要模拟浏览器行为或接口调用的场景。
本文详细介绍如何使用Python的urllib和re模块抓取网页图片。通过获取HTML源码,利用正则表达式过滤图片URL,并实现本地保存功能。代码以百度贴吧为例,演示了从获取源码、解析链接到创建文件夹保存多张图片的完整流程,适合Python初学者参考学习。
本文详细记录了使用Python编写小说爬虫的全过程。文章从确定目标网址、分析页面结构入手,重点讲解了如何使用urllib.request获取网页内容,并通过设置Headers解决403 Forbidden错误。同时,针对常见的编码乱码问题,介绍了使用chardet库检测编码及手动指定GBK编码的方法,并结合socket.timeout处理网络超时异常,最终通过正则表达式提取章节内容并写入文件,提供了完整的代码实现参考。
本文详细演示如何使用Python3结合urllib和BeautifulSoup库抓取网页笑话内容。文章从基础HTML结构分析入手,讲解如何定位目标元素,并深入解决因User-Agent被拒导致的RemoteDisconnected错误。通过代码示例,展示了如何配置请求头伪装浏览器,从而成功获取捧腹网和糗百的笑话数据,适合Python初学者参考。
本文解答Python爬虫是否容易学习的问题,解析网络爬虫的基本概念与工作原理。详细介绍企业数据、购买渠道及公开数据等来源,阐述基于URL、HTML和HTTP协议的抓取流程,并提供使用urllib库获取视频链接的Python代码示例,帮助初学者掌握基础爬虫技能。
本文系统梳理Python爬虫的核心知识点,涵盖从Python基础语法、urllib/urllib2网络请求库,到正则表达式数据提取,再到Scrapy高级框架的完整学习路径。同时解析爬虫背后的HTTP请求、DNS解析及服务器响应机制,帮助初学者建立完整的爬虫知识体系。
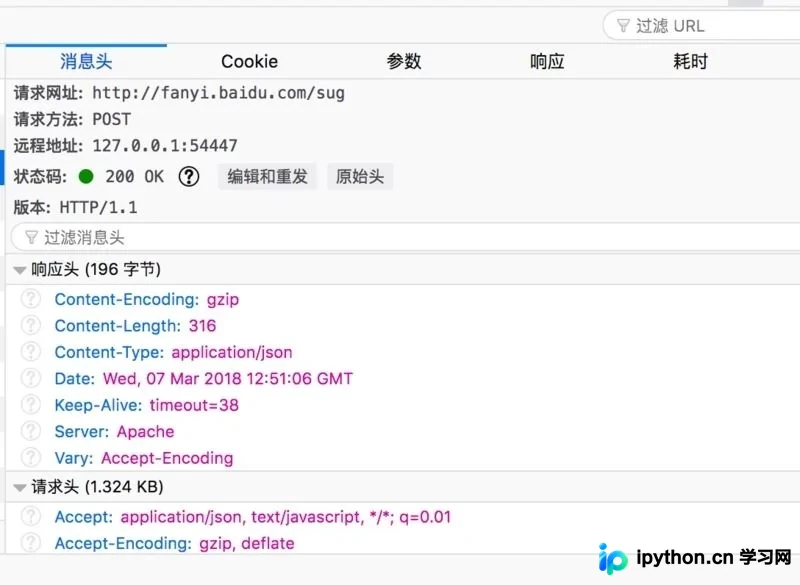
本文详解如何使用Python编写爬虫程序调用百度翻译接口。通过F12开发者工具分析网络请求,获取fanyi.baidu.com/sug接口及POST参数kw。结合urllib库构造请求头与数据,实现输入内容并输出翻译结果的核心功能,适合初学者快速上手网络爬虫开发。
本文深入解析Python内置库urllib.request,涵盖其核心模块功能及常用方法。通过读取内容、获取URL、状态码及HTTP头信息等案例,演示如何模拟浏览器发起HTTP请求,并展示文件保存与图片下载的完整代码实现,适合Python初学者快速掌握网络数据抓取基础。