Python 下载文件的几种方法汇总
本文汇总了 Python 中下载文件的多种实现方式,涵盖 requests、wget 及 urllib 等常用库。重点解析了处理重定向、大文件分块下载、多线程并行加速以及添加进度条等实用技巧,并提供了通过代理服务器下载国外资源的配置方案,帮助开发者高效完成文件获取任务。
2026-10-14
5

本文汇总了 Python 中下载文件的多种实现方式,涵盖 requests、wget 及 urllib 等常用库。重点解析了处理重定向、大文件分块下载、多线程并行加速以及添加进度条等实用技巧,并提供了通过代理服务器下载国外资源的配置方案,帮助开发者高效完成文件获取任务。
本文深入解析Python标准库urllib.request模块。详细讲解Request类的构造参数与数据编码,阐述Handler与Opener的协作机制。通过身份验证、代理配置及Cookie持久化(Mozilla与LWP格式)的完整代码示例,展示如何灵活构建HTTP请求处理器,适用于Python网络编程与爬虫开发场景。
本文介绍如何利用Python爬虫批量下载Excel中列出的500多个PDF文件。针对Python 3.5环境,修正了旧版代码语法,通过正则表达式匹配特定URL模式,实现自动抓取与保存。
本文详解Python爬虫中URL下载器的实现原理与用法。介绍如何从内置urllib迁移至功能强大的Requests库,通过HtmlDownloader类封装下载逻辑。重点讲解User-Agent伪装、状态码判断及编码处理等关键步骤,帮助开发者构建高效稳定的数据抓取模块。
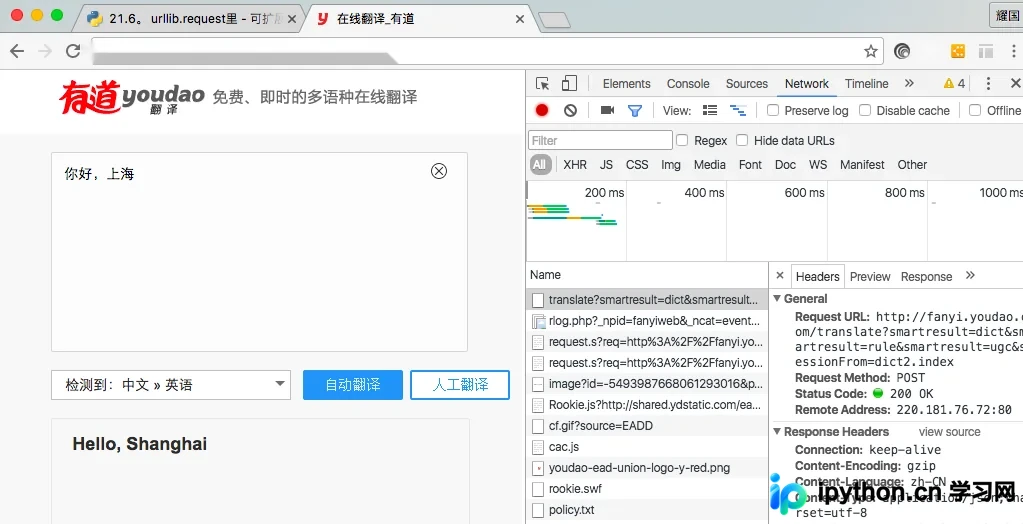
本文介绍如何使用Python的urllib库抓取有道翻译接口。重点讲解请求参数构造、URL中_o参数的影响及错误码50的解决方法,并通过添加请求头和JSON解析优化代码,实现可复用的中英互译功能。
本文详细解析Python中利用urllib库抓取网页时添加请求头(Headers)的两种常用方法。第一种通过build_opener结合addheaders实现,需注意headers需为元组类型;第二种通过创建Request实例对象,支持字典类型传入及add_header方法追加。文章对比了两种方式的参数格式差异与适用场景,帮助开发者避免类型错误并成功获取网页内容。
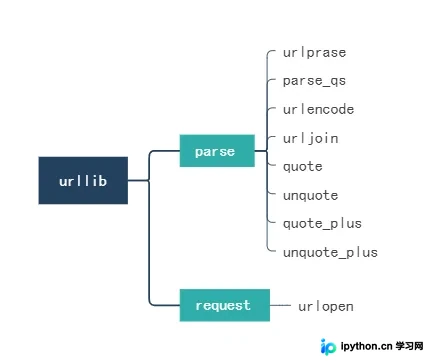
本文深入解析Python内置模块urllib,重点介绍urlparse、parse_qs、urlencode、quote及unquote等核心方法。通过实际代码示例,展示如何拆分URL、处理查询参数、进行字符编码与解码,帮助开发者高效处理网络请求中的URL操作。
本文详细解析Python在访问HTTPS链接时出现[SSL: CERTIFICATE_VERIFY_FAILED]错误的原因,即Python 2.7.9+默认开启证书校验。文章提供了五种临时解决方案,包括环境变量设置、全局禁用验证、创建未验证Context、requests库verify参数设为False以及手动指定CA证书,帮助开发者快速处理自签名证书或系统根证书异常导致的连接问题。
本文介绍如何在Python中使用urllib模块的urlretrieve函数直接下载远程图片。通过示例演示了如何指定本地保存路径、利用回调函数显示下载进度,以及处理POST数据。代码示例展示了抓取网页图片并保存至本地的完整流程,包含进度监控和文件管理逻辑。
本文详解Python网络爬虫基础,重点讲解urllib模块的用法,包括获取网页源码、解析响应对象及实现有道翻译接口调用。针对服务器反爬机制,介绍了User-Agent伪装、访问延迟及代理IP设置等规避风险的方法,最后通过煎蛋网案例演示如何批量下载网络图片。
本文详细解析Python3爬虫中携带Cookie的两种核心方法:直接写入Header头部和使用requests库的cookies参数。通过哈工大ACM站点的登录实战,演示如何利用urllib和cookiejar实现自动登录及后续页面访问,帮助开发者解决身份验证相关的爬虫需求。
本文详细介绍Python抓取指定网页图片的两种核心方法:基于正则表达式匹配URL与基于BeautifulSoup解析HTML标签。通过完整代码示例,演示如何获取网页源码、提取图片链接并保存至本地,同时提供优化建议,如结合两种方法提高抓取效率及添加请求头规避反爬机制。