

Python抓取网页图片实战:正则表达式与BeautifulSoup双方案解析

本文详细介绍Python抓取指定网页图片的两种核心方法:基于正则表达式匹配URL与基于BeautifulSoup解析HTML标签。通过完整代码示例,演示如何获取网页源码、提取图片链接并保存至本地,同时提供优化建议,如结合两种方法提高抓取效率及添加请求头规避反爬机制。
Python抓取网页图片的核心步骤
要从指定网页中爬取图片,主要需执行以下三个核心步骤:
第一步,确定目标网站链接并获取该页面的源代码。在Chrome浏览器中,可通过右键点击页面选择“检查”(Inspect),然后在Elements面板中查看HTML源码。
第二步,根据目标图片的特征编写正则表达式,以精准匹配需要抓取的内容。
第三步,建立循环逻辑,对匹配到的结果进行重复抓取并保存至本地。
下文将介绍两种实现抓取指定网页图片的具体方法。
方法一:利用正则表达式过滤抓取到的HTML字符串。
方法一:基于正则表达式的图片抓取
# 第一个简单的爬取图片的程序
import urllib.request # python自带的爬操作url的库
import re # 正则表达式


# 该方法传入url,返回url的html的源代码
def getHtmlCode(url):
  # 以下几行注释的代码在本程序中有加没加效果一样,但是为了隐藏自己避免被反爬虫可以假如这个伪装的头部请求
  headers = {
    'User-Agent': 'Mozilla/5.0(Linux; Android 6.0; Nexus 5 Build/MRA58N) \
    AppleWebKit/537.36(KHTML, like Gecko) Chrome/56.0.2924.87 Mobile Safari/537.36'
  }
  # 将headers头部添加到url,模拟浏览器访问
  url = urllib.request.Request(url, headers=headers)

  # 将url页面的源代码保存成字符串
  page = urllib.request.urlopen(url).read()
  # 字符串转码
  page = page.decode('UTF-8')
  return page


# 该方法传入html的源代码,通过截取其中的img标签,将图片保存到本机
def getImage(page):
  # [^\s]*? 表示最小匹配, 两个括号表示列表中有两个元组
  # imageList = re.findall(r'(https:[^\s]*?(png))"', page)
  imageList = re.findall(r'(https:[^\s]*?(jpg|png|gif))"', page)
  x = 0
  # 循环列表
  for imageUrl in imageList:
    try:
      print('正在下载: %s' % imageUrl[0])
      # 这个image文件夹需要先创建好才能看到结果
      image_save_path = './image/%d.png' % x
      # 下载图片并且保存到指定文件夹中
      urllib.request.urlretrieve(imageUrl[0], image_save_path)
      x = x + 1
    except:
      continue
  pass
if __name__ == '__main__':
  # 指定要爬取的网站
  url = "https://www.cnblogs.com/ttweixiao-IT-program/p/13324826.html"
  # 得到该网站的源代码
  page = getHtmlCode(url)
  # 爬取该网站的图片并且保存
  getImage(page)
  # print(page)
注意,代码中需要重点调整的部分是 `imageList = re.findall(r'(https:[^\s]*?(jpg|png|gif))"', page)` 这一行。正则表达式的具体设计需依据目标网页中图片的实际格式和结构而定。我的设计思路如下:
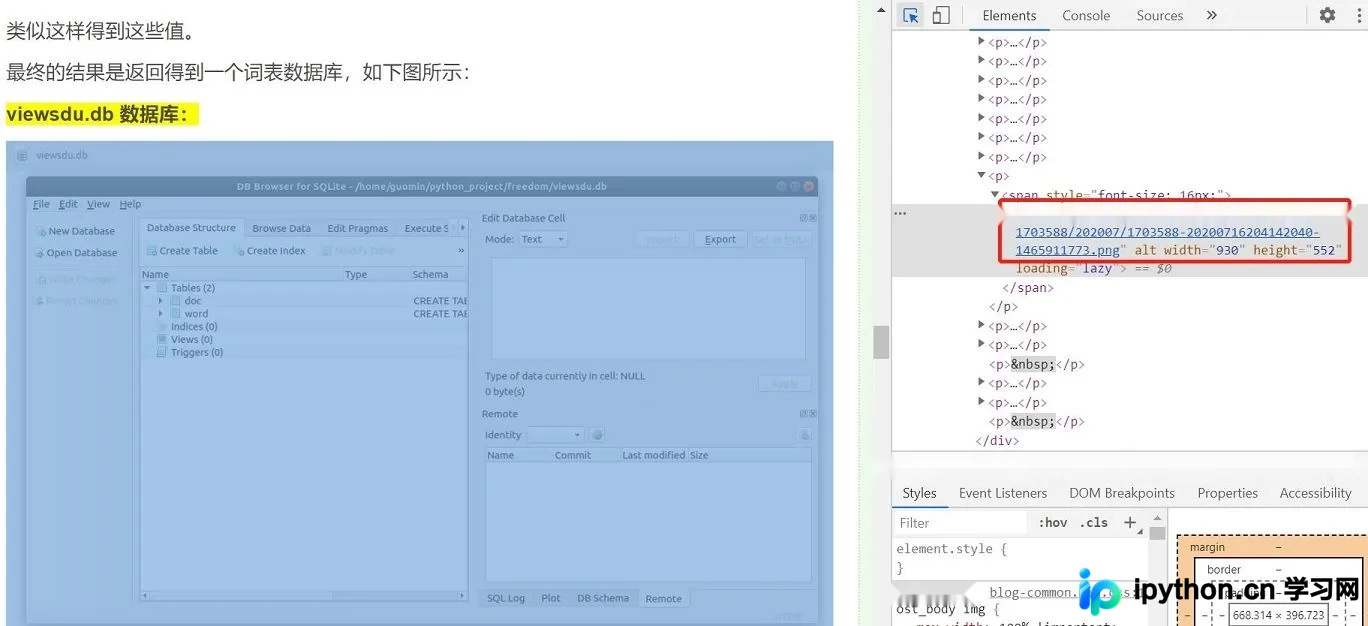
观察发现,若该网页上的图片均为png格式,则正则表达式可简化为 `imageList = re.findall(r'(https:[^\s]*?(png))"', page)`,同样能够成功抓取。
方法二:利用BeautifulSoup库解析HTML网页结构。
方法二:基于BeautifulSoup的HTML解析
from bs4 import BeautifulSoup # BeautifulSoup是python处理HTML/XML的函数库,是Python内置的网页分析工具
import urllib # python自带的爬操作url的库


# 该方法传入url,返回url的html的源代码
def getHtmlCode(url):
  # 以下几行注释的代码在本程序中有加没加效果一样,但是为了隐藏自己避免被反爬虫可以假如这个伪装的头部请求
  headers = {
    'User-Agent': 'Mozilla/5.0(Linux; Android 6.0; Nexus 5 Build/MRA58N) \
    AppleWebKit/537.36(KHTML, like Gecko) Chrome/56.0.2924.87 Mobile Safari/537.36'
  }
  # 将headers头部添加到url,模拟浏览器访问
  url = urllib.request.Request(url, headers=headers)

  # 将url页面的源代码保存成字符串
  page = urllib.request.urlopen(url).read()
  # 字符串转码
  page = page.decode('UTF-8')
  return page


# 该方法传入html的源代码,通过截取其中的img标签,将图片保存到本机
def getImage(page):
  # 按照html格式解析页面
  soup = BeautifulSoup(page, 'html.parser')
  # 格式化输出DOM树的内容
  print(soup.prettify())
  # 返回所有包含img标签的列表,因为在Html文件中图片的插入呈现形式是<img src="..." alt=".." />
  imgList = soup.find_all('img')
  x = 0
  # 循环找到的图片列表,注意,这里手动设置从第2张图片开始,是因为我debug看到了第一张图片不是我想要的图片
  for imgUrl in imgList[1:]:
    print('正在下载: %s ' % imgUrl.get('src'))
    # 得到scr的内容,这里返回的就是Url字符串链接,如'https://img2020.cnblogs.com/blog/1703588/202007/1703588-20200716203143042-623499171.png'
    image_url = imgUrl.get('src')
    # 这个image文件夹需要先创建好才能看到结果
    image_save_path = './image/%d.png' % x
    # 下载图片并且保存到指定文件夹中
    urllib.request.urlretrieve(image_url, image_save_path)
    x = x + 1
if __name__ == '__main__':
  # 指定要爬取的网站
  url = 'https://www.cnblogs.com/ttweixiao-IT-program/p/13324826.html'
  # 得到该网站的源代码
  page = getHtmlCode(url)
  # 爬取该网站的图片并且保存
  getImage(page)
这两种方法各有优劣。建议在实际应用中灵活结合:例如,先使用方法二中指定标签的方式缩小搜索范围,再使用正则表达式进行精确匹配,这样可使代码逻辑更加简洁清晰。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









