Python3发送Post请求时参数为空的实现与影响
本文探讨Python3中发送Post请求且不带参数的场景。当Post请求参数为空时,其效果等同于Get请求,部分开发团队在接口测试中利用此特性统一使用Post方法。文章通过Python代码示例展示了如何处理空参Post请求,并解析了相关实现逻辑,为接口测试提供参考。
2026-10-13
6

本文探讨Python3中发送Post请求且不带参数的场景。当Post请求参数为空时,其效果等同于Get请求,部分开发团队在接口测试中利用此特性统一使用Post方法。文章通过Python代码示例展示了如何处理空参Post请求,并解析了相关实现逻辑,为接口测试提供参考。
本文详解Python爬虫中如何使用代理IP防止IP被封。通过urllib.request的ProxyHandler构建自定义opener,并调用install_opener设置全局代理,使urlopen默认使用代理IP。文中涵盖HTTP/HTTPS代理设置、端口配置及常见连接拒绝错误的排查方法,帮助开发者实现稳定的数据抓取。
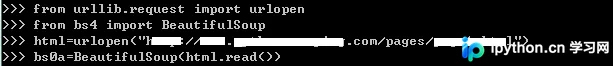
本文详细介绍如何使用Python构建基础爬虫架构。通过解析urllib库的网络请求功能与BeautifulSoup的HTML解析能力,演示从导入模块、打开网址到提取节点信息的完整流程。同时涵盖常见错误如HTTPError和None值的排查与处理,帮助开发者掌握基础爬虫的核心步骤与异常处理机制。
本文详细解析JSON字符串与Python原生字符串在处理数据时的核心差异,重点介绍json库如何将JSON字符串转换为Python字典以支持get方法。通过IP地理位置查询和文件下载两个实战案例,演示urllib库的urlopen与urlretrieve用法,帮助开发者更高效地处理API返回的JSON数据及网络资源。
本文介绍如何在 Python 3.6 环境中利用 urllib 库完成网络资源下载。通过示例展示了如何使用 quote 函数对包含特殊字符的 URL 进行编码,确保请求合法性,并调用 urlopen 获取响应数据。该实例适用于需要处理复杂 URL 参数的下载场景,帮助开发者掌握基础的 HTTP 请求与数据处理流程。
本文介绍在Python3中如何利用urllib请求网页数据,并结合BeautifulSoup库解析HTML内容。通过具体代码示例,演示如何获取标题、类名、ID等属性值,以及使用select方法按标签、类名或ID进行精准查找,为网页数据抓取提供实用参考。
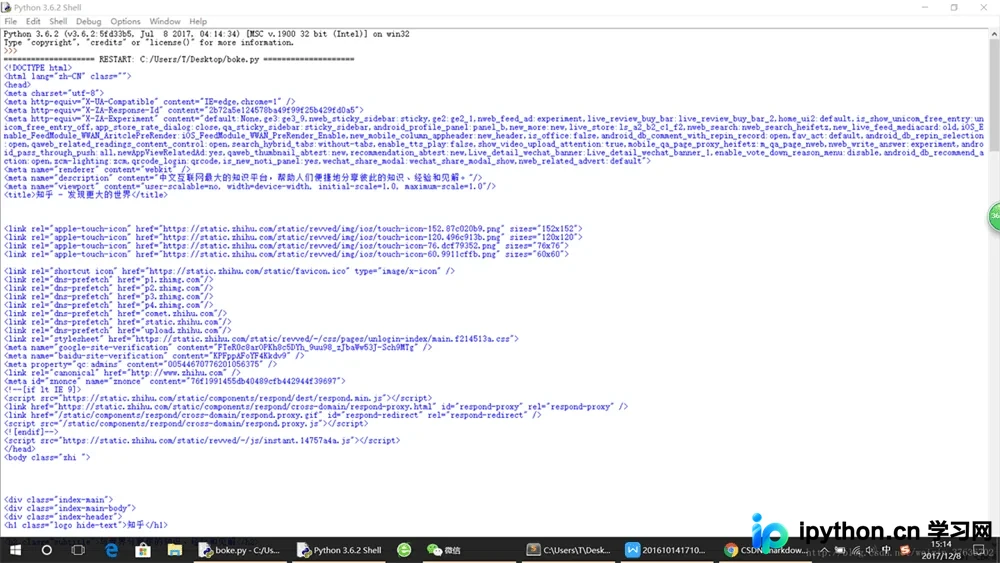
本文针对Python3环境提供爬虫入门指南,对比Python2差异,推荐边学边做。通过抓取知乎首页源码演示urllib.request.urlopen()用法,解析HTML并处理编码,介绍爬虫流程及数据提取存储方法,帮助初学者快速上手。
本文详解Python 2与Python 3中urllib库urlencode方法的模块路径差异,指出Py2使用urllib.urlencode而Py3需通过urllib.parse.urlencode调用。同时提供在Windows环境下使用Python 3运行PyCrypto时解决ImportError: No module named 'winrandom'错误的代码修改方案,确保数据提交与库依赖正常运作。
本文介绍在Python3环境下使用urllib库时,处理URL中包含中文字符导致的编码错误及返回结果乱码问题。通过urllib.parse.quote对中文进行编码,并使用decode('utf-8')对响应内容进行解码,从而正确获取数据。
本文介绍使用Python编写爬虫程序调用有道翻译接口的完整示例。通过构造HTTP请求、设置请求头及参数,实现文本翻译功能。代码包含用户交互循环及JSON结果解析,适用于学习网络请求与数据处理的基础场景。
本文介绍使用Python编写爬虫程序,自动抓取煎蛋网(jandan.net)上的图片并保存至本地文件夹。通过解析网页HTML获取图片链接,利用urllib库发起请求并下载图片文件,支持指定页数批量处理。代码包含页面解析、图片地址提取及文件保存逻辑,适合Python初学者学习网络爬虫基础操作。
本文介绍如何使用Python的urllib库下载网页源码并保存为本地HTML文件。通过示例代码展示如何获取指定URL的网页内容,并将其以二进制模式写入本地文件。该方法适用于提取纯文本内容,但需注意本地保存的文件不包含外部引用的图片等资源。