Python实现校园网自动重连脚本教程
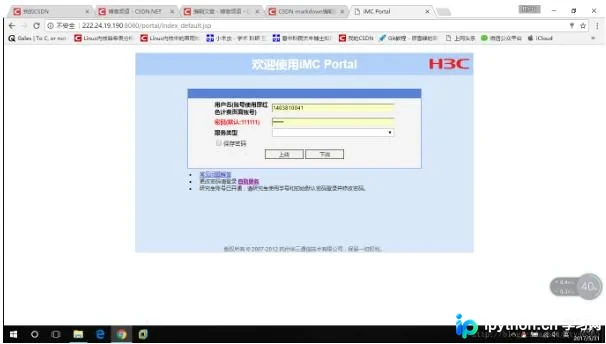
本文介绍如何利用Python爬虫技术解决校园网频繁掉线问题。通过Firefox浏览器抓包获取登录接口、参数及Header信息,结合requests库编写自动登录脚本。脚本包含死循环检测网络状态,断网时自动重新提交POST请求,并可打包为exe实现开机自启,无需手动操作。
2026-10-13
6

本文介绍如何利用Python爬虫技术解决校园网频繁掉线问题。通过Firefox浏览器抓包获取登录接口、参数及Header信息,结合requests库编写自动登录脚本。脚本包含死循环检测网络状态,断网时自动重新提交POST请求,并可打包为exe实现开机自启,无需手动操作。
本文详细介绍在Python爬虫开发中应对反爬机制的代理IP设置方法。通过安装requests、bs4和lxml库,构建从免费代理网站抓取IP并随机选取的完整流程。代码演示如何利用random模块生成符合requests格式的代理字典,有效规避真实IP被封风险,提升爬虫稳定性。
本文介绍使用Python抓取多页天涯论坛帖子的实战技巧。重点解析BeautifulSoup中find_all与select的选择器差异,演示如何利用zip函数合并作者与内容数据,并构建双层URL结构实现分页抓取,同时探讨多属性筛选的可行性。
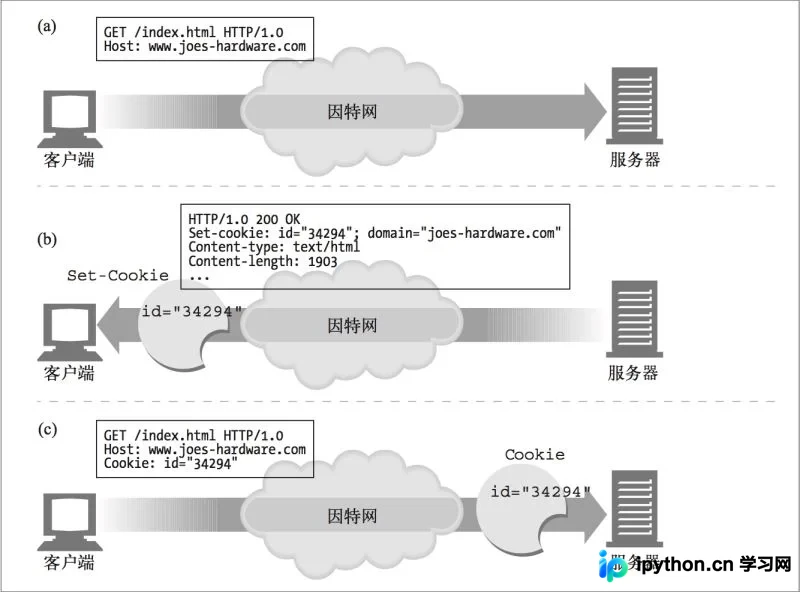
本文详解Python爬虫中GET与POST请求的区别及适用场景,重点解析Cookie在维持会话状态中的作用。通过163邮箱实例,演示如何利用Requests库发送请求,并解决SSL证书过期导致的SSLError问题,提供verify=False的解决方案及完整代码示例。
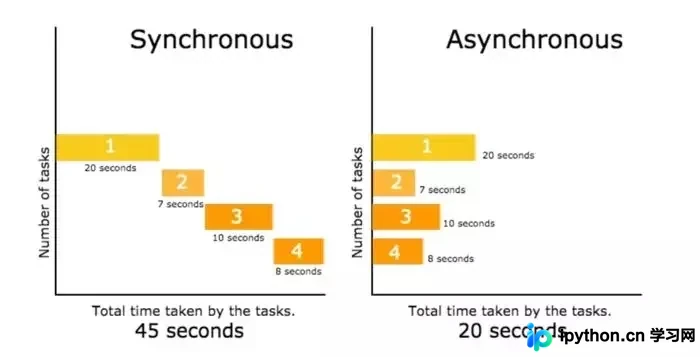
本文详解Python爬虫中同步与异步的区别,对比requests与aiohttp库的使用。重点介绍gevent库通过Greenlet实现轻量级协程的原理,以及利用猴子补丁将阻塞式requests转换为异步的方法。包含有道词典爬取实战、高并发下的限流策略及列表分批处理代码示例,帮助开发者提升爬虫效率。
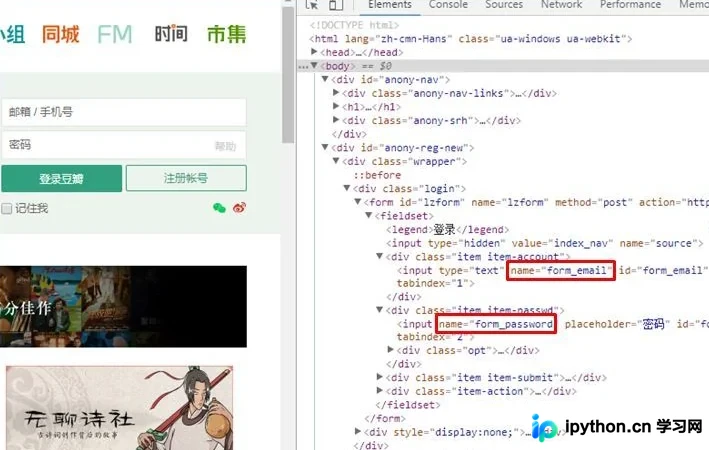
本文详解Python3爬虫模拟登录的核心技术。通过前端审查元素定位加密逻辑,介绍Base64、手动模拟及PyExecJS调用JS三种加密还原方案。针对图片验证码,探讨本地存储与第三方识别模块的应用。最后演示如何构造Headers、处理Session/Cookie并发送POST/GET请求,实现完整登录流程。
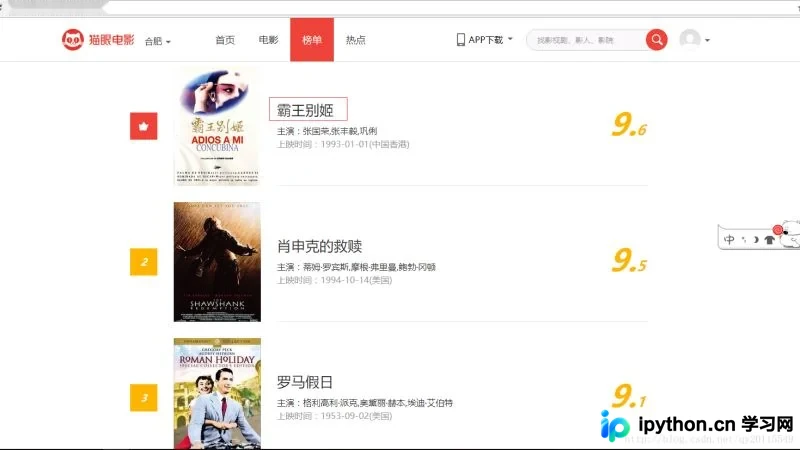
本文详细介绍如何使用Python的requests模块发起HTTP请求获取HTML源码,并结合BeautifulSoup库解析网页结构。通过抓取猫眼电影Top100榜单的具体案例,演示安装依赖、构造请求及提取电影标题与链接的完整流程,提供可直接运行的代码示例。
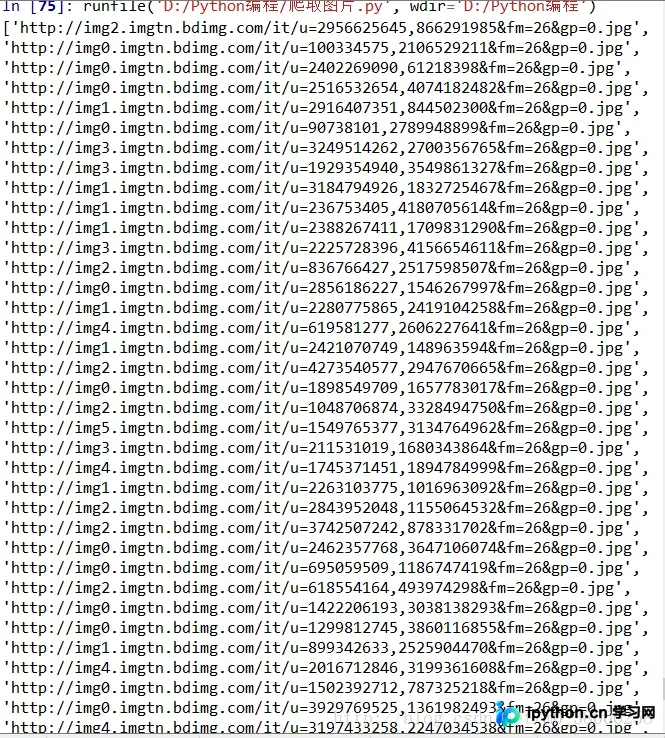
本文介绍如何使用Python标准库urllib获取网页源代码,并结合正则表达式提取页面中的图片链接。通过定义匹配thumbURL的正则模式,批量获取指定搜索页面的图片地址,适用于基础爬虫开发学习。
本文深入解析Python urllib库的高级用法,重点讲解如何利用Request方法构建Headers模拟浏览器进行POST数据提交,并详细剖析通过ProxyHandler定制Opener以配置代理IP解决反爬限制的技巧。内容涵盖参数解析、编码规则及异常处理,助力提升爬虫效率与稳定性。
本文提供基于Python的股票信息爬取示例,涵盖基础抓取逻辑及加入进度条优化的完整代码。通过requests和BeautifulSoup解析网页,提取股票列表及详细信息并保存至文件。示例展示了如何处理编码、异常捕获及实时进度反馈,供开发者参考学习网络数据采集技巧。
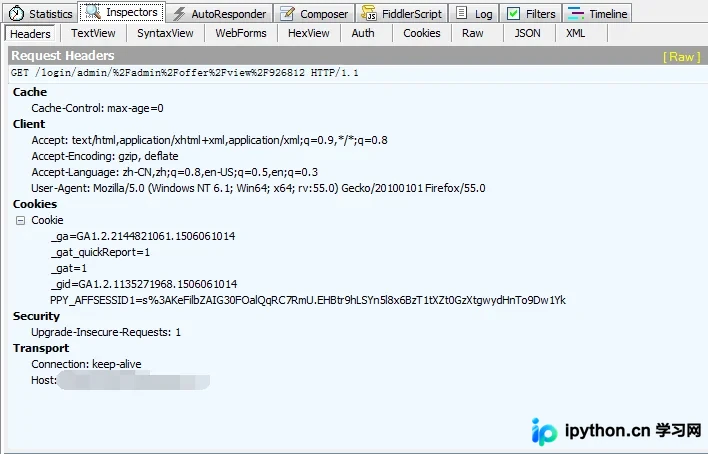
本文详解Python爬虫中如何利用Urllib库保存和复用Cookie实现网站自动登录。通过解析urlopen参数、构造Request对象及设置Headers,结合POST/GET请求示例,展示从抓包分析到代码实现的完整流程,帮助开发者突破登录限制。
本文深入解析Python爬虫中Cookie与Session的核心机制。详细阐述Cookie作为客户端存储的身份标识,涵盖Version0与Version1的属性差异及过期策略;解析Session如何通过唯一ID减少数据传输并保障服务器性能。对比两者在安全性、存储位置及适用场景上的区别,帮助开发者优化爬虫策略与Web交互逻辑。