

Python使用urllib和正则表达式提取网页图片链接

发布时间:2026-10-13| 1人浏览过
本文介绍如何使用Python标准库urllib获取网页源代码,并结合正则表达式提取页面中的图片链接。通过定义匹配thumbURL的正则模式,批量获取指定搜索页面的图片地址,适用于基础爬虫开发学习。
本示例旨在演示如何从指定网页中提取图片链接,具体实现步骤如下。
首先,需要获取目标网页的源代码内容:
import urllib.request
def getHtml(url):
  html=urllib.request.urlopen(url).read()
  return html
print(getHtml(http://image.baidu.com/search/flip?tn=baiduimage&ie=utf-8&word=%E5%A3%81%E7%BA%B8&ct=201326592&lm=-1&v=flip))
接着,利用正则表达式对获取到的网页源码进行解析,以提取其中的图片地址:
import re
import urllib.request
def getHtml(url):
  html=urllib.request.urlopen(url).read()
  return html
def getImg(html):
  r=r'"thumbURL":"(http://img.+?\.jpg)"' #定义正则
  imglist=re.findall(r,html)
  return imglist
html=str(getHtml("http://image.baidu.com/search/flip?tn=baiduimage&ie=utf-8&word=%E5%A3%81%E7%BA%B8&ct=201326592&lm=-1&v=flip"))
print(getImg(html))
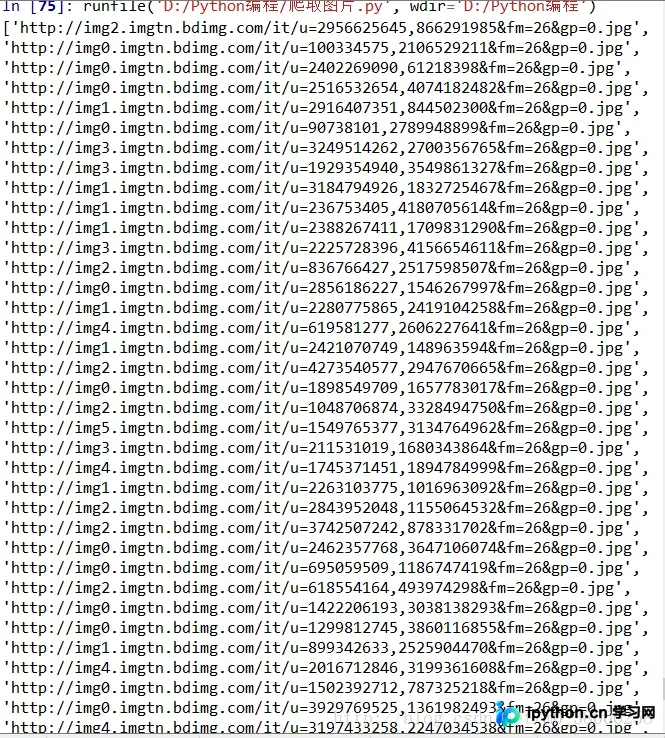
执行上述代码后的运行结果如下:
总结
以上即为Python爬虫技术中通过代码提取网页图片地址的完整实现过程,希望能为读者提供实际帮助。若需了解更多相关技术专题,欢迎继续查阅本站内容。如有任何疏漏或疑问,欢迎在评论区留言指正,感谢大家的支持。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









