

Python递归下载网站文件夹及文件完整指南
本文介绍如何使用Python的requests库递归下载网站根目录下的所有文件及文件夹。针对PHP下载限制,通过二级域名站实现自动化备份。代码包含判断链接类型、自动创建文件夹及递归处理逻辑,帮助开发者快速还原网站本地结构。
2026-10-14
5

本文介绍如何使用Python的requests库递归下载网站根目录下的所有文件及文件夹。针对PHP下载限制,通过二级域名站实现自动化备份。代码包含判断链接类型、自动创建文件夹及递归处理逻辑,帮助开发者快速还原网站本地结构。
本文介绍在Python3中使用requests库时,若headers参数需包含中文如何解决。通过urllib.parse.quote()对中文进行编码,确保请求正常发送。
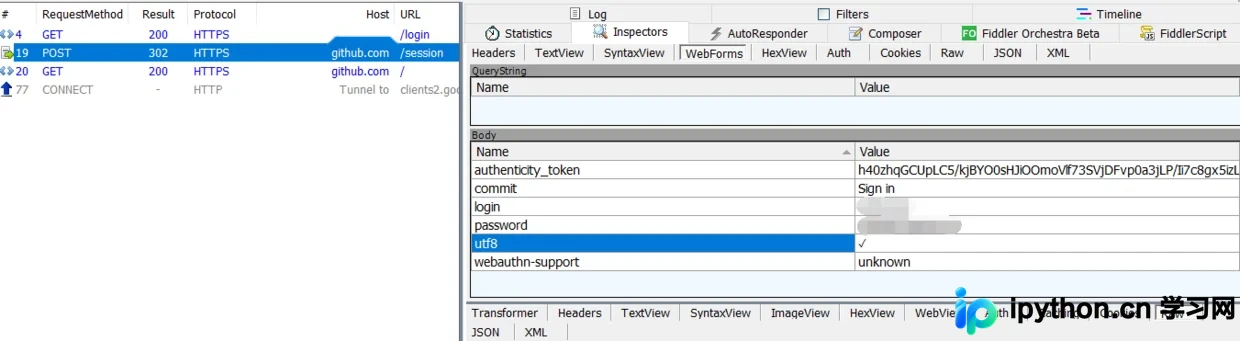
本文详细讲解如何使用Python结合Fiddler抓包工具模拟GitHub登录。通过抓取HTTP请求分析登录流程,提取关键参数authenticity_token,并利用requests库构建Session会话完成POST表单提交。文中包含处理SSL证书警告、正则提取Token及通过页面标题判断登录状态的具体代码实现,适合希望学习网络爬虫基础与接口模拟的开发者参考。
本文介绍在Python中利用requests库处理HTTP 302重定向以获取文件真实链接的两种方案。通过设置allow_redirects参数控制head请求行为,或直接使用get方法自动跟随重定向,从而准确获取最终URL及响应头信息。
本文介绍如何使用Python的requests模块模拟HTTP请求获取Ajax接口数据,并结合内置json模块进行结构化解析。通过高德地图POI查询示例,演示从获取原始文本到提取嵌套字典中具体字段(如名称、地址、经纬度)的完整流程,为处理大量结构化数据提供基础模板。
本文介绍如何使用Python3和requests模块抓取B站视频的历史弹幕数据。通过Chrome开发者工具分析网络请求,定位rolldate和dmroll接口,获取弹幕ID及时间戳。利用正则表达式解析返回的XML数据,按日期保存弹幕内容至本地文件,为后续词云或情感分析提供数据支持。
本文系统讲解Python网络爬虫的核心技术与Requests库的实战应用。内容涵盖Requests库的安装配置、核心方法解析(get/post等)、Response对象属性及异常处理机制。深入剖析HTTP协议、URL结构及PATCH与PUT的区别,并结合京东、亚马逊商品爬取、搜索引擎关键词提交、图片存储及IP查询等具体案例,展示网络爬虫的实际操作流程与注意事项。
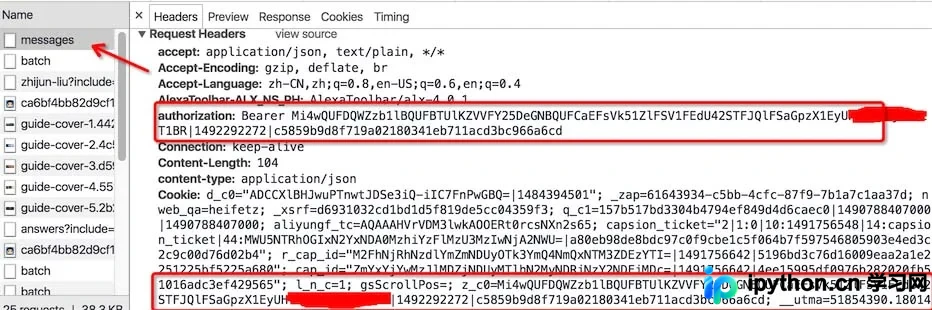
本文基于Python的requests库,详细解析如何构建知乎私信发送API。通过抓包分析HTTP请求头、URL及JSON请求体,获取用户ID与认证信息,实现登录状态下的私信发送功能。教程涵盖从网络请求追踪到代码实现的完整流程,提供获取用户信息、构造请求及调用API的关键代码示例,帮助开发者掌握利用requests模拟浏览器操作的核心技巧。
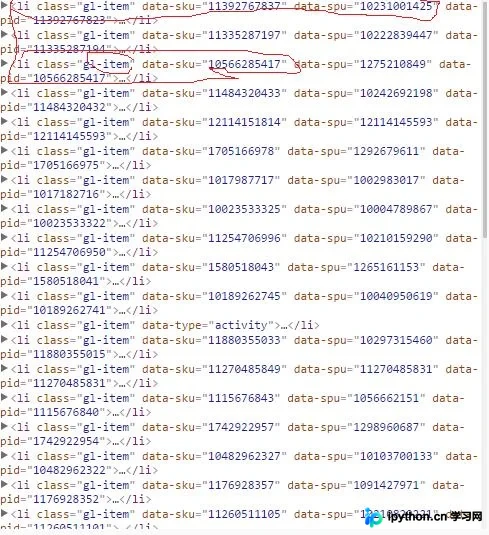
本文详解如何利用Python爬取京东商城商品数据。通过分析Ajax异步加载机制,结合Requests获取HTML源码,使用BeautifulSoup解析DOM结构提取data-pid及图片URL。教程涵盖简化请求URL、处理懒加载图片属性、多线程加速抓取及MySQL/MongoDB存储方案,提供完整代码逻辑与优化建议。
本文介绍如何使用Python脚本结合freeapi.ipip.net和ip-api.com两个免费接口,实现IP地址归属地的批量查询。通过命令行参数传入IP,程序自动解析并输出国家、省份、城市、运营商等详细信息,适合网络管理者和开发者快速部署本地IP查询工具。
本文详细介绍使用Python爬虫批量获取动漫网站截图的完整流程。通过requests发送请求,利用正则表达式解析HTML提取图片链接与标题,结合os库管理文件存储,并引入time模块控制爬取频率以遵守网站规范。文章提供完整代码示例及分页处理技巧,帮助初学者快速掌握图片抓取实战技能。
本文详细讲解Python中requests库的多种实用技巧。内容涵盖库的安装、GET与POST请求的参数及头部设置、代理IP的配置方法,以及通过获取Cookie和使用Session对象实现自动登录和状态保持。适合希望提升爬虫效率与稳定性的开发者参考。