

Pandas DataFrame中Tuple元素的高效遍历与处理技巧
本文介绍在Python Pandas中处理包含Tuple元素的DataFrame的高效方法。针对Word2vec输出的相似度数据,通过applymap结合lambda函数提取元组首个元素,并利用reset_index和rename重构数据结构,实现从索引提取关键词及过滤相似度值,提供比常规循环更优的性能方案。
2026-10-13
13

本文介绍在Python Pandas中处理包含Tuple元素的DataFrame的高效方法。针对Word2vec输出的相似度数据,通过applymap结合lambda函数提取元组首个元素,并利用reset_index和rename重构数据结构,实现从索引提取关键词及过滤相似度值,提供比常规循环更优的性能方案。
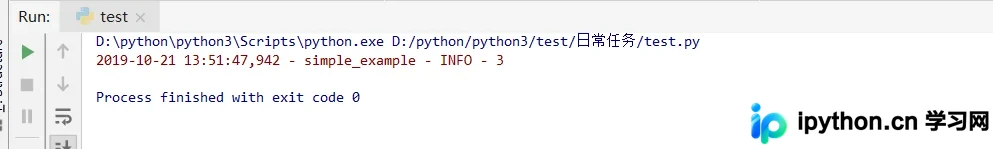
本文详解Python内置logging模块的使用。涵盖日志定义、五大级别(DEBUG至CRITICAL)及默认WARNING过滤机制。通过基础控制台输出示例与高级配置代码,展示如何自定义日志格式、处理器及文件记录,帮助开发者高效实现程序日志管理。
本文详解如何利用Python的browsercookie模块自动从Chrome、Firefox等主流浏览器中提取已保存的Cookie,解决爬虫登录验证难题。通过安装配置、代码示例及requests库结合使用,实现无需手动输入账号密码即可访问需登录状态的网页内容,提升数据采集效率。
本文深入解析Python中traceback模块的核心用法,涵盖如何捕获并打印异常信息、将错误日志写入文件以及使用extract_tb函数格式化跟踪结果。通过具体代码示例,展示在除零等常见错误场景下,结合try-except语句进行有效异常处理的最佳实践,帮助开发者快速定位代码问题。
本文详细讲解Python中文件读写的基础操作,涵盖文本文件与二进制文件的打开模式。重点介绍如何读取int16型波形数据,通过解析两个字节转换为整型。同时提供使用with语句管理文件资源、处理非UTF-8编码(如GBK)以及读写二进制文件的代码实例,帮助开发者掌握基础文件处理技能。
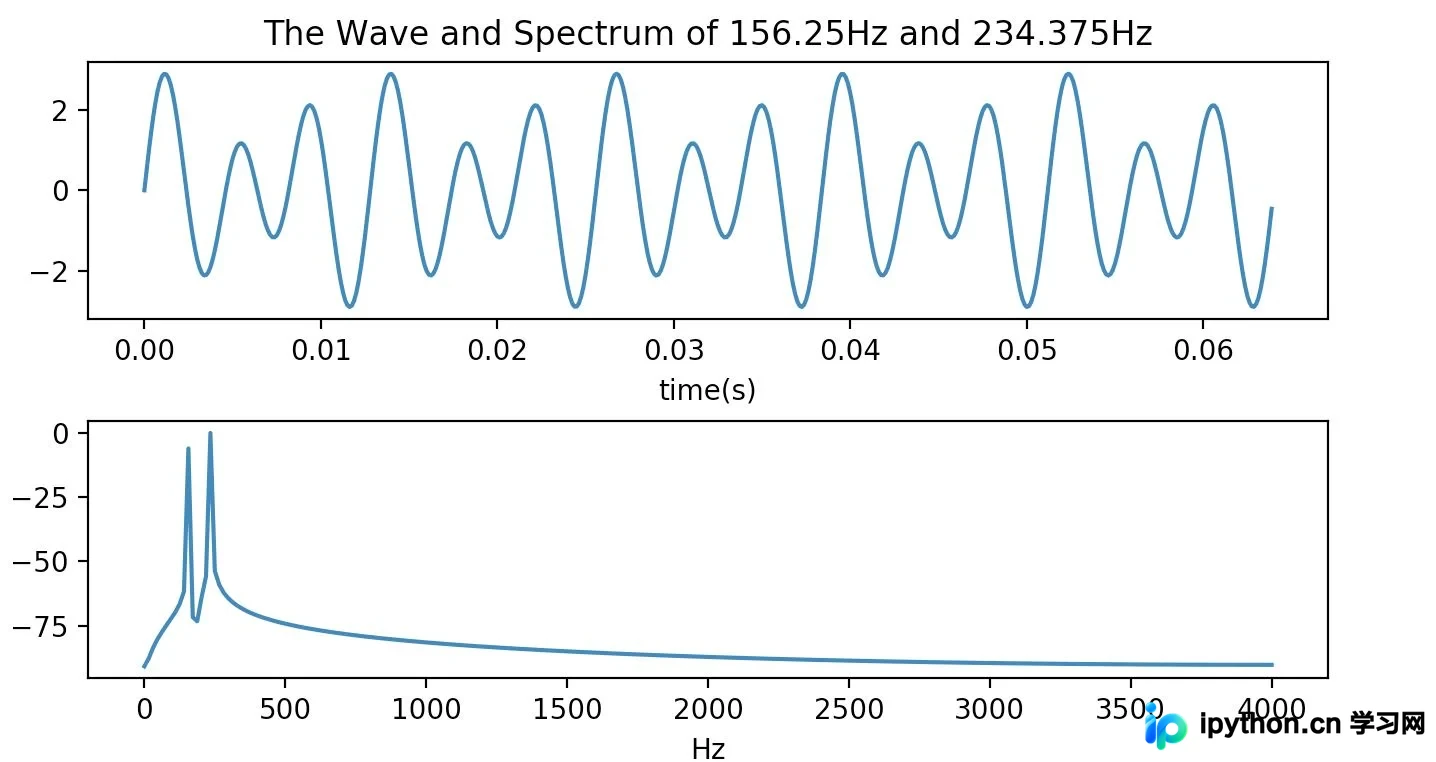
本文解析使用Python进行FFT快速傅里叶变换的实现过程。重点讲解N点FFT对采样时间的要求,即需包含整数个波形周期以确保频谱分析精确。通过8000Hz采样率、512点FFT长度,生成156.25Hz和234.375Hz信号进行示例,展示时域波形与频域频谱的转换及绘图代码。
本文介绍如何使用Python对比两个PostgreSQL数据库。通过执行SQL查询获取各表大小,并利用Python字典进行逐项比较,识别出两个数据库中表大小的差异。文章提供了基于psycopg2库的连接示例及核心比较逻辑,帮助开发者快速定位数据库间的结构或数据规模不一致问题。
本文详解Python多进程操作,通过两个实战案例展示进程池的应用。首先演示如何批量复制文件并优化进度显示,利用进程池提高执行效率;其次介绍基于多进程与多线程结合的聊天服务器实现方案,涵盖Socket通信、进程创建及消息收发逻辑,帮助开发者掌握高并发场景下的Python编程技巧。
本文详细解析Python中@property装饰器及property函数的常见用法。通过基本属性访问、setter/deleter定义、实际价格计算示例以及私有属性封装等场景,展示如何实现类属性的智能读写控制。内容涵盖代码实现与运行结果,帮助开发者深入理解Python属性机制。
本文分析Python中尝试直接修改字符串字符导致的TypeError错误。由于字符串是不可变类型,无法通过索引赋值,需先将字符串转换为列表进行元素替换,再转换回字符串。文章提供错误复现代码、报错信息及正确的list()转换方案,帮助开发者理解Python数据类型特性并解决此类常见问题。
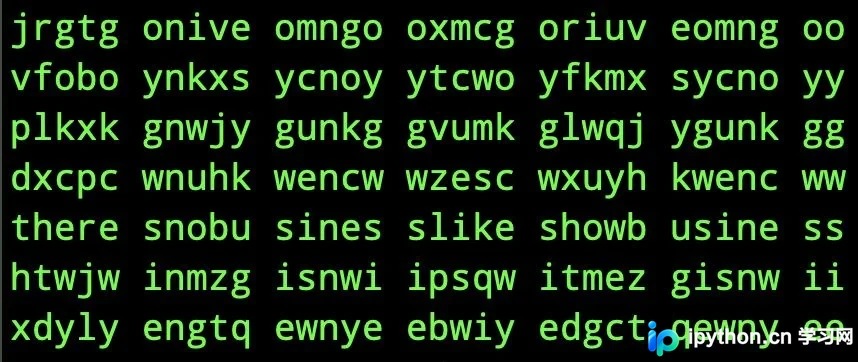
本文详解仿射密码的加解密原理,重点解析Python实现过程。通过定义求逆元函数NI,遍历密钥a和b的所有合法组合,批量生成潜在明文。最终结合语言学常识筛选出正确结果,完整展示从密文“DBUHU SPANO SMPUS STMIU SBAKN OSMPU SS”到明文“theres no business like show business”的解密流程。
本文介绍在Python应用中处理第三方模块调用超时时的重试策略。对比信号量、多线程及eventlet结合retrying模块的优缺点,重点展示如何利用eventlet的超时机制与retrying库实现指定次数和时间的自动重试,避免线程管理混乱,适用于大量数据重复操作的场景。